同一个请求,三次结果:面向客户的智能体为何要用 pass^k 验收
面向客户的智能体常按平均任务成功率验收,但每位真实客户只经历一次对话。当同一请求必须在连续多次重试中全部成功(pass^k),且用户表现出急躁、怀疑或情绪波动时,成功率会显著下滑;上线验收必须转向多轮一致性测试、写操作策略校验、沙箱预演与争议工单人工接管。

均值掩盖的现场风险:当同一位客户在重试中拿到不同结果
在零售售后、航司退改或机构行政接待中,越来越多企业将工具调用智能体推向生产一线。上线前,团队通常依据测试集上的平均任务成功率放行;然而设想进入真实客流后,同一位客户提出完全相同的退改或权益核对请求,初次对话可能因反复追问而中断,再次重试时系统只修改了部分订单,再试一次甚至可能在未获明确确认时直接改写后台状态。这类不一致一旦进入生产,事后排查与人工兜底的负担就可能抵消自动化原本承诺的效率收益。
症结在于用总体均值替代单次交付质量。每位客户只经历一次对话,当同一请求必须在连续多次运行中全部成功并遵守规则,即按 pass^k 验收时,成功率会显著下跌;若用户表现出急躁、怀疑或焦虑,稳定性还会进一步恶化。最新实证研究表明,绝大多数失败并非因为缺少共情,而是源于意图误读、调用顺序错误、参数错误、漏执行等执行故障与策略违规。我们认为,面向客户的智能体必须采用多轮重复试验与写前策略校验作为验收标准,将退款与调账限制在沙箱预演,并在发生争议时转交具名人工坐席接管。
从单次通关到全轮一致:pass^k、用户特质漂移与情绪交互脆弱性
近年关于工具—智能体—用户交互的研究,从统计一致性、用户行为特质与情绪抗扰度拆解了这一失效机制。
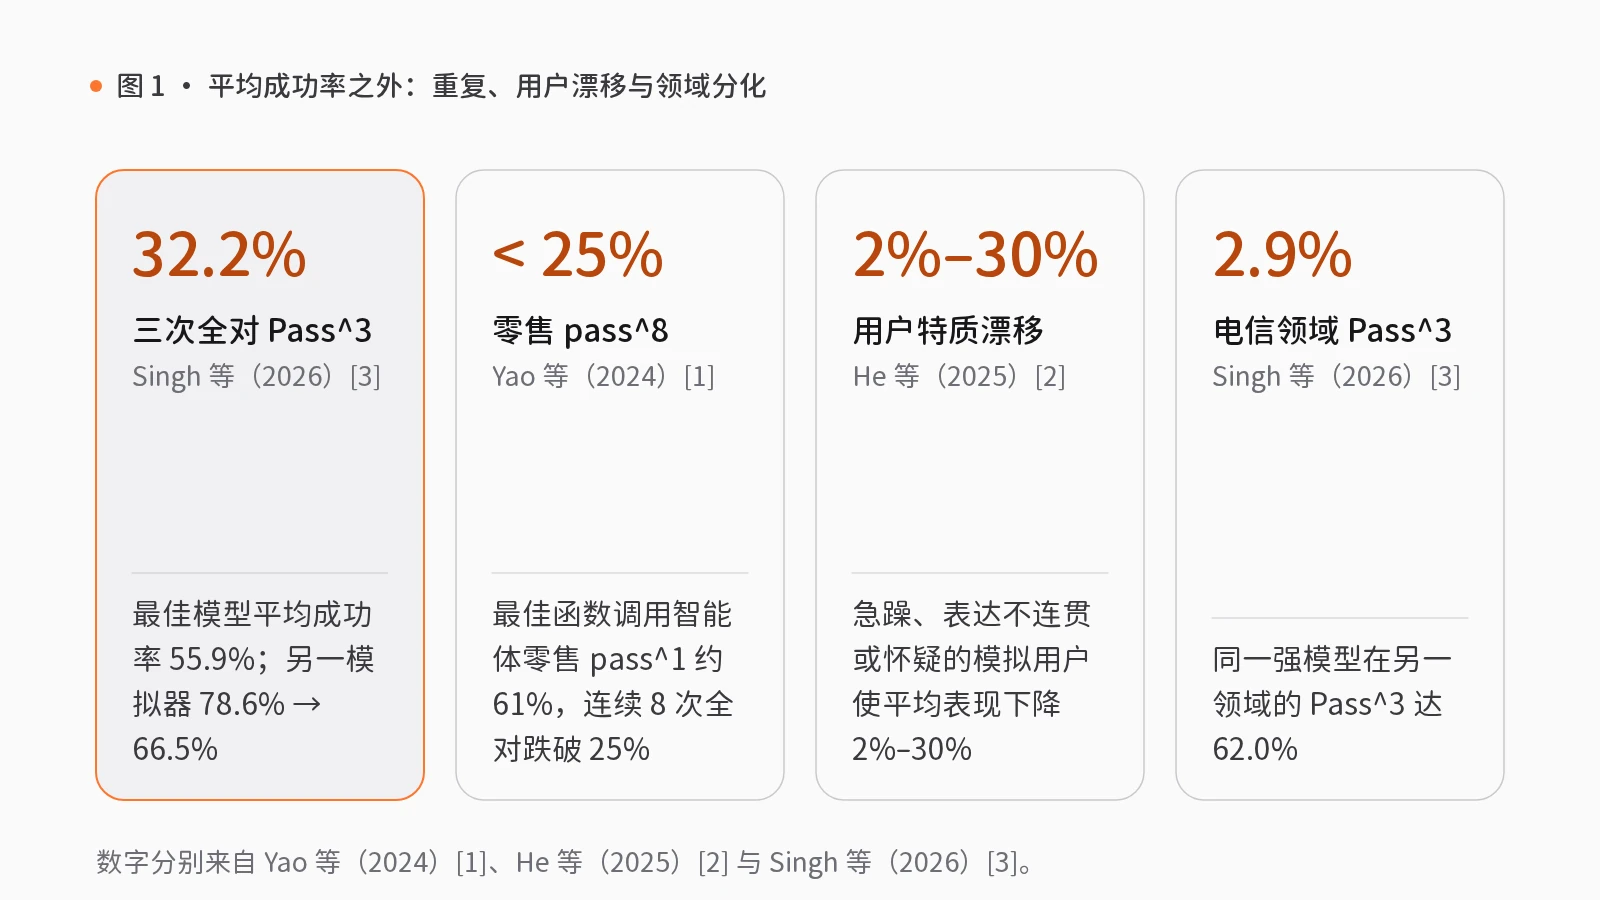
Yao、Shinn、Razavi 与 Narasimhan(2024)提出的 τ-bench 在零售与航司两个客服领域中,让配备领域接口与政策文档的语言智能体同模拟用户多轮对话,并在结束时比对数据库状态与标注目标状态[1]。作者定义了 pass^k 指标,即同一任务在 k 次独立同分布试验中全部成功的概率,以区别于只要一次成功即得分的 pass@k[1]。结果显示,前沿函数调用智能体总体任务成功率不足 50%;2024 年受测表现最好的函数调用智能体在零售与航司上的 pass^1 仅约为 61% 与 35%,且零售领域的 pass^8 跌至 25% 以下[1]。零售失败案例中,25% 源于违反领域规则的错误决策,19% 源于复合请求仅作部分处理[1]。作者强调,基于规则的数据库奖励必要但不充分,例如智能体在未获用户明确确认时直接发起退货,即便末态匹配也构成政策违规[1]。
真实用户并非始终耐心配合。He 等人(2025)通过可控用户特质方向将评测扩展为覆盖航司、零售、电信与远程医疗四个领域的 τ-Trait[2]。当模拟用户变得更急躁、表达不连贯或持怀疑态度时,前沿模型的任务表现平均下降 2% 至 30%,暴露出常规评测遗漏的脆弱性[2]。
Singh 等人(2026)进一步构建了 τ-Emotion-Bench,在涵盖航司、零售、电信、远程医疗、银行与出游等十个领域的 580 项可执行任务上,固定底层任务与成功条件,将五类情绪家族、22 种细分情绪同礼貌度、紧迫感、信任度组合为 594 种测试条件[3]。若模拟用户在任务完成前因不满而提前终止对话,直接计为失败;每项任务运行 3 轮以对比平均成功率 Pass^1 与三次全对率 Pass^3,且经核验由模拟器自身错误导致的失败仅占失败试验的 1.1%[3]。
结果呈现出显著的一致性落差:在第一套模拟器下,受测最佳模型的平均 Pass^1 为 55.9%,而平均 Pass^3 仅为 32.2%,最强智能体也仅能在约三分之一的任务中做到三次全对;在第二套模拟器下,最佳模型平均成功率为 78.6%,平均 Pass^3 降至 66.5%,多数模型在 Pass^1 与 Pass^3 之间流失 14 至 24 个百分点[3]。领域分化同样剧烈,某强模型在单一领域的 Pass^3 达 62.0%,但在电信领域仅为 2.9%[3]。
面向一致性的工程架构:沙箱预演、策略校验与人工接管
既然执行错误与政策违规是主要矛盾,堆砌安抚话术不仅无助于修复参数错误,反而会因多余追问耗尽用户耐心。我们认为,工程验收应将每个客户场景在多特质模拟用户下重复运行,同时报告平均成功率与 pass^k,在每次数据库写操作前执行策略检查,将退款限制在沙箱预演,并将争议请求路由给具名人工负责人。
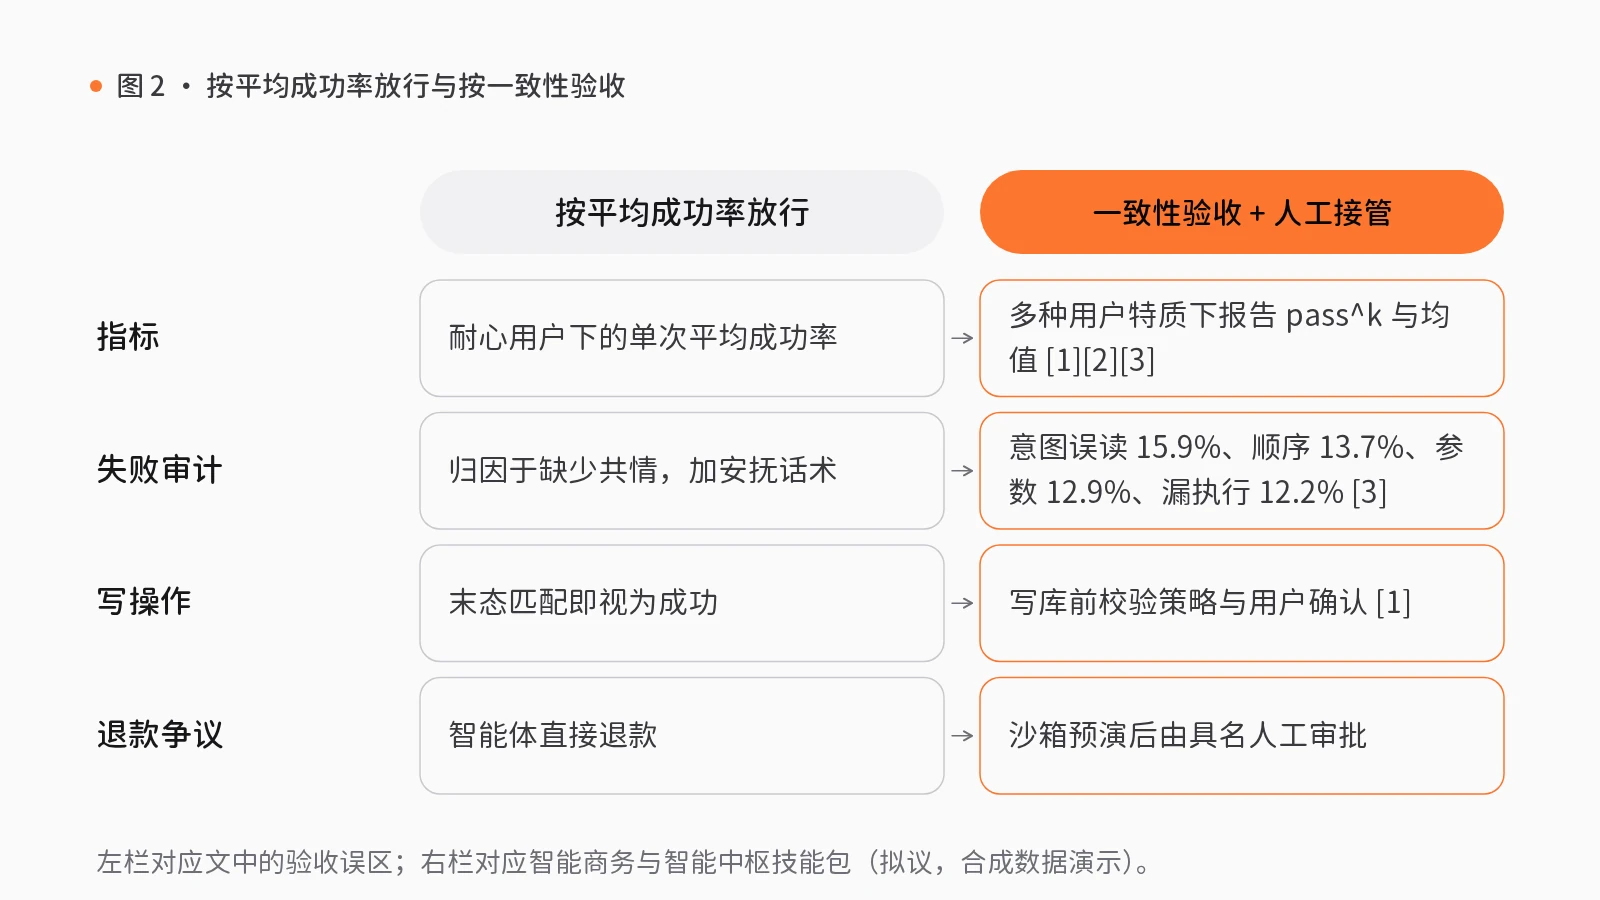
- 会员核对与费用调整:智能商务模块的会员权益与客服处理在消费领域为可迁移应用,落地须替换原有酒店定价模型并绑定钱包或账户身份,且登录签到不能视同已付费权益。流程依序执行“核对身份与权益 → 计算费用 → 客服决定处理 → 通知并留存”。在人工关口处,客服工单与通知收件箱负责管理工单、回复与内部备注、指派、优先级、历史及通知状态,由人工坐席裁决争议调价。
- 医疗行政服务受理与转交:智能中枢模块的服务受理与转交在医疗健康领域为可迁移应用,须对接医院身份与工单系统,且仅限预约、资料申请与转交人员等行政服务,严禁用于基于症状的临床分诊或诊断。流程按“核对账号与角色 → 建立服务记录 → 批准交接资料 → 转交负责人”推进,并由运营身份、权限与审计轨迹提供操作员账户会话、双因素验证、角色权限与操作审计,防范越权访问。
- 收款对账与退款隔离:智能商务模块的收款对账与退款在消费领域为可迁移应用,单次运行只能使用沙箱或真实适配器之一,严禁混用环境,且真实退款仍需有效授权与支付集成。在进入人工复核批准退款或冲正前,系统通过沙箱支付与退款状态编排完成金额、币种与幂等性校验及支付状态预演。
需如实说明能力边界:上述技能包均为基于合成数据演示的拟议编排,并非现成客户生产部署。组件中,客服工单与通知收件箱及运营身份、权限与审计轨迹处于可用状态;而沙箱支付与退款状态编排目前为原型组件,仅含沙箱提供方,尚未接入真实支付适配器。
上线面向客户智能体前的验收清单
在放行面向外部用户的工具调用智能体前,技术与运营团队应落实以下核查:
- 以多特质模拟下的 pass^k 替代均值准入:将核心业务剧本在急躁、怀疑与紧迫等模拟用户下重复测试多轮,并列报告平均成功率与 Pass^3 等指标;若复杂领域的连续通过率过低,不得仅凭单次均值上线。
- 拦截写前策略违规并收敛无效追问:针对意图误读、顺序颠倒、参数错误与漏执行建立专项审计,在所有数据库写接口前加装确定性策略与用户确认校验;要求对话简短确认用户状态后直接推进工具调用,减少冗余反问。
- 坚持退款沙箱预演与争议工单实名兜底:涉及调账、退款与敏感数据访问的操作,先在沙箱与权限组件内完成金额、币种、幂等性及双因素权限核验,并在触发人工关口或客户异议时转入具名坐席工单队列审批留痕。
觉得有用?分享给需要的人。
参考文献
- [1]
Yao, S., Shinn, N., Razavi, P., & Narasimhan, K. (2024). τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains (arXiv:2406.12045). arxiv.org ↗
- [2]
He, M., Kumar, A., Mackey, T., Rajeev, M., Zou, J., & Rajani, N. (2025). Impatient Users Confuse AI Agents: High-fidelity Simulations of Human Traits for Testing Agents (arXiv:2510.04491). arxiv.org ↗
- [3]
Singh, R. K., Saeidi, A., Hegde, S., Kumbhar, S., & Baral, C. (2026). τ-Emotion-Bench: Exposing the Interaction Fragility of LLM Agents through Real-World User Emotions (arXiv:2610.19560). arxiv.org ↗
相关能力
技能包
S36 · 智能商务
会员权益与客服处理
会员咨询折扣与积分时,客服需在多个系统中核实身份、计算费用,争议处理缓慢。
先核对身份与会员权益,计算使用权益后的费用,争议由客服决定处理方式,结果通知会员并留存记录。
- 核对身份与权益
- 计算费用
- 客服决定处理人工复核
- 通知并留存
4 步1 处人工复核6 个组件
S09 · 智能中枢
服务受理与转交
客户提出问题后,客服需核实身份、查询资料、寻找负责人,多次转交仍无人跟进。
先核对账号与角色,建立服务记录,仅向负责人移交必要资料,交接均留有回执。
- 核对账号与角色
- 建立服务记录
- 批准交接资料人工复核
- 转交负责人
4 步1 处人工复核10 个组件
S41 · 智能商务
收款对账与退款
收款渠道多、币种不一,对账依赖表格人工比对,退款出错后难以追回。
先统一金额与币种,核验每笔付款状态,应收与实收逐笔匹配,差异与退款经人工批准后执行。
- 统一金额与币种
- 核验付款状态
- 应收实收逐笔核对
- 批准退款或更正人工复核
- 核对执行结果
5 步1 处人工复核6 个组件