同一個請求,三次結果:面向客戶的智能體為何要用 pass^k 驗收
面向客戶的智能體常按平均任務成功率驗收,但每位真實客戶只經歷一次對話。當同一請求必須在連續多次重試中全部成功(pass^k),且用戶表現出急躁、懷疑或情緒波動時,成功率會顯著下滑;上線驗收必須轉向多輪一致性測試、寫操作策略校驗、沙箱預演與爭議工單人工接管。

均值掩蓋的現場風險:當同一位客戶在重試中拿到不同結果
在零售售後、航司退改或機構行政接待中,越來越多企業將工具調用智能體推向生產一線。上線前,團隊通常依據測試集上的平均任務成功率放行;然而設想進入真實客流後,同一位客戶提出完全相同的退改或權益核對請求,初次對話可能因反覆追問而中斷,再次重試時系統只修改了部分訂單,再試一次甚至可能在未獲明確確認時直接改寫後台狀態。這類不一致一旦進入生產,事後排查與人工兜底的負擔就可能抵消自動化原本承諾的效率收益。
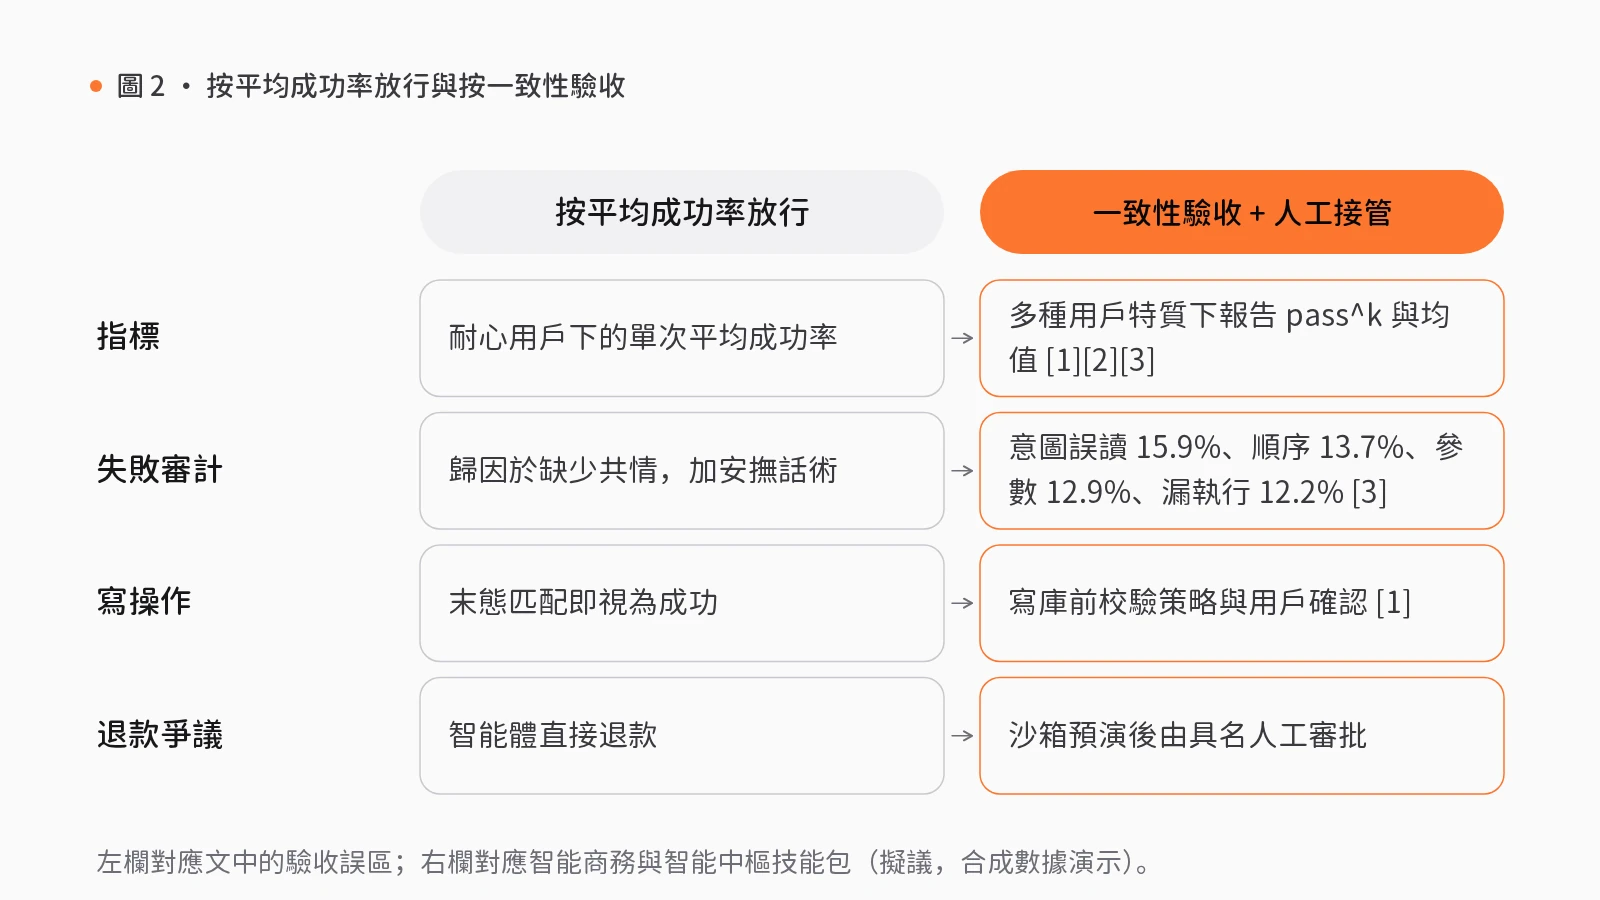
癥結在於用總體均值替代單次交付質素。每位客戶只經歷一次對話,當同一請求必須在連續多次運行中全部成功並遵守規則,即按 pass^k 驗收時,成功率會顯著下跌;若用戶表現出急躁、懷疑或焦慮,穩定性還會進一步惡化。最新實證研究表明,絕大多數失敗並非因為缺少共情,而是源於意圖誤讀、調用順序錯誤、參數錯誤、漏執行等執行故障與策略違規。我們認為,面向客戶的智能體必須採用多輪重複試驗與寫前策略校驗作為驗收標準,將退款與調賬限制在沙箱預演,並在發生爭議時轉交具名人工坐席接管。
從單次通關到全輪一致:pass^k、用戶特質漂移與情緒交互脆弱性
近年關於工具—智能體—用戶交互的研究,從統計一致性、用戶行為特質與情緒抗擾度拆解了這一失效機制。
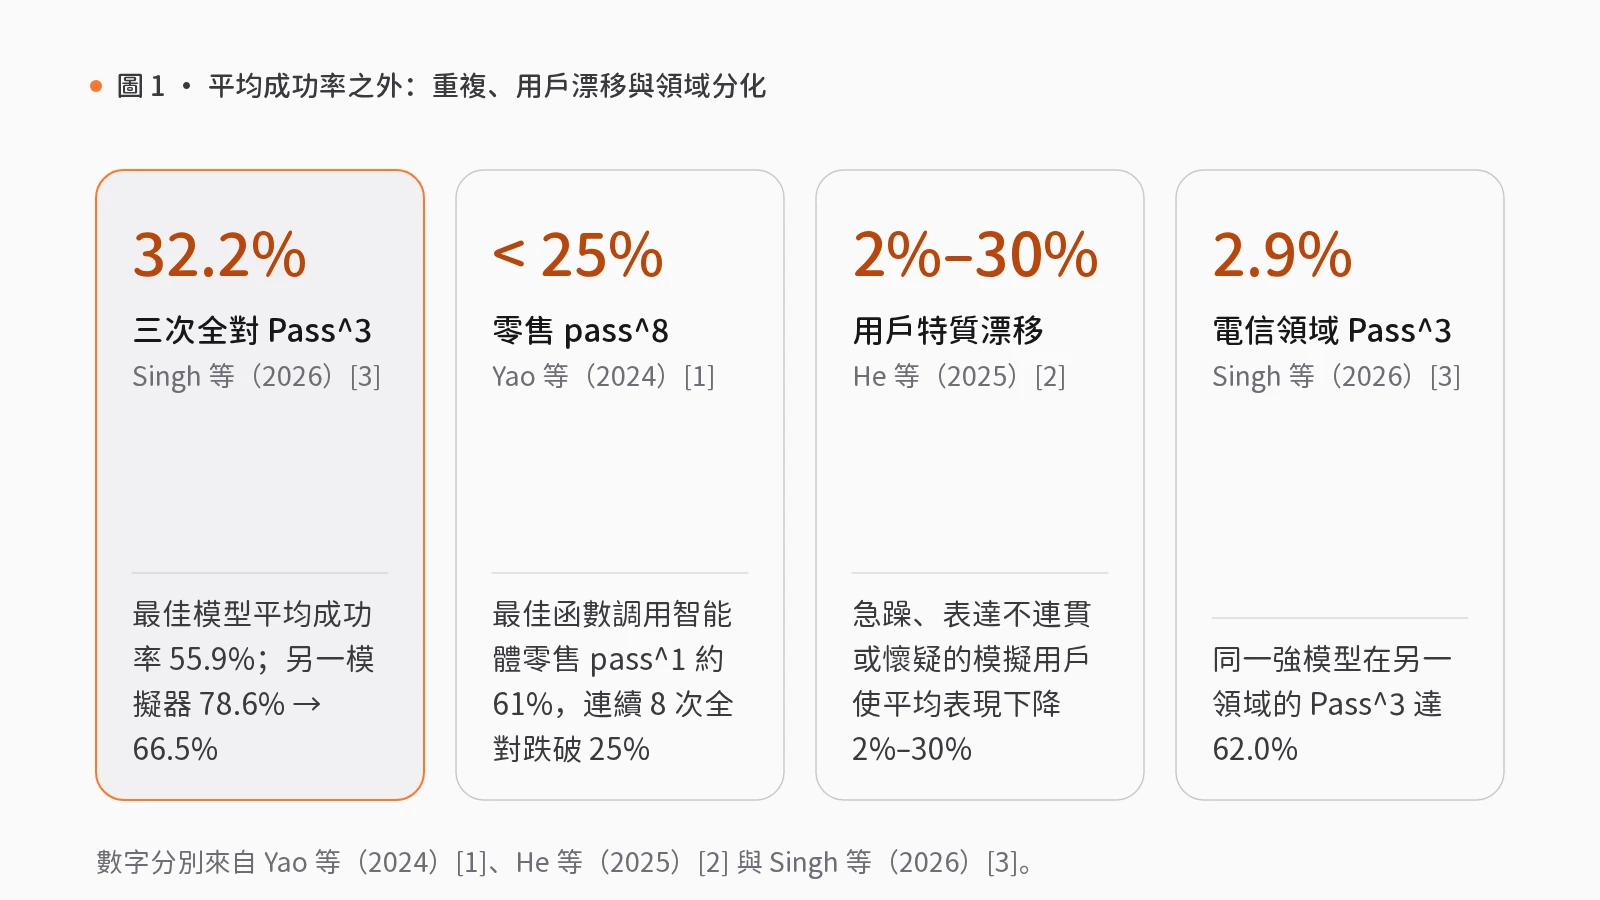
Yao、Shinn、Razavi 與 Narasimhan(2024)提出的 τ-bench 在零售與航司兩個客服領域中,讓配備領域接口與政策文檔的語言智能體同模擬用戶多輪對話,並在結束時比對數據庫狀態與標註目標狀態[1]。作者定義了 pass^k 指標,即同一任務在 k 次獨立同分布試驗中全部成功的概率,以區別於只要一次成功即得分的 pass@k[1]。結果顯示,前沿函數調用智能體總體任務成功率不足 50%;2024 年受測表現最好的函數調用智能體在零售與航司上的 pass^1 僅約為 61% 與 35%,且零售領域的 pass^8 跌至 25% 以下[1]。零售失敗案例中,25% 源於違反領域規則的錯誤決策,19% 源於複合請求僅作部分處理[1]。作者強調,基於規則的數據庫獎勵必要但不充分,例如智能體在未獲用戶明確確認時直接發起退貨,即便末態匹配也構成政策違規[1]。
真實用戶並非始終耐心配合。He 等人(2025)通過可控用戶特質方向將評測擴展為覆蓋航司、零售、電信與遠程醫療四個領域的 τ-Trait[2]。當模擬用戶變得更急躁、表達不連貫或持懷疑態度時,前沿模型的任務表現平均下降 2% 至 30%,暴露出常規評測遺漏的脆弱性[2]。
Singh 等人(2026)進一步構建了 τ-Emotion-Bench,在涵蓋航司、零售、電信、遠程醫療、銀行與出遊等十個領域的 580 項可執行任務上,固定底層任務與成功條件,將五類情緒家族、22 種細分情緒同禮貌度、緊迫感、信任度組合為 594 種測試條件[3]。若模擬用戶在任務完成前因不滿而提前終止對話,直接計為失敗;每項任務運行 3 輪以對比平均成功率 Pass^1 與三次全對率 Pass^3,且經核驗由模擬器自身錯誤導致的失敗僅佔失敗試驗的 1.1%[3]。
結果呈現出顯著的一致性落差:在第一套模擬器下,受測最佳模型的平均 Pass^1 為 55.9%,而平均 Pass^3 僅為 32.2%,最強智能體也僅能在約三分之一的任務中做到三次全對;在第二套模擬器下,最佳模型平均成功率為 78.6%,平均 Pass^3 降至 66.5%,多數模型在 Pass^1 與 Pass^3 之間流失 14 至 24 個百分點[3]。領域分化同樣劇烈,某強模型在單一領域的 Pass^3 達 62.0%,但在電信領域僅為 2.9%[3]。
面向一致性的工程架構:沙箱預演、策略校驗與人工接管
既然執行錯誤與政策違規是主要矛盾,堆砌安撫話術不僅無助於修復參數錯誤,反而會因多餘追問耗盡用戶耐心。我們認為,工程驗收應將每個客戶場景在多特質模擬用戶下重複運行,同時報告平均成功率與 pass^k,在每次數據庫寫操作前執行策略檢查,將退款限制在沙箱預演,並將爭議請求路由給具名人工負責人。
- 會員核對與費用調整:智能商務模組的會員權益與客服處理在消費領域為可遷移應用,落地須替換原有酒店定價模型並綁定錢包或帳戶身份,且登入簽到不能視同已付費權益。流程依序執行「核對身份與權益 → 計算費用 → 客服決定處理 → 通知並留存」。在人工關口處,客服工單與通知收件箱負責管理工單、回覆與內部備註、指派、優先級、歷史及通知狀態,由人工坐席裁決爭議調價。
- 醫療行政服務受理與轉交:智能中樞模組的服務受理與轉交在醫療健康領域為可遷移應用,須對接醫院身份與工單系統,且僅限預約、資料申請與轉交人員等行政服務,嚴禁用於基於症狀的臨牀分診或診斷。流程按「核對帳戶與角色 → 建立服務記錄 → 批准交接資料 → 轉交負責人」推進,並由運營身份、權限與審計軌跡提供操作員帳戶會話、雙因素驗證、角色權限與操作審計,防範越權訪問。
- 收款對賬與退款隔離:智能商務模組的收款對賬與退款在消費領域為可遷移應用,單次運行只能使用沙箱或真實適配器之一,嚴禁混用環境,且真實退款仍需有效授權與支付集成。在進入人工複核批准退款或衝正前,系統通過沙箱支付與退款狀態編排完成金額、幣種與冪等性校驗及支付狀態預演。
需如實説明能力邊界:上述技能包均為基於合成數據演示的擬議編排,並非現成客戶生產部署。組件中,客服工單與通知收件箱及運營身份、權限與審計軌跡處於可用狀態;而沙箱支付與退款狀態編排目前為原型組件,僅含沙箱提供方,尚未接入真實支付適配器。
上線面向客戶智能體前的驗收清單
在放行面向外部用戶的工具調用智能體前,技術與運營團隊應落實以下核查:
- 以多特質模擬下的 pass^k 替代均值准入:將核心業務劇本在急躁、懷疑與緊迫等模擬用戶下重複測試多輪,並列報告平均成功率與 Pass^3 等指標;若複雜領域的連續通過率過低,不得僅憑單次均值上線。
- 攔截寫前策略違規並收斂無效追問:針對意圖誤讀、順序顛倒、參數錯誤與漏執行建立專項審計,在所有數據庫寫接口前加裝確定性策略與用戶確認校驗;要求對話簡短確認用戶狀態後直接推進工具調用,減少冗餘反問。
- 堅持退款沙箱預演與爭議工單實名兜底:涉及調賬、退款與敏感數據訪問的操作,先在沙箱與權限組件內完成金額、幣種、冪等性及雙因素權限核驗,並在觸發人工關口或客戶異議時轉入具名坐席工單隊列審批留痕。
覺得有用?分享給需要的人。
參考文獻
- [1]
Yao, S., Shinn, N., Razavi, P., & Narasimhan, K. (2024). τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains (arXiv:2406.12045). arxiv.org ↗
- [2]
He, M., Kumar, A., Mackey, T., Rajeev, M., Zou, J., & Rajani, N. (2025). Impatient Users Confuse AI Agents: High-fidelity Simulations of Human Traits for Testing Agents (arXiv:2510.04491). arxiv.org ↗
- [3]
Singh, R. K., Saeidi, A., Hegde, S., Kumbhar, S., & Baral, C. (2026). τ-Emotion-Bench: Exposing the Interaction Fragility of LLM Agents through Real-World User Emotions (arXiv:2610.19560). arxiv.org ↗
相關能力
技能包
S36 · 智能商務
會員權益與客服處理
會員諮詢折扣與積分時,客服需在多個系統中核實身份、計算費用,爭議處理緩慢。
先核對身份與會員權益,計算使用權益後的費用,爭議由客服決定處理方式,結果通知會員並留存記錄。
- 核對身份與權益
- 計算費用
- 客服決定處理人工複核
- 通知並留存
4 步1 處人工複核6 個組件
S09 · 智能中樞
服務受理與轉交
客戶提出問題後,客服需核實身份、查詢資料、尋找負責人,多次轉交仍無人跟進。
先核對帳戶與角色,建立服務記錄,僅向負責人移交必要資料,交接均留有回執。
- 核對帳戶與角色
- 建立服務記錄
- 批准交接資料人工複核
- 轉交負責人
4 步1 處人工複核10 個組件
S41 · 智能商務
收款對賬與退款
收款渠道多、幣種不一,對賬依賴表格人工比對,退款出錯後難以追回。
先統一金額與幣種,核驗每筆付款狀態,應收與實收逐筆匹配,差異與退款經人工批准後執行。
- 統一金額與幣種
- 核驗付款狀態
- 應收實收逐筆核對
- 批准退款或更正人工複核
- 核對執行結果
5 步1 處人工複核6 個組件