當「模型當評委」成為上線閘門:一致性幻覺與評測支架偏差
當企業把「模型當評委」(LLM-as-a-Judge)的得分或智能體榜單排名直接作為上線與晉級閘門時,測量誤差就會轉化為生產運營風險。未經機遇校正的精確匹配率會誇大判別力,高重測信度可能掩蓋位置偏差,而智能體得分則將底層模型與外部支架混為一談。發佈閘門必須建立在多協議交叉驗證與高影響決策的人工複核之上。

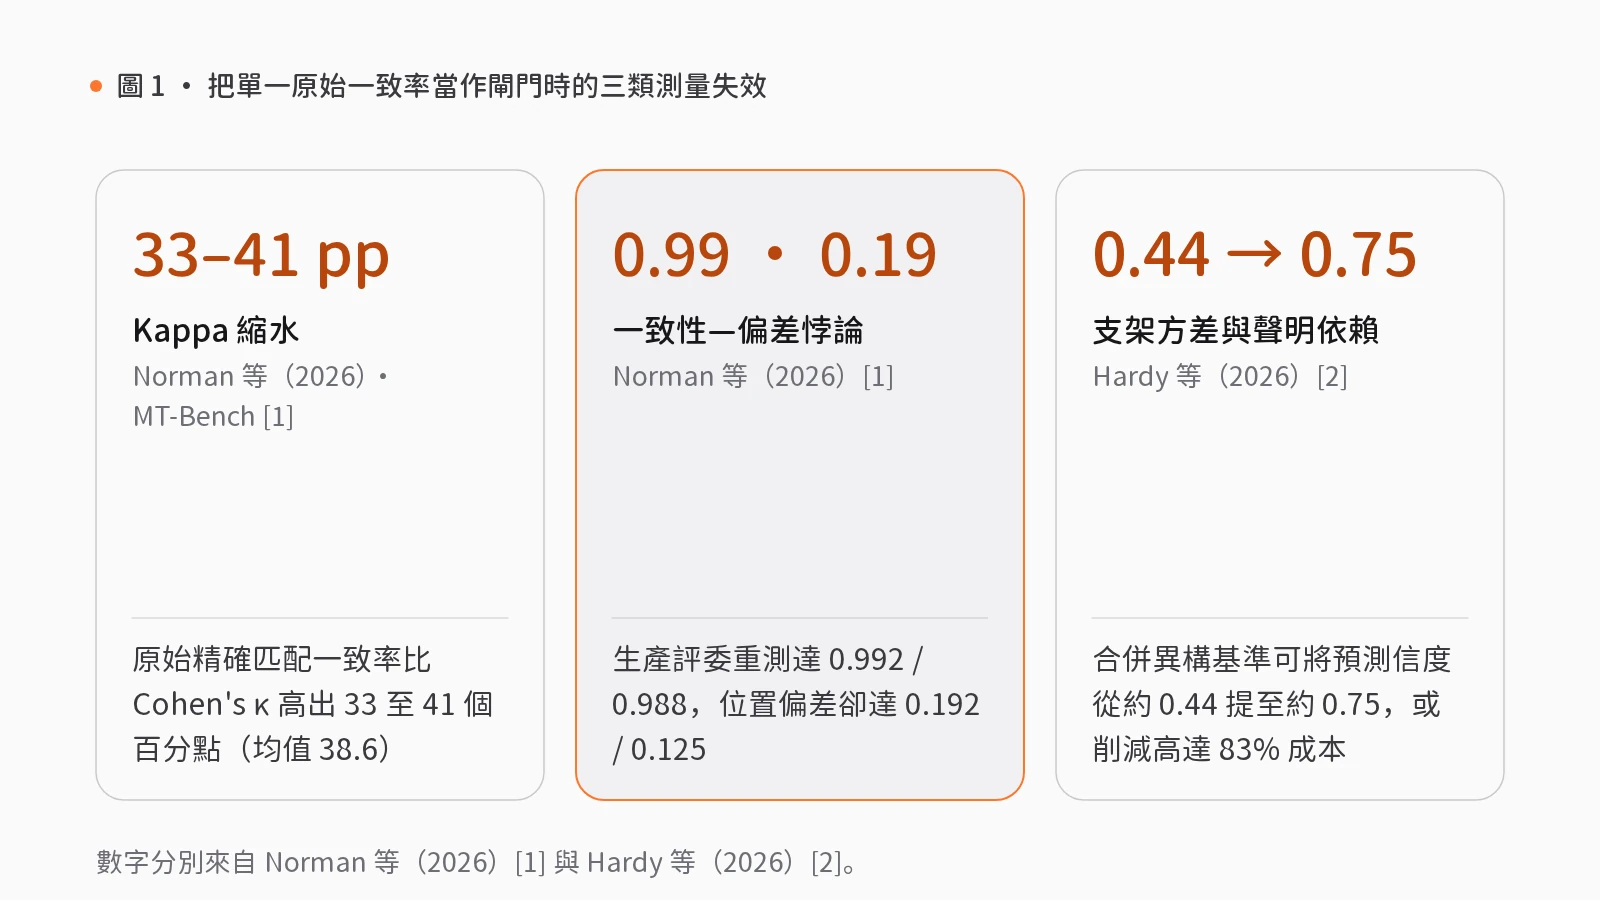
單一高分背後的閘門失靈:當測量誤差變成生產事故
在企業服務與金融機構的大模型工程實踐中,越來越多團隊在持續集成與模型升級流水線中引入「模型當評委」或參考公開智能體榜單。一種典型的上線規則是:只要候選模型在內部評測集上與人工或基準評委的原始一致率超過某一閾值,或者在智能體評測集上的總分高於現網版本,網關就執行流量切換。然而,這類看似客觀的自動化閘門,往往在切流後引發合規問答失準、工具調用鏈路異常或客戶服務質素回退。
問題不在於引入自動化評測本身,而在於將未經審視的測量指標直接等同於上線准入許可。當企業把評委模型得分或智能體榜單排名作為版本晉級與切流的剛性閘門時,潛藏的測量誤差便直接轉化為運營與合規風險。原始精確匹配率會掩蓋機遇一致性並誇大真實判別力,極高的重測一致性可能與嚴重的位置偏差並存,而智能體評測得分則將底層模型能力與外圍工程支架耦合在一起。高風險發佈閘門需要多協議驗證與人工終審,而不能依賴單一的原始一致率數字。
拆解評測幻覺:Kappa 縮水、一致性—偏差悖論與支架方差
自 Zheng 等人(2023)提出以 MT-Bench 與 Chatbot Arena 為代表的成對比較評委模型範式以來,利用強模型評估生成質素已成為行業通用做法;該奠基性研究同時也記錄了評委模型存在位置偏差等侷限[3]。隨着這一範式被直接接入生產流水線,近期兩項大規模實證與計量研究揭示了其中的深層統計失效機制。
Norman、Rivera 與 Hughes(2026)對來自 9 家供應商的 21 個評委模型進行了系統性評估,橫跨 MT-Bench、JudgeBench 與 RewardBench 三大基準,在一致性、穩定性與偏差審計三套協議下,以温度 0 運行了 118 輪實驗,累計產生約 54.1 萬次判決[1]。研究揭示了四項關鍵發現:
第一,Kappa 縮水效應。在 MT-Bench 上,未經機遇校正的精確匹配一致率比 Cohen’s $\kappa$ 係數高出 33 至 41 個百分點(樣本詳細區間為 33.8 至 41.3 個百分點,均值達 38.6 個百分點)[1]。僅看原始一致率會造成評委具備高判別力的假象。
第二,跨基準排名劇烈漂移。同一批評委模型在不同基準上的排名最高可發生 14 個名次的位移;同時,面向事實正確性的 JudgeBench 上的 $\kappa$ 極差高達 60.4 個百分點,而面向偏好評估的 MT-Bench 極差僅為 13.5 個百分點,前者約為後者的 4.5 倍[1]。偏好類基準上的接近表現,無法外推至嚴格要求正確性的任務。
第三,一致性—偏差悖論。高重測信度並不代表無偏。在温度為 0 的條件下,研究中兩個已投入生產部署的評委模型雖然表現出超過 0.95 的重測一致性(分別達到 0.992 與 0.988),卻同時伴有超過 0.10 的嚴重位置偏差(分別為 0.192 與 0.125)[1]。換言之,評委只是極其穩定地偏袒固定位置的候選項。此外,在單一成對評分規程下,整個樣本隊列的冗長偏差均低於 0.011,説明在受控規程下位置偏差是更隱蔽的主導風險[1]。為此,作者提出了五項「最小可行驗證協議」:(1)採用 $\kappa$ 或 $\alpha$ 進行機遇校正;(2)執行 AB 與 BA 雙向位置交換;(3)在温度 0 且禁用緩存的條件下進行不少於 3 次重測;(4)覆蓋至少 2 個跨越偏好與正確性的基準;(5)當重測一致性高於 0.95 時,強制校驗位置偏差是否低於 0.10[1]。
如果被評測對象從單輪文本擴展到多步工具調用的智能體,測量難題會進一步升級。Hardy 等人(2026)運用概化理論與貝葉斯方差分解,對 Holistic Agent Leaderboard 與 Harbor Index(摘要涵蓋 22 個基準)進行了剖析[2]。他們發現,當評估「固定的模型—支架組合系統」時,概化係數 $E\rho^2$ 高達 0.935 至 0.994;但若試圖從中分離並評估「底層模型本身」的排序信度,指標則驟降至 0.148 至 0.841[2]。當不確定性受限於支架與基準交互時,哪怕無限增加同構評測任務,對底層模型排名信度的提升上限也僅為 0.097[2]。相反,將多個異構基準合併評測,在相同任務預算下可將預測信度從約 0.44 提升至約 0.75,或在達到相同説明性信噪比目標時削減高達 83% 的預計評測成本[2]。這説明信度具有高度的「聲明依賴性」:若組織的目標是篩選可直接部署的完整系統,支架效應屬於有效信號;若目標是替換底層基座模型,支架差異則變成了干擾噪聲[2]。
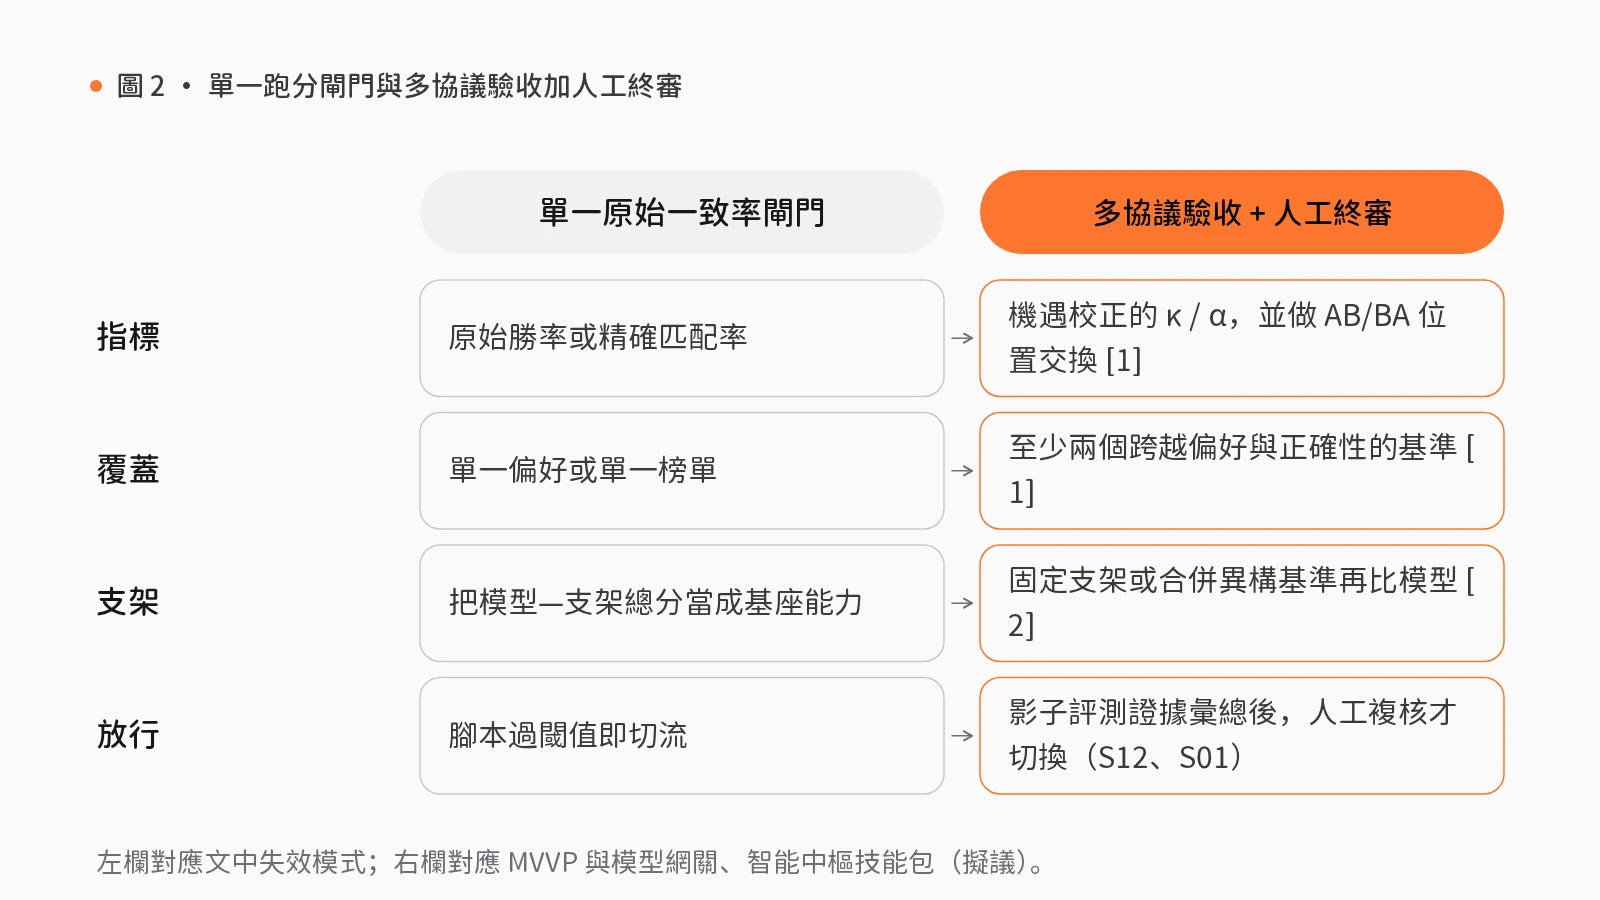
工程化晉級閘門:影子評測、多協議驗收與人工終審
將上述度量機制轉化為生產架構,意味着企業不能只用一個離線跑分腳本決定模型去留,而必須在模型網關與智能中樞之間建立分層驗證與人工審批契約。
在模型網關層,技能包模型對比與切換與新服務試運行接入在企業服務場景中均屬於可遷移應用。工程團隊在評估新模型或新路由策略時,可通過以下兩項核心組件將 Norman 等人(2026)的 MVVP 準則與 Hardy 等人(2026)的支架分離原則落地:
- 影子對比與離線基準評測:在不影響現網用戶響應的前提下,通過影子流量複製真實請求,同步運行多基準離線驗證。評測流水線在此處強制執行 AB/BA 位置翻轉、至少 3 輪無緩存重測,並輸出經機遇校正的 $\kappa$ 指標與位置偏差審計報告,而非單一的原始勝率。
- 任務級模型路由與策略評估:在保持外圍提示詞模板與工具支架恆定的條件下(或顯式交叉測試多套基準),按任務類型區分「偏好生成」與「事實正確性/合規校驗」路由,避免被單一基準排名誤導。同時配合「新服務試運行接入」在切流前完成接口契約、延遲與錯誤率的獨立驗收。
當評測進入上線晉級或異常回滾決策時,自動化評委的得分只能作為呈堂證據,而不能擁有最終放行權。在智能中樞模組中,技能包複雜任務拆解與執行在製造業中標註為可遷移應用,在企業服務與金融風險控制中同樣可作為通用工作流模式遷移複用。通過引入**可審計工作流、人工確認與決策復盤**組件,模型切換與版本晉級被納入受控狀態機:系統自動彙總影子評測的 $\kappa$ 係數、位置偏差審計值與跨基準方差報告,隨後暫停工作流並等待架構師或風控負責人簽字確認。若位置偏差超標或關鍵正確性基準退化,人工複核直接駁回晉級申請,未獲批准的模型配置絕不進入生產流量網關。
上線閘門的三項管理與架構核查
在批准任何以自動化評測為依據的模型切換或智能體上線前,技術負責人與風控團隊應執行三項核查:
- 核查機遇校正與多基準跨度:拒絕彙報單一原始一致率。要求評測報告同時提供 Cohen’s $\kappa$(或 Krippendorff’s $\alpha$),且必須同時涵蓋至少兩個分別代表開放偏好與嚴格事實正確性的基準。
- 核查「高穩定、高偏差」陷阱:當評委模型在温度 0、無緩存重測(至少 3 輪)下的一致性超過 0.95 時,必須查驗 AB/BA 雙向交換的位置偏差是否嚴格低於 0.10,防止將固執的順序偏見誤判為客觀穩定。
- 對齊評測對象與決策聲明,保留人工終審:明確此次變更是「替換底層模型」還是「上線模型—支架整體系統」。若為替換底層模型,須固定支架並合並多樣化基準以壓縮交互噪聲;對於高影響的生產晉級與回滾,必須以人工複核簽字作為最終閘門。
覺得有用?分享給需要的人。
參考文獻
- [1]
Norman, J. D., Rivera, M. U., & Hughes, D. A. (2026). Reliability without Validity: A Systematic, Large-Scale Evaluation of LLM-as-a-Judge Models Across Agreement, Consistency, and Bias. arXiv:2606.19544. arxiv.org ↗
- [2]
Hardy, M., Azam, R., Reuel, A., Kochenderfer, M., & Koyejo, S. (2026). Agent Evaluation Reliability: More Tasks Won’t (Always) Fix An Agent Leaderboard. arXiv:2610.00651. arxiv.org ↗
- [3]
Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., Lin, Z., Li, Z., Li, D., Xing, E. P., Zhang, H., Gonzalez, J. E., & Stoica, I. (2023). Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. Advances in Neural Information Processing Systems (NeurIPS). arXiv:2306.05685. arxiv.org ↗
相關能力
技能包
S12 · 模型網關
模型對比與切換
新模型不斷推出,更換擔心效果下降,不換又擔心落後。
用同一批樣例對比新舊模型的質素、錯誤與費用差異,再確定主用與備用模型。
- 檢查可選模型
- 樣例對比
- 審閲切換建議人工複核
- 設定主備模型
- 切換後抽查人工複核
5 步2 處人工複核7 個組件
S18 · 模型網關
新服務試運行接入
接入新服務時,配置一經修改便影響線上,出錯後也缺乏回退方法。
先登記節點、配置調用方式,以少量請求試運行,確認無誤後正式接入,否則回退。
- 登記服務節點
- 配置調用方式
- 少量試運行
- 接入或回退人工複核
4 步1 處人工複核5 個組件

S01 · 智能中樞
複雜任務拆解與執行
交由 AI 處理的複雜任務常中途停止或偏離目標,進度也無從查看。
先將目標拆解為有序的任務清單,經人工確認範圍後執行,交付前再次驗收。
- 拆解任務清單
- 確認執行範圍人工複核
- 逐項執行
- 驗收交付人工複核
4 步2 處人工複核7 個組件