当「模型当评委」成为上线闸门:一致性幻觉与评测支架偏差
当企业把「模型当评委」(LLM-as-a-Judge)的得分或智能体榜单排名直接作为上线与晋级闸门时,测量误差就会转化为生产运营风险。未经机遇校正的精确匹配率会夸大判别力,高重测信度可能掩盖位置偏差,而智能体得分则将底层模型与外部支架混为一谈。发布闸门必须建立在多协议交叉验证与高影响决策的人工复核之上。

单一高分背后的闸门失灵:当测量误差变成生产事故
在企业服务与金融机构的大模型工程实践中,越来越多团队在持续集成与模型升级流水线中引入“模型当评委”或参考公开智能体榜单。一种典型的上线规则是:只要候选模型在内部评测集上与人工或基准评委的原始一致率超过某一阈值,或者在智能体评测集上的总分高于现网版本,网关就执行流量切换。然而,这类看似客观的自动化闸门,往往在切流后引发合规问答失准、工具调用链路异常或客户服务质量回退。
问题不在于引入自动化评测本身,而在于将未经审视的测量指标直接等同于上线准入许可。当企业把评委模型得分或智能体榜单排名作为版本晋级与切流的刚性闸门时,潜藏的测量误差便直接转化为运营与合规风险。原始精确匹配率会掩盖机遇一致性并夸大真实判别力,极高的重测一致性可能与严重的位置偏差并存,而智能体评测得分则将底层模型能力与外围工程支架耦合在一起。高风险发布闸门需要多协议验证与人工终审,而不能依赖单一的原始一致率数字。
拆解评测幻觉:Kappa 缩水、一致性—偏差悖论与支架方差
自 Zheng 等人(2023)提出以 MT-Bench 与 Chatbot Arena 为代表的成对比较评委模型范式以来,利用强模型评估生成质量已成为行业通用做法;该奠基性研究同时也记录了评委模型存在位置偏差等局限[3]。随着这一范式被直接接入生产流水线,近期两项大规模实证与计量研究揭示了其中的深层统计失效机制。
Norman、Rivera 与 Hughes(2026)对来自 9 家供应商的 21 个评委模型进行了系统性评估,横跨 MT-Bench、JudgeBench 与 RewardBench 三大基准,在一致性、稳定性与偏差审计三套协议下,以温度 0 运行了 118 轮实验,累计产生约 54.1 万次判决[1]。研究揭示了四项关键发现:
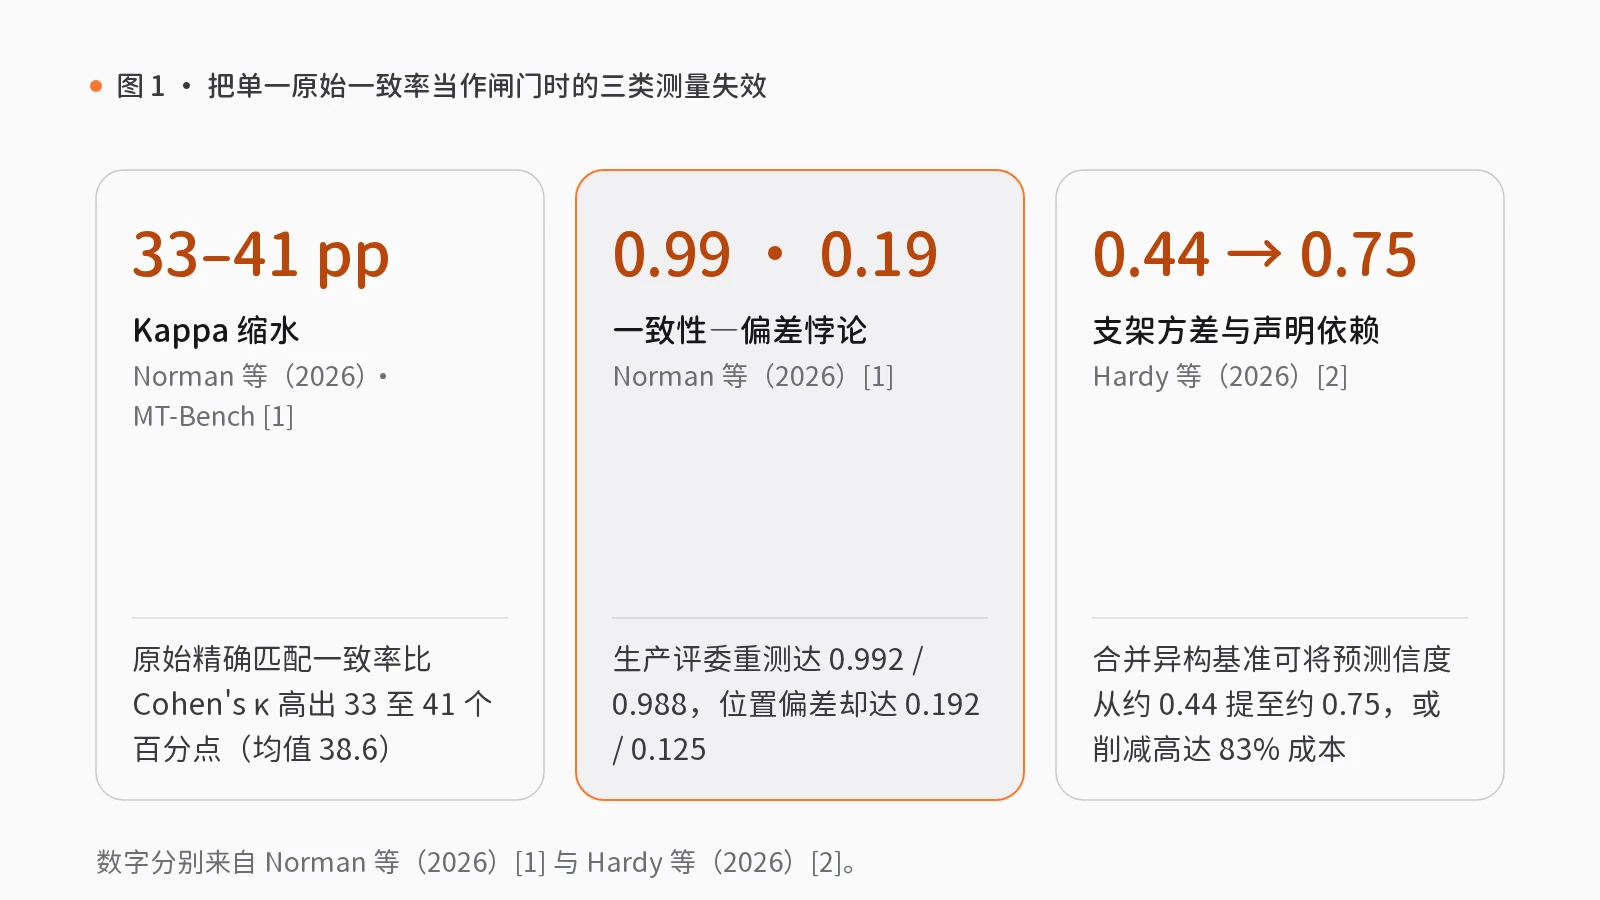
第一,Kappa 缩水效应。在 MT-Bench 上,未经机遇校正的精确匹配一致率比 Cohen’s $\kappa$ 系数高出 33 至 41 个百分点(样本详细区间为 33.8 至 41.3 个百分点,均值达 38.6 个百分点)[1]。仅看原始一致率会造成评委具备高判别力的假象。
第二,跨基准排名剧烈漂移。同一批评委模型在不同基准上的排名最高可发生 14 个名次的位移;同时,面向事实正确性的 JudgeBench 上的 $\kappa$ 极差高达 60.4 个百分点,而面向偏好评估的 MT-Bench 极差仅为 13.5 个百分点,前者约为后者的 4.5 倍[1]。偏好类基准上的接近表现,无法外推至严格要求正确性的任务。
第三,一致性—偏差悖论。高重测信度并不代表无偏。在温度为 0 的条件下,研究中两个已投入生产部署的评委模型虽然表现出超过 0.95 的重测一致性(分别达到 0.992 与 0.988),却同时伴有超过 0.10 的严重位置偏差(分别为 0.192 与 0.125)[1]。换言之,评委只是极其稳定地偏袒固定位置的候选项。此外,在单一成对评分规程下,整个样本队列的冗长偏差均低于 0.011,说明在受控规程下位置偏差是更隐蔽的主导风险[1]。为此,作者提出了五项“最小可行验证协议”:(1)采用 $\kappa$ 或 $\alpha$ 进行机遇校正;(2)执行 AB 与 BA 双向位置交换;(3)在温度 0 且禁用缓存的条件下进行不少于 3 次重测;(4)覆盖至少 2 个跨越偏好与正确性的基准;(5)当重测一致性高于 0.95 时,强制校验位置偏差是否低于 0.10[1]。
如果被评测对象从单轮文本扩展到多步工具调用的智能体,测量难题会进一步升级。Hardy 等人(2026)运用概化理论与贝叶斯方差分解,对 Holistic Agent Leaderboard 与 Harbor Index(摘要涵盖 22 个基准)进行了剖析[2]。他们发现,当评估“固定的模型—支架组合系统”时,概化系数 $E\rho^2$ 高达 0.935 至 0.994;但若试图从中分离并评估“底层模型本身”的排序信度,指标则骤降至 0.148 至 0.841[2]。当不确定性受限于支架与基准交互时,哪怕无限增加同构评测任务,对底层模型排名信度的提升上限也仅为 0.097[2]。相反,将多个异构基准合并评测,在相同任务预算下可将预测信度从约 0.44 提升至约 0.75,或在达到相同说明性信噪比目标时削减高达 83% 的预计评测成本[2]。这说明信度具有高度的“声明依赖性”:若组织的目标是筛选可直接部署的完整系统,支架效应属于有效信号;若目标是替换底层基座模型,支架差异则变成了干扰噪声[2]。
工程化晋级闸门:影子评测、多协议验收与人工终审
将上述度量机制转化为生产架构,意味着企业不能只用一个离线跑分脚本决定模型去留,而必须在模型网关与智能中枢之间建立分层验证与人工审批契约。
在模型网关层,技能包模型对比与切换与新服务试运行接入在企业服务场景中均属于可迁移应用。工程团队在评估新模型或新路由策略时,可通过以下两项核心组件将 Norman 等人(2026)的 MVVP 准则与 Hardy 等人(2026)的支架分离原则落地:
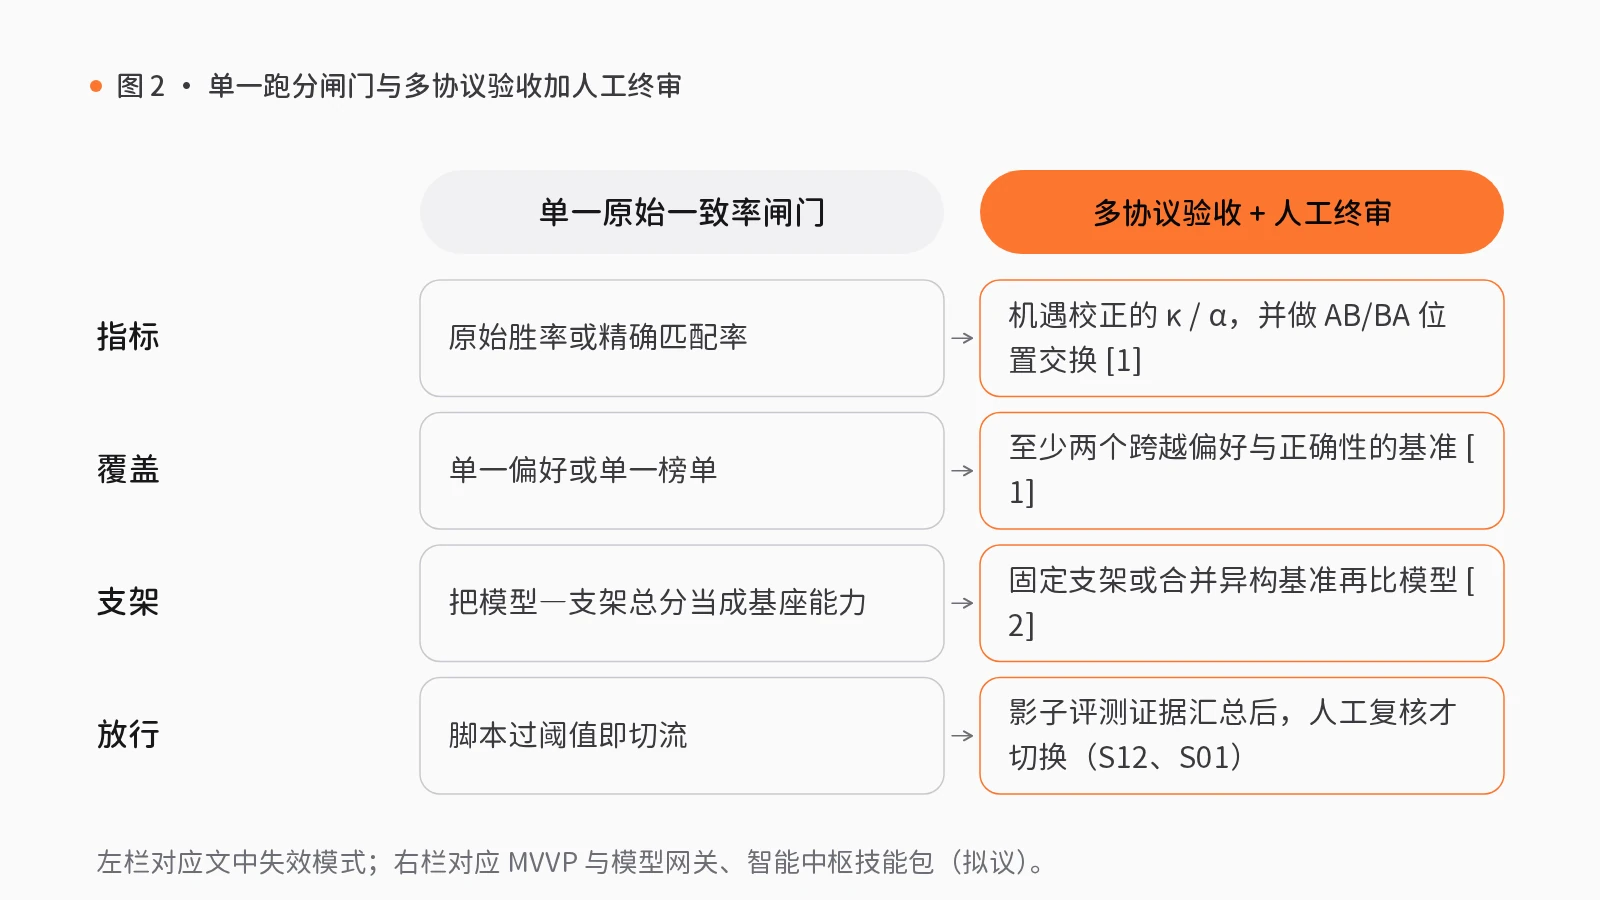
- 影子对比与离线基准评测:在不影响现网用户响应的前提下,通过影子流量复制真实请求,同步运行多基准离线验证。评测流水线在此处强制执行 AB/BA 位置翻转、至少 3 轮无缓存重测,并输出经机遇校正的 $\kappa$ 指标与位置偏差审计报告,而非单一的原始胜率。
- 任务级模型路由与策略评估:在保持外围提示词模板与工具支架恒定的条件下(或显式交叉测试多套基准),按任务类型区分“偏好生成”与“事实正确性/合规校验”路由,避免被单一基准排名误导。同时配合「新服务试运行接入」在切流前完成接口契约、延迟与错误率的独立验收。
当评测进入上线晋级或异常回滚决策时,自动化评委的得分只能作为呈堂证据,而不能拥有最终放行权。在智能中枢模块中,技能包复杂任务拆解与执行在制造业中标注为可迁移应用,在企业服务与金融风险控制中同样可作为通用工作流模式迁移复用。通过引入**可审计工作流、人工确认与决策复盘**组件,模型切换与版本晋级被纳入受控状态机:系统自动汇总影子评测的 $\kappa$ 系数、位置偏差审计值与跨基准方差报告,随后暂停工作流并等待架构师或风控负责人签字确认。若位置偏差超标或关键正确性基准退化,人工复核直接驳回晋级申请,未获批准的模型配置绝不进入生产流量网关。
上线闸门的三项管理与架构核查
在批准任何以自动化评测为依据的模型切换或智能体上线前,技术负责人与风控团队应执行三项核查:
- 核查机遇校正与多基准跨度:拒绝汇报单一原始一致率。要求评测报告同时提供 Cohen’s $\kappa$(或 Krippendorff’s $\alpha$),且必须同时涵盖至少两个分别代表开放偏好与严格事实正确性的基准。
- 核查“高稳定、高偏差”陷阱:当评委模型在温度 0、无缓存重测(至少 3 轮)下的一致性超过 0.95 时,必须查验 AB/BA 双向交换的位置偏差是否严格低于 0.10,防止将固执的顺序偏见误判为客观稳定。
- 对齐评测对象与决策声明,保留人工终审:明确此次变更是“替换底层模型”还是“上线模型—支架整体系统”。若为替换底层模型,须固定支架并合并多样化基准以压缩交互噪声;对于高影响的生产晋级与回滚,必须以人工复核签字作为最终闸门。
觉得有用?分享给需要的人。
参考文献
- [1]
Norman, J. D., Rivera, M. U., & Hughes, D. A. (2026). Reliability without Validity: A Systematic, Large-Scale Evaluation of LLM-as-a-Judge Models Across Agreement, Consistency, and Bias. arXiv:2606.19544. arxiv.org ↗
- [2]
Hardy, M., Azam, R., Reuel, A., Kochenderfer, M., & Koyejo, S. (2026). Agent Evaluation Reliability: More Tasks Won’t (Always) Fix An Agent Leaderboard. arXiv:2610.00651. arxiv.org ↗
- [3]
Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., Lin, Z., Li, Z., Li, D., Xing, E. P., Zhang, H., Gonzalez, J. E., & Stoica, I. (2023). Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. Advances in Neural Information Processing Systems (NeurIPS). arXiv:2306.05685. arxiv.org ↗
相关能力
技能包
S12 · 模型网关
模型对比与切换
新模型不断推出,更换担心效果下降,不换又担心落后。
用同一批样例对比新旧模型的质量、错误与费用差异,再确定主用与备用模型。
- 检查可选模型
- 样例对比
- 审阅切换建议人工复核
- 设定主备模型
- 切换后抽查人工复核
5 步2 处人工复核7 个组件
S18 · 模型网关
新服务试运行接入
接入新服务时,配置一经修改便影响线上,出错后也缺乏回退方法。
先登记节点、配置调用方式,以少量请求试运行,确认无误后正式接入,否则回退。
- 登记服务节点
- 配置调用方式
- 少量试运行
- 接入或回退人工复核
4 步1 处人工复核5 个组件

S01 · 智能中枢
复杂任务拆解与执行
交由 AI 处理的复杂任务常中途停止或偏离目标,进度也无从查看。
先将目标拆解为有序的任务清单,经人工确认范围后执行,交付前再次验收。
- 拆解任务清单
- 确认执行范围人工复核
- 逐项执行
- 验收交付人工复核
4 步2 处人工复核7 个组件