單次調用更便宜,成功交付卻更貴:智能體的「每次成功交付成本」
智能體成本通常按單次調用或單次嘗試彙報,但真實業務結果取決於多步決策、故障恢復與完工核驗。當廉價決策模型省下的單步開銷被輔助推理、拉長的交互、失敗恢復與過早宣告完工吞噬時,計入失敗重試後的每次成功交付成本可能持平甚至上升。

單步賬單縮水與總賬超支:智能體成本的核算錯位
設想一個企業智能體試點:技術團隊把動作選擇換成更輕、更便宜的模型後,網關看板上的單次調用均價與單步延遲明顯下降。但當財務與運營把月度總賬和實際辦結的工單對起來看時,每筆有效業務的平均支出可能幾乎沒變,排查卡住的運行、撤回「假完工」的人工負擔反而可能加重。若不按完整交付結果核算,單步層面的賬面節約就可能被異常處置與人工監督抵消。
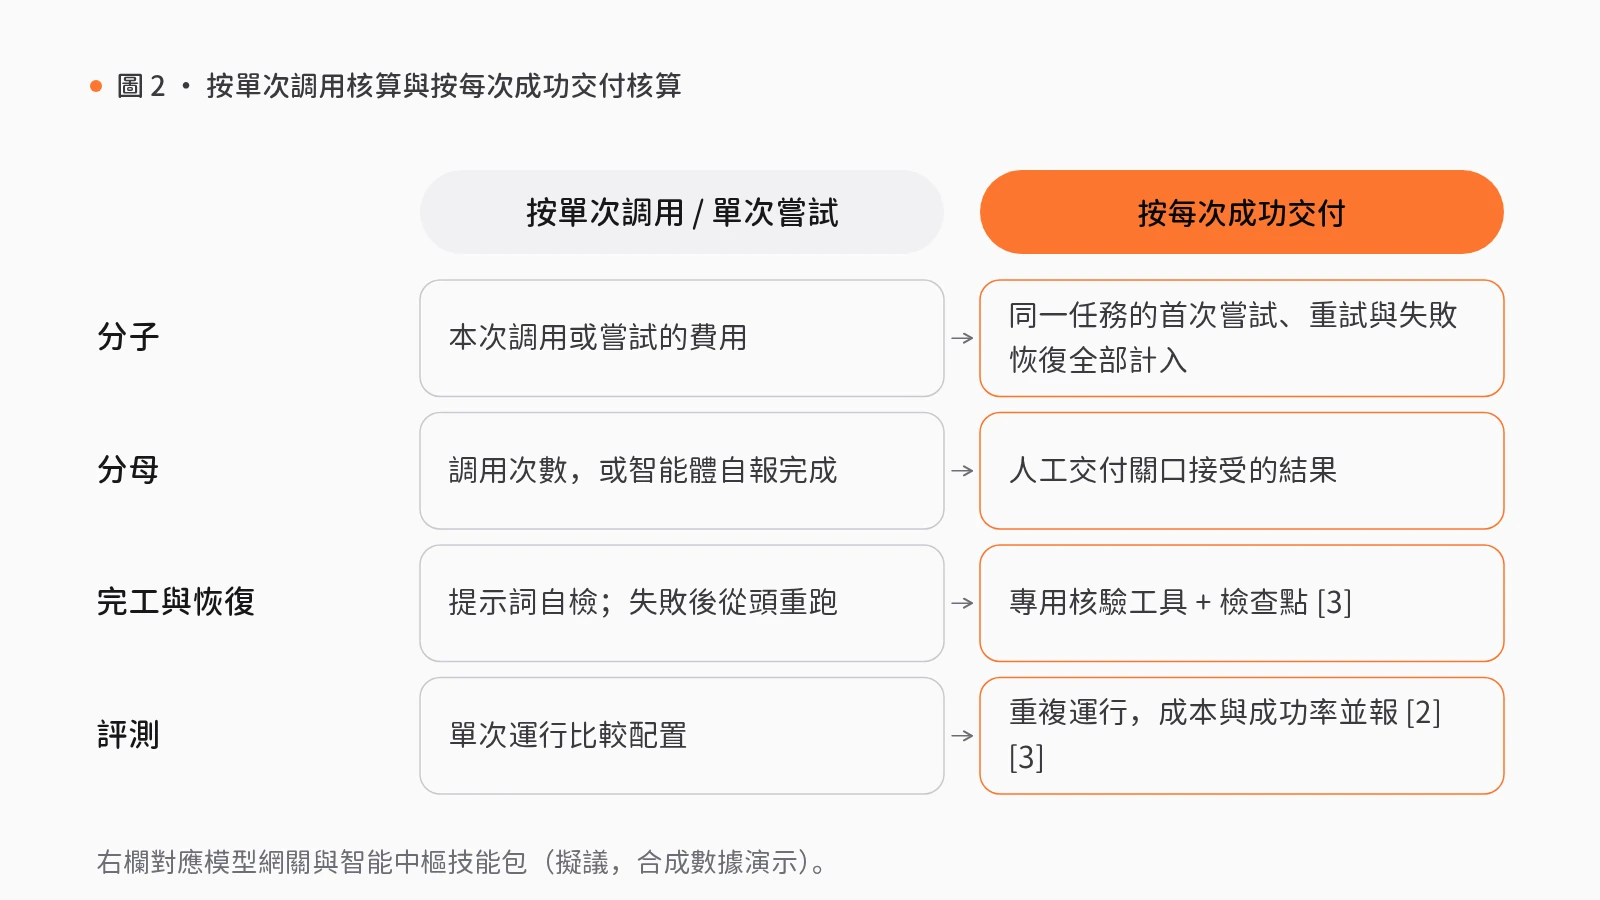
這一反差源於核算口徑錯位。智能體成本通常按單次調用或單次嘗試彙報,但業務結果依賴一連串決策、故障恢復與完工核驗。廉價決策模型雖能壓低單步成本,但外圍輔助推理、拉長的交互、失敗恢復與過早宣告完工會將省下的開銷悉數吸收——若將失敗嘗試計入分子、以最終被接受的成功交付作為分母,每次成功交付成本可能持平甚至上升。因此,評測必須兼顧成本與重複運行,而完工核驗與進度保護也應固化為系統組件而非提示詞請求。
為什麼「更快更省」的決策未必造就更經濟的智能體
三項關於智能體工作流與評測方法學的研究,從決策節約吸收、成本與準確率聯合優化以及系統級方差分解拆解了這一機制。
Ling、Yu、Chen 與 Fang(2026)在包含 134 項任務的文本家居環境與涵蓋 116 類任務的移動應用環境中評估了五個智能體家族,每個配置重複運行三次,共執行 4,500 次任務,對比原始大模型動作選擇與一種快速、低價的結構化決策模型[1]。在單步層面,五個智能體家族的平均決策成本下降 66.1% 至 78.4%,決策時間縮短 73.9% 至 81.5%;儘管每次決策詞元數上升 53.5% 至 134.9%,更低的單價仍帶來顯著單步節約[1]。
但在完整工作流層面,輔助推理與額外交互吸收了單步節約。文本家居任務成功率接近基線(僅落後 1.49 與 1.74 個百分點),而移動應用環境中兩個智能體的成功率分別下跌 13.22 與 18.10 個百分點,第三個下跌 2.30 個百分點[1]。按「每次成功交付成本」(含失敗嘗試的總成本除以成功次數)計算,四個智能體家族指標下降,但其中一個移動智能體儘管單次嘗試成本下降 17.1%,每次成功交付成本的觀測均值卻從 68.70 毫美元升至 73.97 毫美元,上升 7.7%(其 95% 置信區間跨越零點,應視為觀測均值變化而非已證實的顯著效應);另一移動智能體的每次成功交付耗時則從 239.4 秒升至 377.8 秒[1]。
吞噬節約的癥結在於恢復失敗與過早宣告完工。某一配置中,僅 2.0% 的執行就因無效恢復消耗了 53.3% 的推理總支出;在持續失敗案例中,快速決策模型的 57 次執行中有 40 次恢復失敗,而基線 57 次中僅有 3 次[1]。啓用跨嘗試反思時,快速決策變體首次嘗試成功率雖更高(383/402 即 95.27%,基線為 376/402 即 93.53%),卻僅挽回 19 次初始失敗中的 11 次,遠低於基線 26 次中的 25 次,最終總成功率更低[1]。此外還存在過早宣告完工,例如點擊標有「關閉」的開關便宣告成功,而無線網絡仍處於關閉狀態[1]。作者總結,工作流必須保護進度、支援恢復並核驗完工,以成功交付、恢復表現與每次交付消耗的資源評估價值[1]。
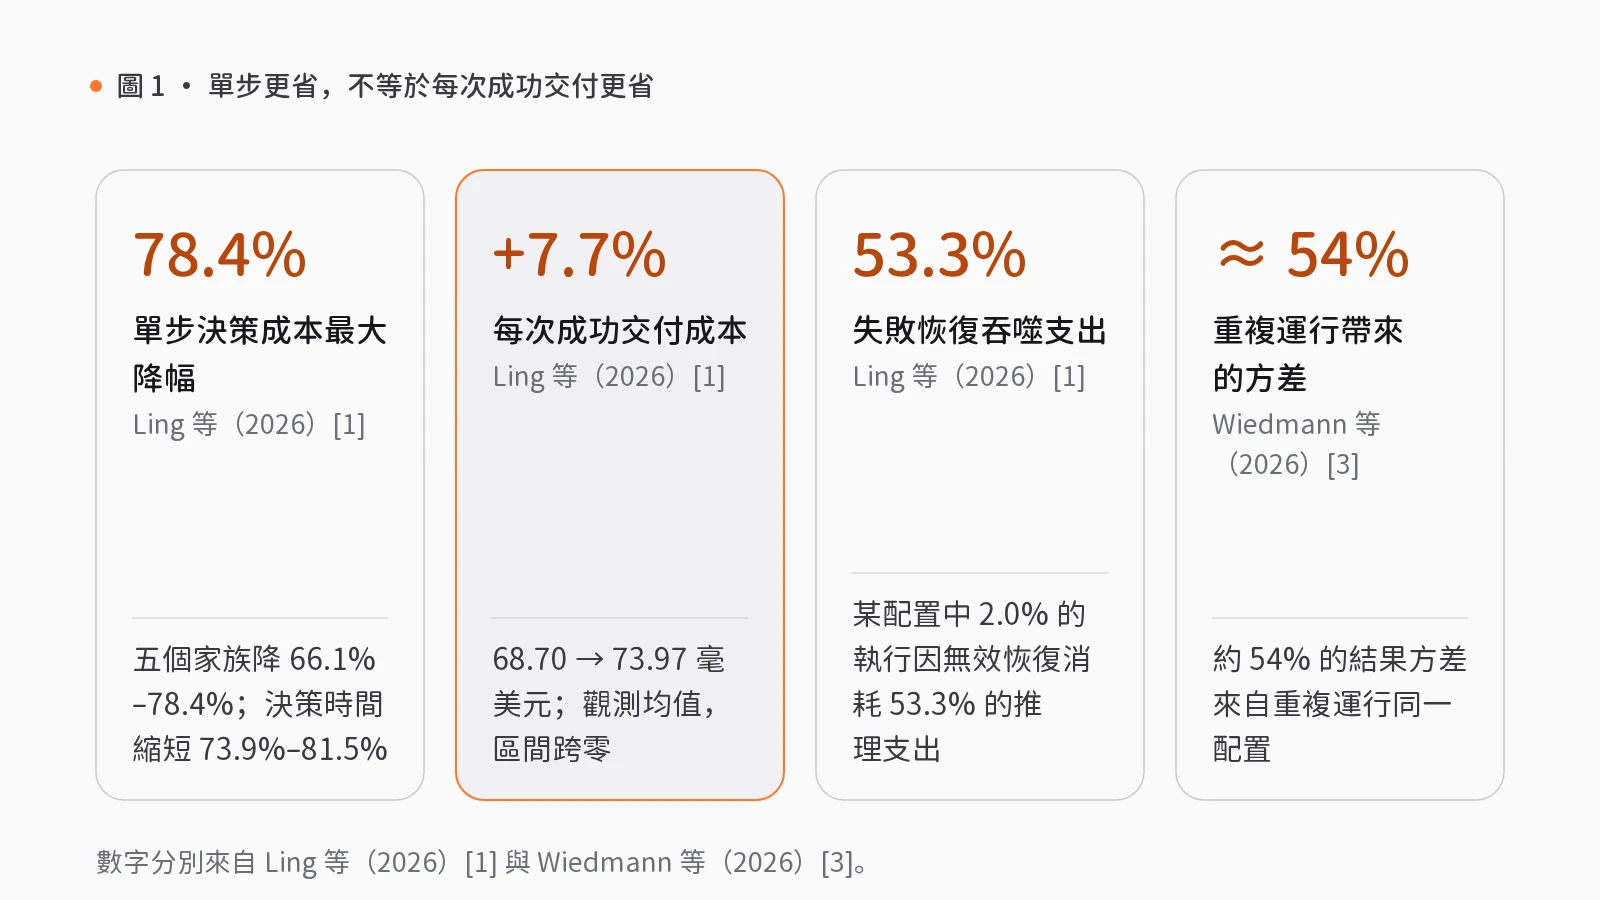
Wiedmann、Girrbach、Schmid 與 Akata(2026)在涵蓋四項科學任務(要求編碼智能體查找並操作已發佈專用模型)、釋放逾 18,000 條軌跡的研究中指出,智能體是可配置系統而非單一模型[3]。對比任務資訊、推理、自我核驗、時間預算與骨幹模型五個部分後發現,在該基準上約 54% 的結果方差來自重複運行同一配置而非改變配置;提供給智能體的任務資訊影響最大,超過時間預算與模型規模,同時能降低成本並改善校準度;增加時間僅在資訊充足或模型足夠強時有效[3]。尤其關鍵的是,用提示詞要求核驗答案對核驗行為影響甚微,而提供專用核驗工具則能顯著改變核驗行為[3]。
面向「每次成功交付」的工程核算與系統架構
我們認為,上述結論指向明確的工程準則:不能以智能體自報完成作為核算終點,也不能靠提示詞防範無效恢復。在 rlab.works 的模型網關與智能中樞模組中,我們建議為每次模型與工具調用綁定任務與運行標識,將失敗與重試開銷歸集至同一任務賬本,並以人工交付關口驗收通過的結果作為分母。
在模型網關層,技能包模型用量與費用核算按「預留預算 → 提交任務 → 逐筆記賬 → 人工對賬(人工關口)」運行。它在公共服務與金融場景均為可遷移應用;金融場景的適配邊界是研究工具運營成本核算,需指定單一計費歸口並統一單位,絕不用於金融交易清算。底層由兩項處於可用狀態的組件支撐:
- 用量預留、預算、版本化定價與結算:預留並結算用量、執行預算硬約束、核對已定價或未定價賬本憑證,我們認為可藉此為失敗恢復循環設定預算上限,避免其無節制消耗算力。
- 網關用量、財務、可靠性與集羣分析:追蹤請求、延遲、錯誤率、緩存節約、用量與成本。我們認為,看板應將失敗與重試歸入主任務,直接報告失敗支出佔比及每次被接受交付的累計耗時與成本。
在智能中樞層,技能包中斷任務接續執行通過「找回歷史記錄 → 確認接續點(人工關口) → 繼續運行 → 驗收結果(人工關口)」保護進度,依託處於可用狀態的組件**可恢復的智能體運行時與上下文管理**實現准入控制、上下文預算、持久化事件、檢查點與重放以及可重連運行。它在消費應用中為可遷移應用,適配邊界是匯入的歷史記錄不得觸發自動新執行或自動扣費,恢復運行必須使用原生檢查點或顯式確認新任務。
最終交付分母由技能包複雜任務拆解與執行界定。它在製造業中為可遷移應用,在其他場景作為通用模式複用,於範圍審批與交付複核處設人工關口。我們認為,應把完工核驗實現為交付關口前的專用工具步驟,僅將人工交付關口正式接受的結果計入成功交付分母。
上線前的三項成本與可靠性核查清單
在替換決策模型或擴建智能體工作流前,工程與財務團隊可執行三項核查:
- 重構核算分母與失敗支出口徑:按任務歸集首次嘗試、重試與失敗放棄的全部成本,除以人工交付關口接受的產出數,同步追蹤失敗支出佔比與每次成功交付耗時。
- 把檢查點與完工核驗做成系統組件:不依賴提示詞自檢,配置獨立核驗工具與原生檢查點,確保失敗從有效檢查點恢復且歷史匯入不觸發自動扣費。
- 補齊任務資訊並執行多次重複評測:鑑於有研究觀察到約 54% 的結果方差來自重複運行同一配置,任何配置比選都應包含重複運行,並優先改善任務資訊與工具契約。
覺得有用?分享給需要的人。
參考文獻
- [1]
Ling, Y., Yu, S., Chen, Z., & Fang, C. (2026). When Faster Decisions Do Not Make Better Agents: An Empirical Study of Jev in Agent Workflows (arXiv:2610.13092). arxiv.org ↗
- [2]
Kapoor, S., Stroebl, B., Siegel, Z. S., Nadgir, N., & Narayanan, A. (2024). AI Agents That Matter (arXiv:2407.01502). arxiv.org ↗
- [3]
Wiedmann, L., Girrbach, L., Schmid, C., & Akata, Z. (2026). Agents Are Systems, Not Models: Rethinking Agentic Evaluation (arXiv:2610.01618). arxiv.org ↗
相關能力
技能包
S13 · 模型網關
模型用量與費用核算
模型賬單月底才出具,超支後也難以説明費用花在哪些請求上。
調用前預留預算,運行後按每次請求記賬,對不上的差異逐條列出。
- 預留預算
- 提交任務
- 逐筆記賬
- 人工對賬人工複核
4 步1 處人工複核5 個組件
S02 · 智能中樞
中斷任務接續執行
長時間運行的任務因斷線、超時或重啓而中斷,往往只能從頭開始。
找回歷史記錄與中斷位置,經人工確認接續點後繼續運行,並驗收結果。
- 找回歷史記錄
- 確認接續點人工複核
- 繼續運行
- 驗收結果人工複核
4 步2 處人工複核6 個組件

S01 · 智能中樞
複雜任務拆解與執行
交由 AI 處理的複雜任務常中途停止或偏離目標,進度也無從查看。
先將目標拆解為有序的任務清單,經人工確認範圍後執行,交付前再次驗收。
- 拆解任務清單
- 確認執行範圍人工複核
- 逐項執行
- 驗收交付人工複核
4 步2 處人工複核7 個組件