分數表之外:評測夾具的預言機缺陷與配置相關測量
基準測試的通過率並非模型固有能力的直接讀數,而是由任務、輸入生成器與評分預言機組成的評測夾具所輸出的儀器讀數。發佈閘門需建立在預言機完整性測試、工具調用日誌潔淨重放與固定測量聲明的重複運行之上。

當測量儀器自身失準:高分成績單背後的夾具盲區
在企業服務與工業排程系統的交付中,工程團隊常將基準測試分數表視為上線通行證:只要候選配置在多輪工具調用評測中跑出優異的通過率,或在調整提示詞與工具命名後出現單次得分躍升,便觸發生產路由切換。然而,許多離線高分工作流接入真實訂單修改或工單狀態機後,依然頻發賬實不符與合規越界。
癥結往往不在於評委模型的主觀偏好,而在於評測夾具這台「測量儀器」自身失準。基準成功率並非模型固有能力的直接度量,而是由任務、輸入生成器與評分預言機共同構成的評測夾具所輸出的儀器讀數。近期審計表明,評分預言機可能在算分時篡改待評數據庫狀態,驗證器可能機械匹配工具名而非校驗實際操作,且單次運行對比無法把界面表述變化與常規重跑噪聲區分開[1, 2]。可靠的發佈閘門必須引入預言機完整性測試、可重放的工具調用日誌,以及固定測量聲明下的重複運行。
拆解夾具失效機制:預言機狀態污染、配置敏感性與驗證器脆弱性
為評估真實領域的多輪交互,Yao、Shinn、Razavi 與 Narasimhan(2024)提出了 τ-bench 範式:智能體在模擬用戶對話與領域策略文檔約束下調用業務接口,最終通過比對終端數據庫狀態判定成敗[3]。這一「智能體—用戶—領域接口—策略文檔—數據庫狀態」結構貼近生產環境,但一旦外部夾具與獎勵函數耦合失當,算分過程本身就會製造系統性偏差。
Chen(2026)將研究對象從模型內在能力轉向評測夾具(尤其是獎勵預言機),對一個廣泛使用的零售與航空領域智能體—用戶—數據庫基準進行了審計[1]。研究發現了一項典型的集成失效(上游不安全副作用疊加二次讀取):獎勵函數在構建標準答案哈希時重置環境數據庫以運行參考解,卻從未恢復原狀態[1]。雖然返回值對基準內置運行器可能正確,但任何在會話結束後再對回合算分或重讀狀態的外部夾具,實際讀取的都是參考解留下的狀態[1]。當作者提取 4,320 個歸檔回合的錄製工具調用日誌並在潔淨數據庫上重放時,數據庫狀態通過數從歸檔標籤的 4,194 個降至 2,883 個,實測成功率從 94.3% 跌至 65.5%[1]。
為此,Chen(2026)構建了含 5 項狀態完整性不變量與 3 項已知答案對照的檢驗套件,在所研究實現上檢出了全部 7 類注入的預言機缺陷,隨包修復版預言機未產生假陽性[1]。作者明確將該結論限定在所研究的實現之內而非通用框架:遷移至第二個獨立實現的基準時,因無法重建參考終端狀態而出現了負向可移植性結果[1]。此外,零售領域 3,240 個回合的次級組件消融顯示,智能體讀取的策略文檔、工具説明與錯誤字符串均能抑制軌跡崩潰,探索性排序中工具説明保護效應最大(約 −9.2 個百分點的崩潰惡化),錯誤字符串最小(約 −5.3 個百分點);而在航空領域,用戶語言效應的符號發生反轉,表明結論嚴格受限於所測配置,不能泛化斷言某種語言必然讓智能體變好或變差[1]。
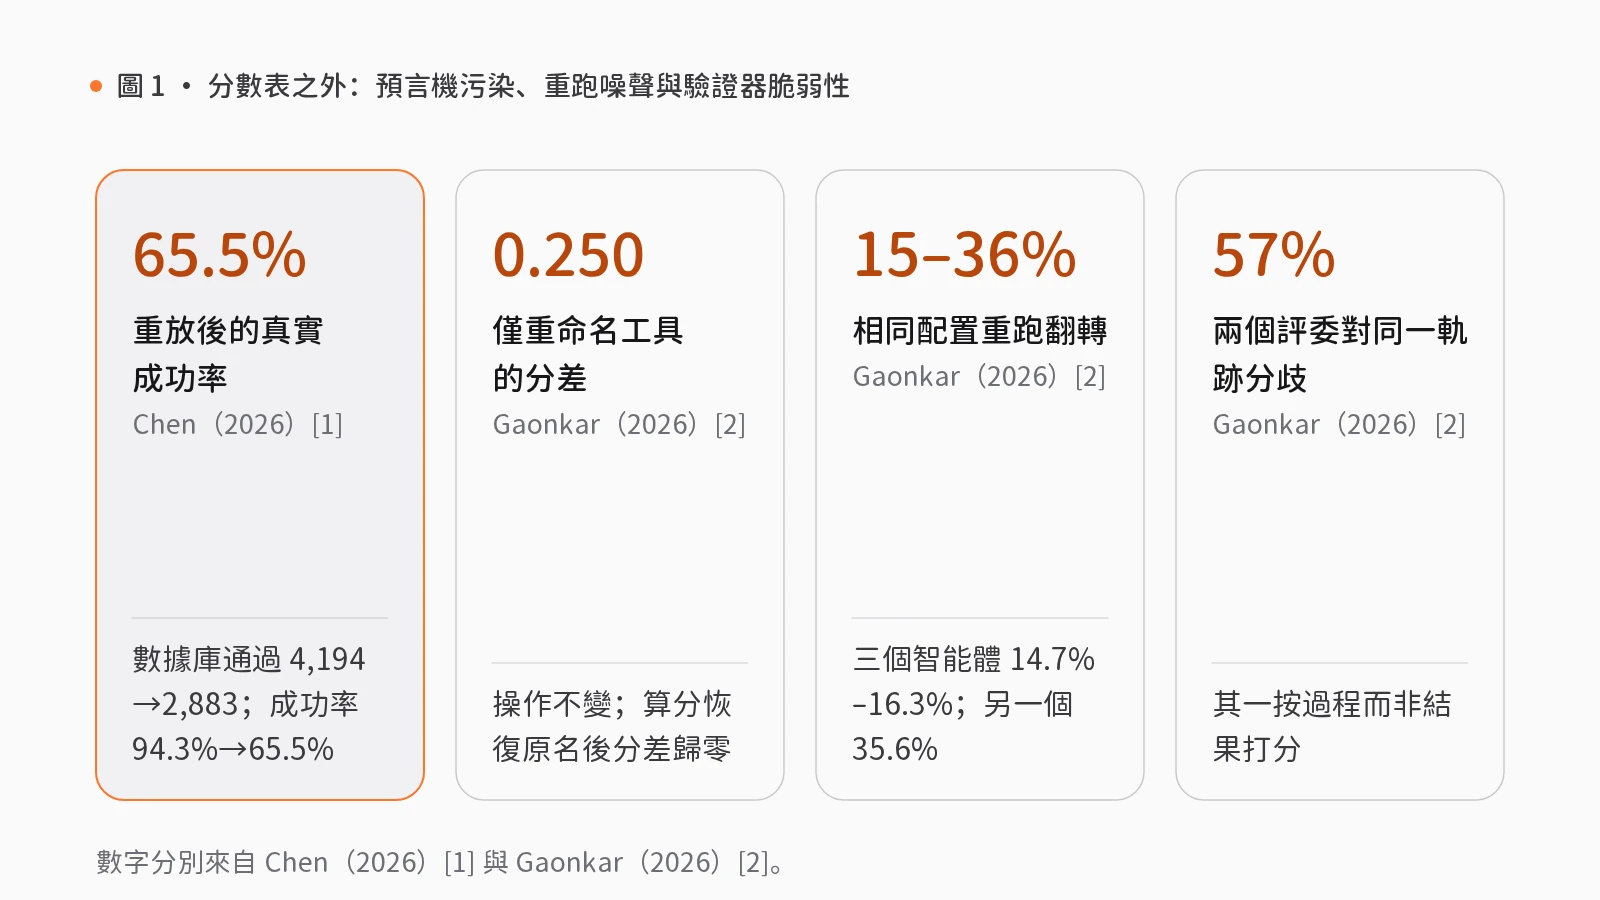
在公開 τ²-bench 跟進實驗中,完全相同的重跑會使 15%–36% 的單任務結果翻轉(三個智能體為 14.7%–16.3%,另一個達 35.6%),因此單次運行對比無法分離表述效應與重跑波動[2]。控制重複後,保持語義的工具重命名或觀察格式調整在 8 組「智能體—變更」配對中的 7 組上使獎勵變化保持在 ±0.10 以內,而誤導性工具名則使所有智能體獎勵下降 0.20–0.44[2]。同時,兩個前沿大模型評委對同一批固定記錄的判決分歧率達 57%(其一按過程而非結果評分),且控制重複後表層表述變化並未引起超出調用間波動的判決偏移[2]。
把評測夾具當成生產軟件來驗證:日誌重放、狀態斷言與人工晉級閘門
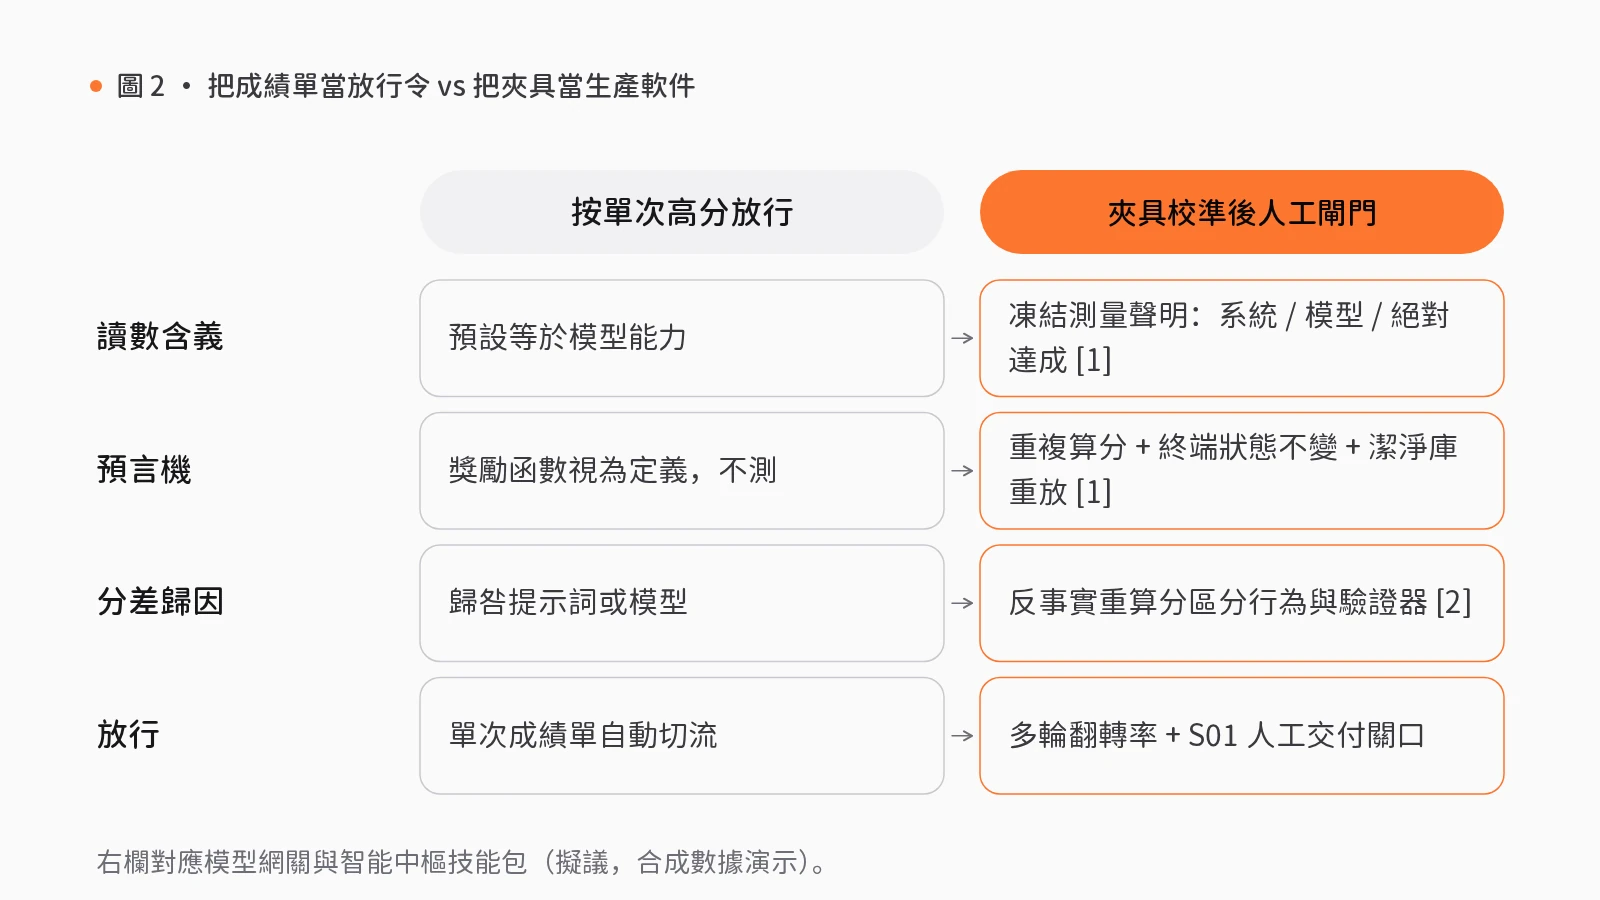
上述發現表明(以下架構映射與檢驗規則屬於本團隊的工程推演),企業應像對待生產軟件一樣對評測夾具執行持續集成校驗。在 rlab.works 的模型網關(AI Gateway)與智能中樞(Agent OS)模組中,可通過三項技能包與核心組件落地這一機制:
第一,持久化調用事件以支援潔淨庫重放。藉助可恢復的智能體運行時與上下文管理(可用組件),系統持久化保存工具調用事件、檢查點與重放記錄。評測流水線應對同一已完成回合執行重複算分,斷言會話結束後終端狀態穩定不變,並保留將工具調用日誌在潔淨數據庫上獨立重放的能力。
第二,凍結測量聲明並量化重跑噪聲。在模型網關模組中,技能包模型對比與切換(S12)與新服務試運行接入(S18)在企業服務中均為可遷移應用。適配邊界上,模型對比與切換要求用真實樣本校驗兼容性,推薦依賴既有記錄且不承諾自動選出最優模型,包含切換方案人工複核與切後抽樣檢查;新服務試運行接入要求分別檢查節點心跳、應用響應與部署,不預設流式輸出或自動重試,在註冊、準備客戶端與測試請求後設驗收或駁回的人工關口。配合網關用量、財務、可靠性與集羣分析(可用組件),團隊應預先凍結分數所支援的聲明(評估完整系統、比對模型或衡量絕對錶現),在對比配置前要求多輪重複運行,並在成績單旁並列彙報評測儀器失效率。
第三,以人工關口守住發佈晉級邊界。在智能中樞模組中,技能包複雜任務拆解與執行(S01)在製造業為可遷移應用,在其他場景作通用工作流模式。它在範圍確認與交付複核處設人工關口,依託可審計工作流、人工確認與決策復盤(原型組件,可暫停等待人工決定並記錄結果,工具步驟目前為佔位與記錄),在模型或路由依據評測證據晉級前由人工審閲並決定接受或駁回。
需説明邊界:上述技能包均為基於合成數據演示的擬議編排,尚未接入真實生產服務,落地時仍需完成領域數據庫快照與接口接線。
上線前的三項評測夾具校準核查
在依據基準分數批准模型切換或配置變更前,技術團隊應執行三項核查(團隊工程推演):
- 校驗預言機狀態不變量與潔淨重放:對同一結束回合重複算分以斷言終端狀態未被篡改,運行已知答案對照測試,並確認工具調用日誌可在潔淨數據庫上重放複核。
- 用反事實重算分剝離驗證器脆弱性:當工具改名或格式微調引發得分下滑時,對未改變的操作軌跡執行恢復原名稱的反事實重算分,區分模型行為退化與算分規則硬編碼匹配。
- 固定測量聲明、執行重複運行並經人工放行:拒絕單次跑分定勝負,要求在明確測量聲明下提交多輪重複運行與儀器異常率報告,並在交付審批人工關口複核通過後方可執行切流。
覺得有用?分享給需要的人。
參考文獻
- [1]
Chen, J. (2026). When Agent Evaluation Becomes Unreliable: An Empirical Study of Oracle Failures and Configuration-Dependent Measurement in an LLM Agent Benchmark (arXiv:2610.16067). arxiv.org ↗
- [2]
Gaonkar, R. (2026). TRACE: Diagnosing Verifier Brittleness in Agentic Evaluation (arXiv:2610.11678). arxiv.org ↗
- [3]
Yao, S., Shinn, N., Razavi, P., & Narasimhan, K. (2024). τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains (arXiv:2406.12045). arxiv.org ↗
相關能力
技能包
S12 · 模型網關
模型對比與切換
新模型不斷推出,更換擔心效果下降,不換又擔心落後。
用同一批樣例對比新舊模型的質素、錯誤與費用差異,再確定主用與備用模型。
- 檢查可選模型
- 樣例對比
- 審閲切換建議人工複核
- 設定主備模型
- 切換後抽查人工複核
5 步2 處人工複核7 個組件
S18 · 模型網關
新服務試運行接入
接入新服務時,配置一經修改便影響線上,出錯後也缺乏回退方法。
先登記節點、配置調用方式,以少量請求試運行,確認無誤後正式接入,否則回退。
- 登記服務節點
- 配置調用方式
- 少量試運行
- 接入或回退人工複核
4 步1 處人工複核5 個組件

S01 · 智能中樞
複雜任務拆解與執行
交由 AI 處理的複雜任務常中途停止或偏離目標,進度也無從查看。
先將目標拆解為有序的任務清單,經人工確認範圍後執行,交付前再次驗收。
- 拆解任務清單
- 確認執行範圍人工複核
- 逐項執行
- 驗收交付人工複核
4 步2 處人工複核7 個組件