分数表之外:评测夹具的预言机缺陷与配置相关测量
基准测试的通过率并非模型固有能力的直接读数,而是由任务、输入生成器与评分预言机组成的评测夹具所输出的仪器读数。发布闸门需建立在预言机完整性测试、工具调用日志洁净重放与固定测量声明的重复运行之上。

当测量仪器自身失准:高分成绩单背后的夹具盲区
在企业服务与工业排程系统的交付中,工程团队常将基准测试分数表视为上线通行证:只要候选配置在多轮工具调用评测中跑出优异的通过率,或在调整提示词与工具命名后出现单次得分跃升,便触发生产路由切换。然而,许多离线高分工作流接入真实订单修改或工单状态机后,依然频发账实不符与合规越界。
症结往往不在于评委模型的主观偏好,而在于评测夹具这台“测量仪器”自身失准。基准成功率并非模型固有能力的直接度量,而是由任务、输入生成器与评分预言机共同构成的评测夹具所输出的仪器读数。近期审计表明,评分预言机可能在算分时篡改待评数据库状态,验证器可能机械匹配工具名而非校验实际操作,且单次运行对比无法把界面表述变化与常规重跑噪声区分开[1, 2]。可靠的发布闸门必须引入预言机完整性测试、可重放的工具调用日志,以及固定测量声明下的重复运行。
拆解夹具失效机制:预言机状态污染、配置敏感性与验证器脆弱性
为评估真实领域的多轮交互,Yao、Shinn、Razavi 与 Narasimhan(2024)提出了 τ-bench 范式:智能体在模拟用户对话与领域策略文档约束下调用业务接口,最终通过比对终端数据库状态判定成败[3]。这一“智能体—用户—领域接口—策略文档—数据库状态”结构贴近生产环境,但一旦外部夹具与奖励函数耦合失当,算分过程本身就会制造系统性偏差。
Chen(2026)将研究对象从模型内在能力转向评测夹具(尤其是奖励预言机),对一个广泛使用的零售与航空领域智能体—用户—数据库基准进行了审计[1]。研究发现了一项典型的集成失效(上游不安全副作用叠加二次读取):奖励函数在构建标准答案哈希时重置环境数据库以运行参考解,却从未恢复原状态[1]。虽然返回值对基准内置运行器可能正确,但任何在会话结束后再对回合算分或重读状态的外部夹具,实际读取的都是参考解留下的状态[1]。当作者提取 4,320 个归档回合的录制工具调用日志并在洁净数据库上重放时,数据库状态通过数从归档标签的 4,194 个降至 2,883 个,实测成功率从 94.3% 跌至 65.5%[1]。
为此,Chen(2026)构建了含 5 项状态完整性不变量与 3 项已知答案对照的检验套件,在所研究实现上检出了全部 7 类注入的预言机缺陷,随包修复版预言机未产生假阳性[1]。作者明确将该结论限定在所研究的实现之内而非通用框架:迁移至第二个独立实现的基准时,因无法重建参考终端状态而出现了负向可移植性结果[1]。此外,零售领域 3,240 个回合的次级组件消融显示,智能体读取的策略文档、工具说明与错误字符串均能抑制轨迹崩溃,探索性排序中工具说明保护效应最大(约 −9.2 个百分点的崩溃恶化),错误字符串最小(约 −5.3 个百分点);而在航空领域,用户语言效应的符号发生反转,表明结论严格受限于所测配置,不能泛化断言某种语言必然让智能体变好或变差[1]。
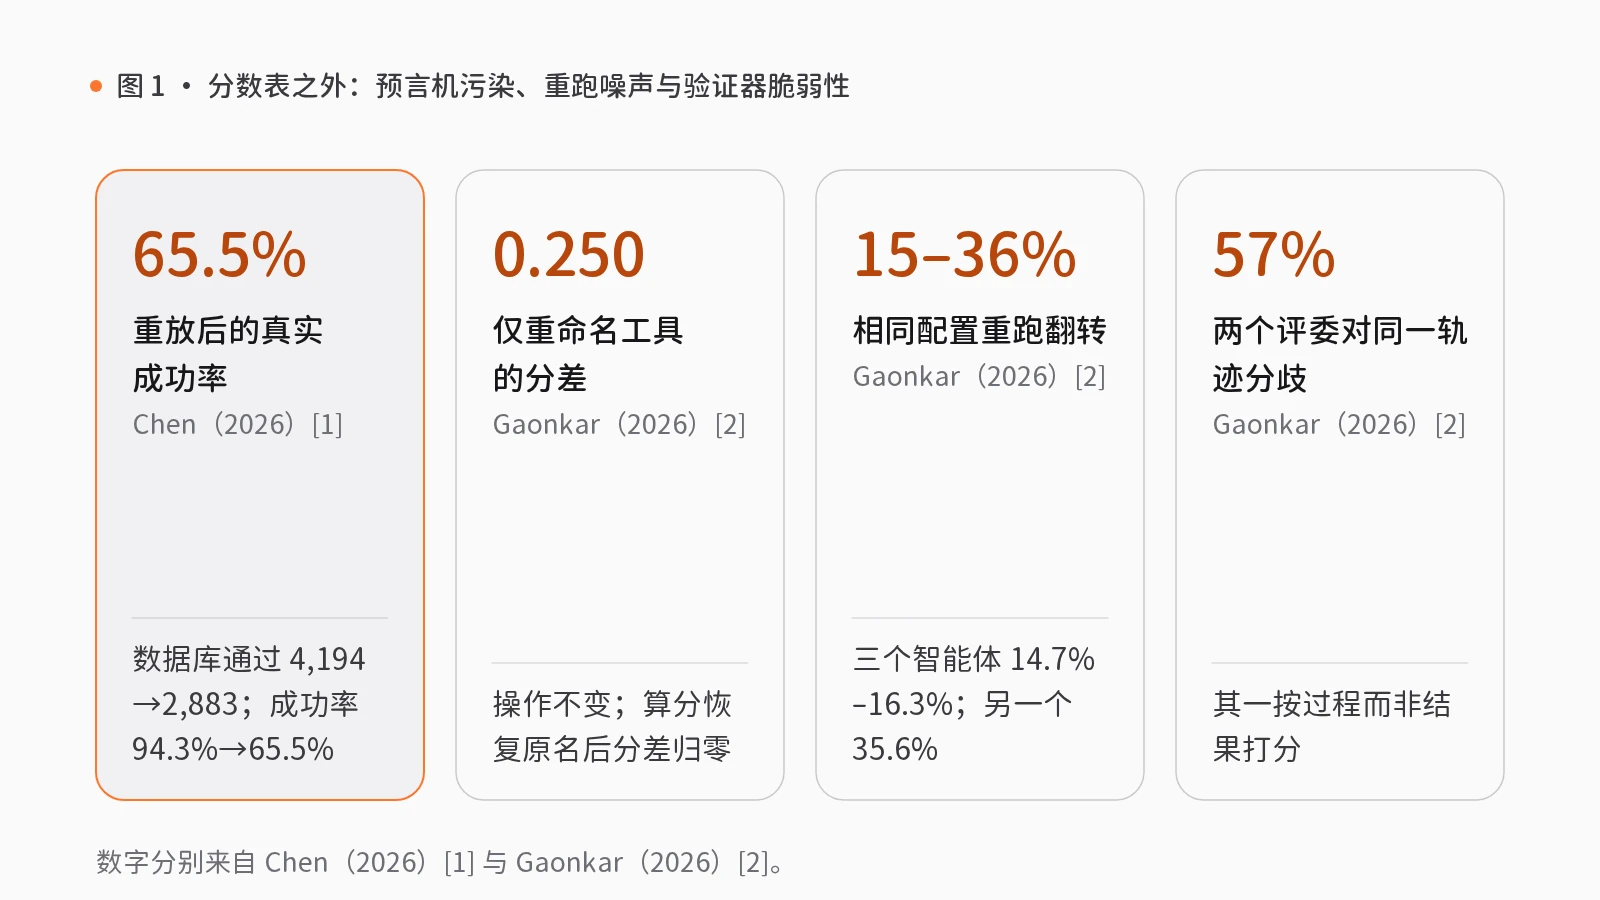
在公开 τ²-bench 跟进实验中,完全相同的重跑会使 15%–36% 的单任务结果翻转(三个智能体为 14.7%–16.3%,另一个达 35.6%),因此单次运行对比无法分离表述效应与重跑波动[2]。控制重复后,保持语义的工具重命名或观察格式调整在 8 组“智能体—变更”配对中的 7 组上使奖励变化保持在 ±0.10 以内,而误导性工具名则使所有智能体奖励下降 0.20–0.44[2]。同时,两个前沿大模型评委对同一批固定记录的判决分歧率达 57%(其一按过程而非结果评分),且控制重复后表层表述变化并未引起超出调用间波动的判决偏移[2]。
把评测夹具当成生产软件来验证:日志重放、状态断言与人工晋级闸门
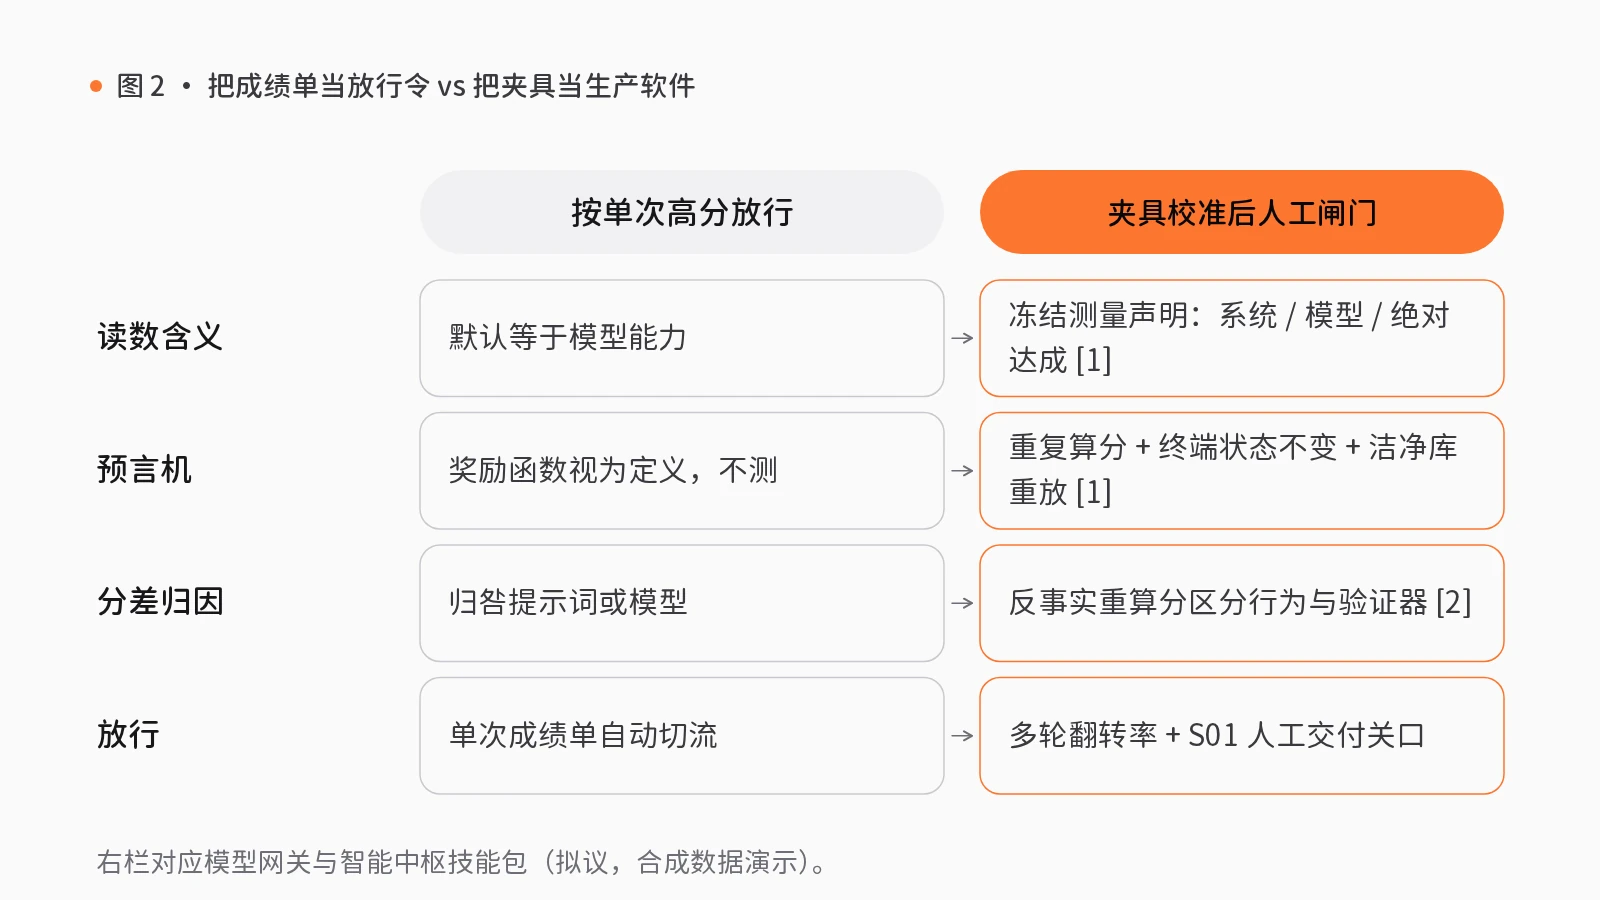
上述发现表明(以下架构映射与检验规则属于本团队的工程推演),企业应像对待生产软件一样对评测夹具执行持续集成校验。在 rlab.works 的模型网关(AI Gateway)与智能中枢(Agent OS)模块中,可通过三项技能包与核心组件落地这一机制:
第一,持久化调用事件以支持洁净库重放。借助可恢复的智能体运行时与上下文管理(可用组件),系统持久化保存工具调用事件、检查点与重放记录。评测流水线应对同一已完成回合执行重复算分,断言会话结束后终端状态稳定不变,并保留将工具调用日志在洁净数据库上独立重放的能力。
第二,冻结测量声明并量化重跑噪声。在模型网关模块中,技能包模型对比与切换(S12)与新服务试运行接入(S18)在企业服务中均为可迁移应用。适配边界上,模型对比与切换要求用真实样本校验兼容性,推荐依赖既有记录且不承诺自动选出最优模型,包含切换方案人工复核与切后抽样检查;新服务试运行接入要求分别检查节点心跳、应用响应与部署,不默认流式输出或自动重试,在注册、准备客户端与测试请求后设验收或驳回的人工关口。配合网关用量、财务、可靠性与集群分析(可用组件),团队应预先冻结分数所支持的声明(评估完整系统、比对模型或衡量绝对表现),在对比配置前要求多轮重复运行,并在成绩单旁并列汇报评测仪器失效率。
第三,以人工关口守住发布晋级边界。在智能中枢模块中,技能包复杂任务拆解与执行(S01)在制造业为可迁移应用,在其他场景作通用工作流模式。它在范围确认与交付复核处设人工关口,依托可审计工作流、人工确认与决策复盘(原型组件,可暂停等待人工决定并记录结果,工具步骤目前为占位与记录),在模型或路由依据评测证据晋级前由人工审阅并决定接受或驳回。
需说明边界:上述技能包均为基于合成数据演示的拟议编排,尚未接入真实生产服务,落地时仍需完成领域数据库快照与接口接线。
上线前的三项评测夹具校准核查
在依据基准分数批准模型切换或配置变更前,技术团队应执行三项核查(团队工程推演):
- 校验预言机状态不变量与洁净重放:对同一结束回合重复算分以断言终端状态未被篡改,运行已知答案对照测试,并确认工具调用日志可在洁净数据库上重放复核。
- 用反事实重算分剥离验证器脆弱性:当工具改名或格式微调引发得分下滑时,对未改变的操作轨迹执行恢复原名称的反事实重算分,区分模型行为退化与算分规则硬编码匹配。
- 固定测量声明、执行重复运行并经人工放行:拒绝单次跑分定胜负,要求在明确测量声明下提交多轮重复运行与仪器异常率报告,并在交付审批人工关口复核通过后方可执行切流。
觉得有用?分享给需要的人。
参考文献
- [1]
Chen, J. (2026). When Agent Evaluation Becomes Unreliable: An Empirical Study of Oracle Failures and Configuration-Dependent Measurement in an LLM Agent Benchmark (arXiv:2610.16067). arxiv.org ↗
- [2]
Gaonkar, R. (2026). TRACE: Diagnosing Verifier Brittleness in Agentic Evaluation (arXiv:2610.11678). arxiv.org ↗
- [3]
Yao, S., Shinn, N., Razavi, P., & Narasimhan, K. (2024). τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains (arXiv:2406.12045). arxiv.org ↗
相关能力
技能包
S12 · 模型网关
模型对比与切换
新模型不断推出,更换担心效果下降,不换又担心落后。
用同一批样例对比新旧模型的质量、错误与费用差异,再确定主用与备用模型。
- 检查可选模型
- 样例对比
- 审阅切换建议人工复核
- 设定主备模型
- 切换后抽查人工复核
5 步2 处人工复核7 个组件
S18 · 模型网关
新服务试运行接入
接入新服务时,配置一经修改便影响线上,出错后也缺乏回退方法。
先登记节点、配置调用方式,以少量请求试运行,确认无误后正式接入,否则回退。
- 登记服务节点
- 配置调用方式
- 少量试运行
- 接入或回退人工复核
4 步1 处人工复核5 个组件

S01 · 智能中枢
复杂任务拆解与执行
交由 AI 处理的复杂任务常中途停止或偏离目标,进度也无从查看。
先将目标拆解为有序的任务清单,经人工确认范围后执行,交付前再次验收。
- 拆解任务清单
- 确认执行范围人工复核
- 逐项执行
- 验收交付人工复核
4 步2 处人工复核7 个组件