多一个智能体,多一份把握?分工复核的漏检与误报交换
将文档复核拆给多个智能体分头把关,常被默认等同于更可靠的系统。最新受控实验表明,分工复核主要是在移动漏检与误报的工作点、消耗更多词元,且本身并不会自动降低推理过程中的幻觉;合理的上线评估必须以同等调用次数的单智能体为基线,在已知无缺陷样本上分开度量漏检与误报。

把清单拆给多个智能体,为何没有换来更省心的复核
在信贷备忘录核对、合同审查或交接单检验中,单智能体一次核对整张清单容易顾此失彼。常见建议是“把复核拆给几个智能体”,或搭一套反思、辩论与汇总拓扑;看到多智能体方案的任务得分上升,团队便以为系统更可信。但上线后可能出现另一种局面:人工复核被误报占满,或汇总报告的推理理由里仍夹带偏离原文的内容。
这一困境源于把“工作点漂移”误读为“能力净提升”。最新受控研究表明,拆分复核主要是在移动漏检与误报的工作点:它能多抓出部分隐蔽缺陷,但会引发更多误报、消耗更多词元,且本身并不会降低推理陈述中的幻觉。合理的评估必须固定并报告推理指令,在已知干净样本上把漏检与误报拆开计分,并与同调用次数的单智能体基线对比。
移动工作点与能力再分配:分工复核的实证拆解
为何增加智能体常难以兑现可靠性?Cemri 等人(2025)指出,多智能体系统在主流基准上的性能增益往往微乎其微[3]。他们汇集跨 7 个主流框架的 1600 多条标注轨迹,由专家在 150 条轨迹上归纳出涵盖系统设计问题、智能体间失配、任务核验 3 大类共 14 种失效模式的分类法[3]。我们的解读是:其中“智能体间失配”与“任务核验”两类,恰好对应分工复核中最容易出问题的交接与把关环节。
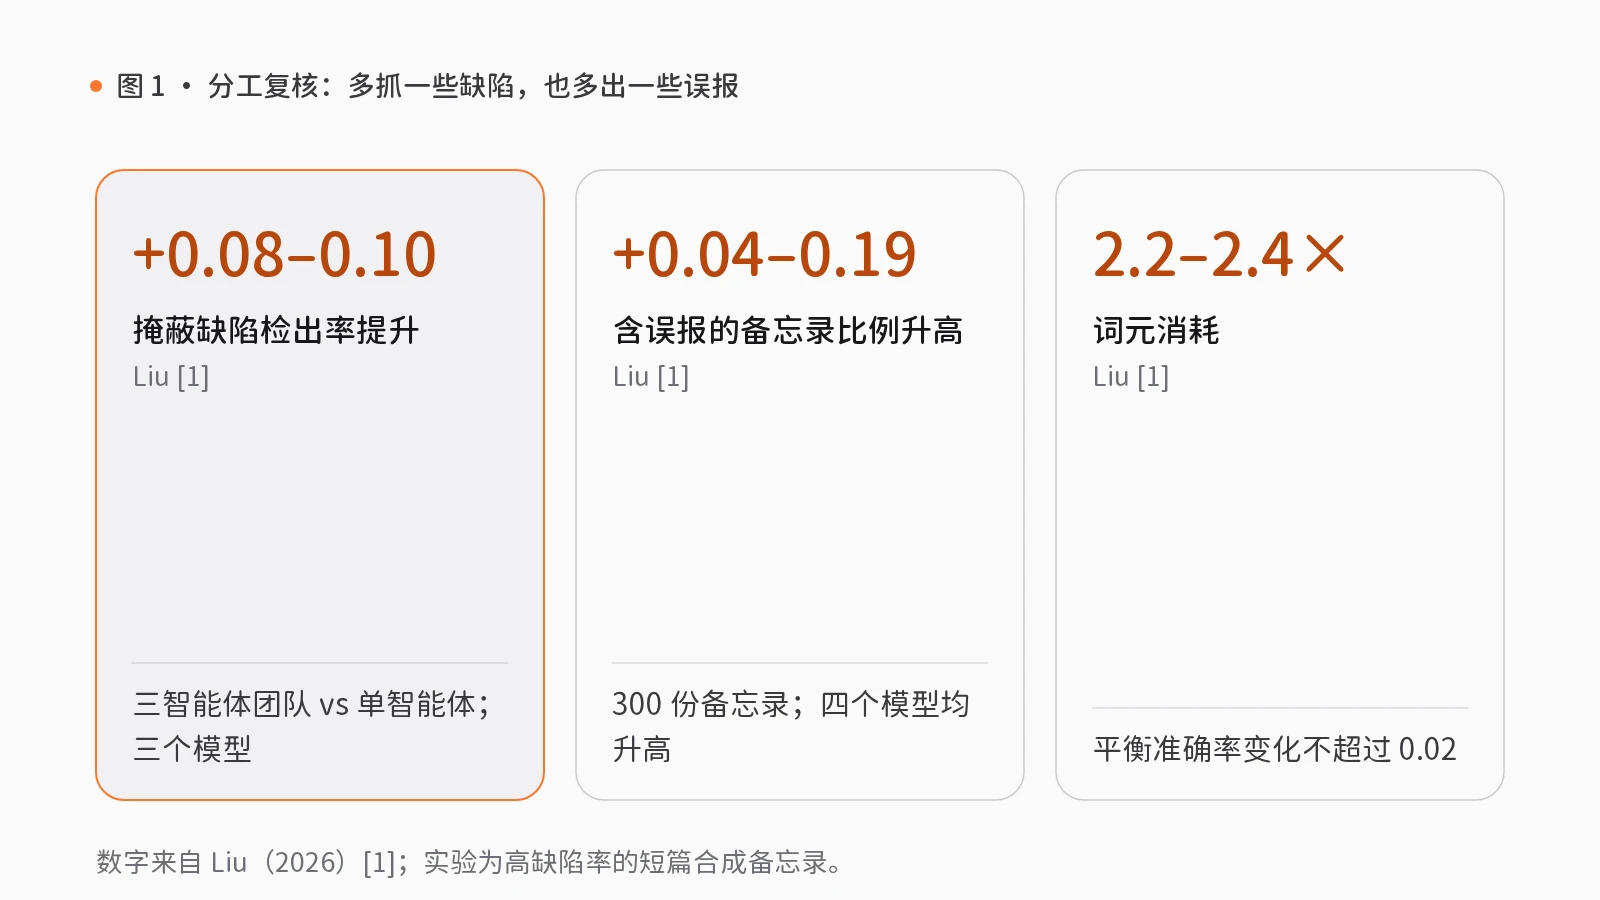
Liu(2026)通过受控金融复核实验剥离了“拆分”的净效应[1]。实验由公开信用卡数据集记录程序化生成 300 份合成信贷评估备忘录(各约 1100 词),对照 6 项书面要求形成 1800 个标注单元:1136 个干净、205 个裸露缺陷、229 个自带解释的掩蔽缺陷和 230 个算术缺陷,缺陷占 37%(远高于实际)[1]。材料与分析在运行前经提交哈希锁定,在四个模型上按多重检验校正水准测试两项主预测:单智能体一次调用查全部 6 项;同模型的三智能体团队审同一备忘录,各查 2 项,措辞相同,无角色设定,无后续阶段[1]。
在“每项要求决定一次”指令下,对单智能体有漏检的三个模型,团队在自带解释的掩蔽缺陷上多抓出 0.08 至 0.10(两个模型校正显著)[1]。但团队在四个模型上都引发更多误报(三个模型校正显著),300 份备忘录中至少含一次误报的比例在各模型上均升高 0.04 至 0.19[1]。探索性平衡准确率变化不超过 0.02,团队却用掉 2.2 至 2.4 倍词元;去掉该指令后,团队超出的误报在四个模型上都更大[1]。
引入反思与辩论拓扑能否减少推理幻觉?Jang、Joshi 与 Yu(2026)在四个模型和三项带金标的临床任务上,对比单模型基线与三种由聚合、反思、辩论模块构建并以聚合器收尾的多智能体拓扑;系统不接工具或检索,在推理依据内部按事实性与忠实度对原子声明计分[2]。结果显示,协作能换取任务性能,却不能作为通则降低幻觉,无一拓扑稳定更优[2]。在 36 组模型—系统—任务对比中,12 组变化足以分辨:4 组幻觉下降全来自同一模型,8 组上升分布在其余三个模型,无模型同时在两侧——决定幻觉水平与方向的是模型,而非拓扑或智能体数量[2]。将拓扑从 3 个智能体扩至 7 个影响甚微,仅替换聚合器模型却能让幻觉跨越大部分变化区间,系统落在其较强成员单独达到的水平附近[2]。自我纠错实验中,展示被标出的错误后,除一个模型外其余均降低幻觉;协作最能帮到的模型获益最大,受协作损害最重的模型毫无获益(与自我纠错机制一致,但非证明)[2]。作者总结:协作“只是重新分配了其模型本已具备的能力,并不能供应它们所不具备的能力”[2]。
把分工复核装进工程契约:范围约束、同预算基线与人工关口
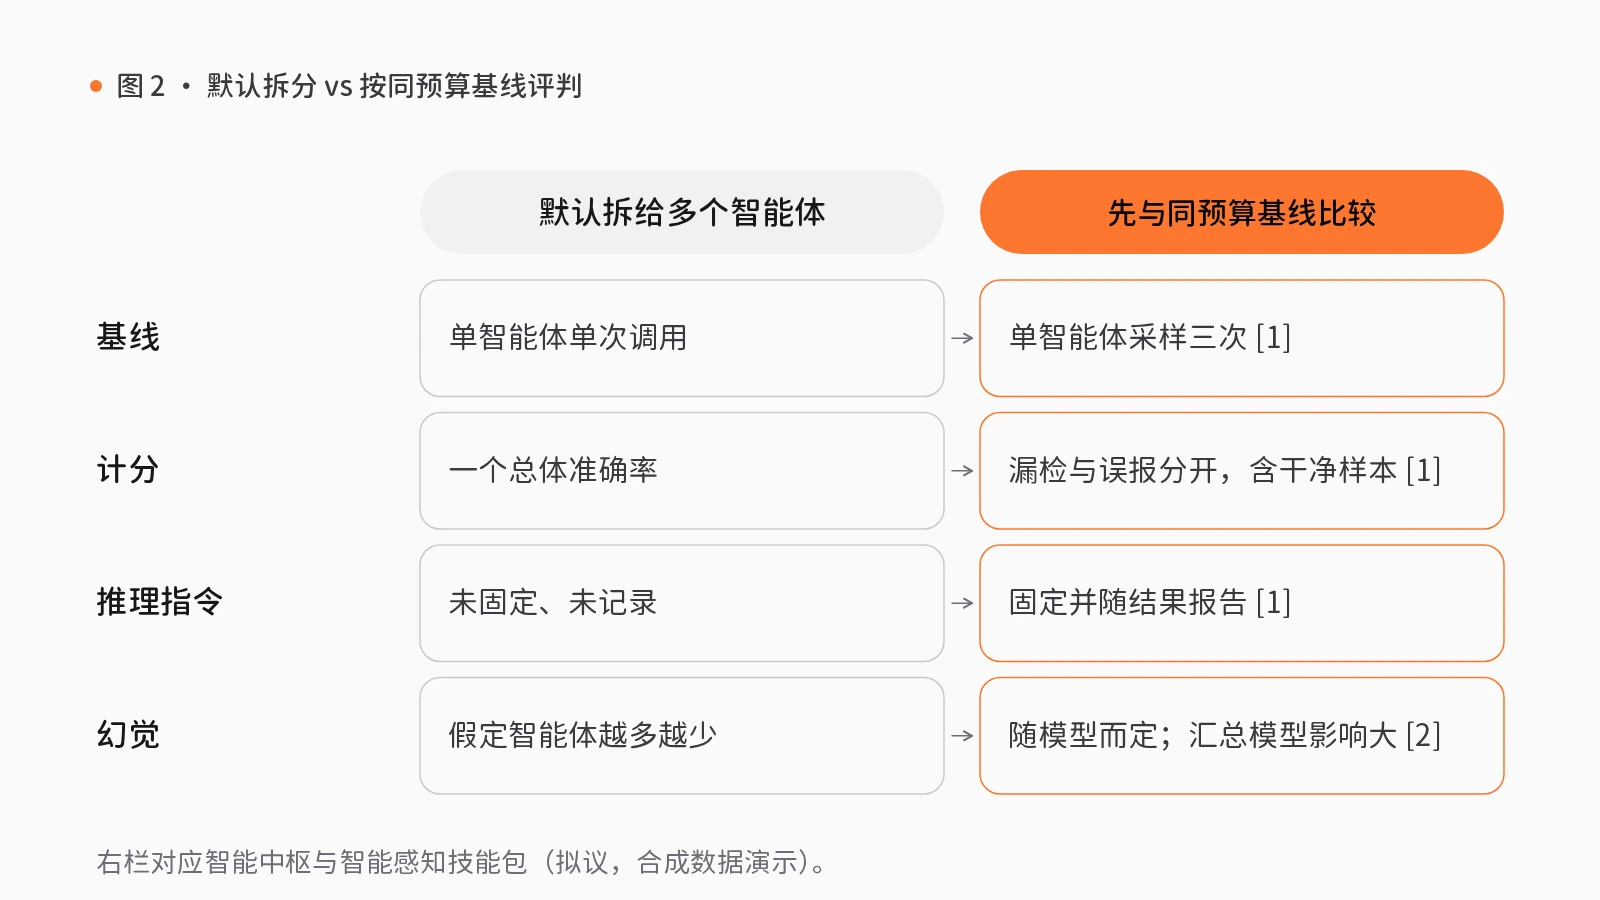
我们认为,工程团队在拆分复核前应建立含已知干净案例的标注集,按单元和文件分别报告漏检率与误报率;与同调用预算的单智能体(如三次抽样取任一或多数规则)对比;固定并记录推理指令;若拆分,向各子审阅器展示其他审阅器覆盖的范围,并要求每次报警绑定原文引句;按漏检与误报的业务成本及真实缺陷率决策,由人工关口掌握最终结论。
在 rlab.works 的智能中枢与智能感知模块中,可以用三项技能包与三项组件对照这一约束:
- 拆分审批与受限执行:智能中枢的复杂任务拆解与执行按“拆解任务清单 → 确认执行范围(人工关口) → 逐项执行 → 验收交付(人工关口)”运行,是决定是否拆分及如何评判的节点。它除通用模式外在制造业为可迁移应用,软件仅编排数字任务与交班记录,机械作业由人员按许可执行。底层由可用状态的持久目标、受限子智能体与定时任务限制子智能体能力范围、深度与并发,并由可用状态的协作交付、审批与证据门槛把关——证据门槛表达已配置要求,不保证业务成功。
- 金融证据备忘与裁决:智能感知的正反证据备忘按“收集证据 → 对齐实体 → 比较主张与反证 → 复核并保存备忘(人工关口)”运行,文献[1]的信贷备忘录核查与之类似但非站点案例。它在金融领域有源数据行业依据(仅表源数据标签关联,非真实部署),适配需对齐实体与时点定义,产出支持研究而非交易指令。底层由可用状态的投资论点证据与结论跟踪分离支持、挑战与复杂化因素,结论可人工覆写,编辑启发式并非财务预测。
- 多源法律报告核查:智能感知的研究报告撰写在法律领域为可迁移应用,需人工复核法律效力与判例适用性,不自动生成法律结论。
上述技能包均为合成数据演示的拟议编排,未接入生产服务;组件成熟度基于静态源码检查。
拆分复核工作流前的三项核查清单
上线多智能体分工复核前,架构与风控负责人应核查三点:
- 以同调用预算单智能体为基线,在干净样本上单列文件级误报率:在已知无缺陷样本上对比分工团队与单智能体多次采样的文件级误报率与掩蔽缺陷漏检率,按真实缺陷率核算期望成本。
- 固定推理指令并向子智能体展示排除范围:锁定并记录“每项要求决定一次”等指令;拆分时向各子智能体列出其余条款范围,要求每条标记绑定原文引句。
- 将算力投向聚合模型并保留人工终审关口:在所测设置中,堆叠智能体并未凭空消除推理幻觉,而替换汇总节点的模型影响更大[2];优先保障汇总节点的模型能力,由人工关口做最终裁决。
觉得有用?分享给需要的人。
参考文献
- [1]
Liu, P. (2026). The More the Better? A Comparison of Single- and Multi-Agent LLM Setups on a Financial Review Task (arXiv:2610.27488). arxiv.org ↗
- [2]
Jang, W. S., Joshi, H. B., & Yu, H. (2026). Does Multi-Agent Collaboration Reduce Hallucination in Clinical Tasks? (arXiv:2610.27027). arxiv.org ↗
- [3]
Cemri, M., Pan, M. Z., Yang, S., Agrawal, L. A., Chopra, B., Tiwari, R., Keutzer, K., Parameswaran, A., Klein, D., Ramchandran, K., Zaharia, M., Gonzalez, J. E., & Stoica, I. (2025). Why Do Multi-Agent LLM Systems Fail? (arXiv:2503.13657). arxiv.org ↗
相关能力
技能包

S01 · 智能中枢
复杂任务拆解与执行
交由 AI 处理的复杂任务常中途停止或偏离目标,进度也无从查看。
先将目标拆解为有序的任务清单,经人工确认范围后执行,交付前再次验收。
- 拆解任务清单
- 确认执行范围人工复核
- 逐项执行
- 验收交付人工复核
4 步2 处人工复核7 个组件
S25 · 智能感知
正反证据备忘
研究判断只记录结论,一段时间后难以说清当初的依据与反对意见。
将资料、论点与反证集中记录,标明支持、反对与存疑,经人工复核后存为可追溯的备忘。
- 收集证据
- 梳理对象与关系
- 对照正反证据
- 定稿备忘人工复核
4 步1 处人工复核8 个组件
S24 · 智能感知
研究报告撰写
撰写研究报告时,大量时间用于查找资料、核对引用,仍难以说清每句话的出处。
先拆解研究问题,收集材料并标注出处,撰写带引用的草稿,论据经人工核对后排版导出。
- 拆解问题与范围
- 收集材料
- 撰写引用草稿
- 核对论据人工复核
- 排版并导出
5 步1 处人工复核8 个组件