「至少三条」的代价:抽取模式里的最小条数如何让模型凑数
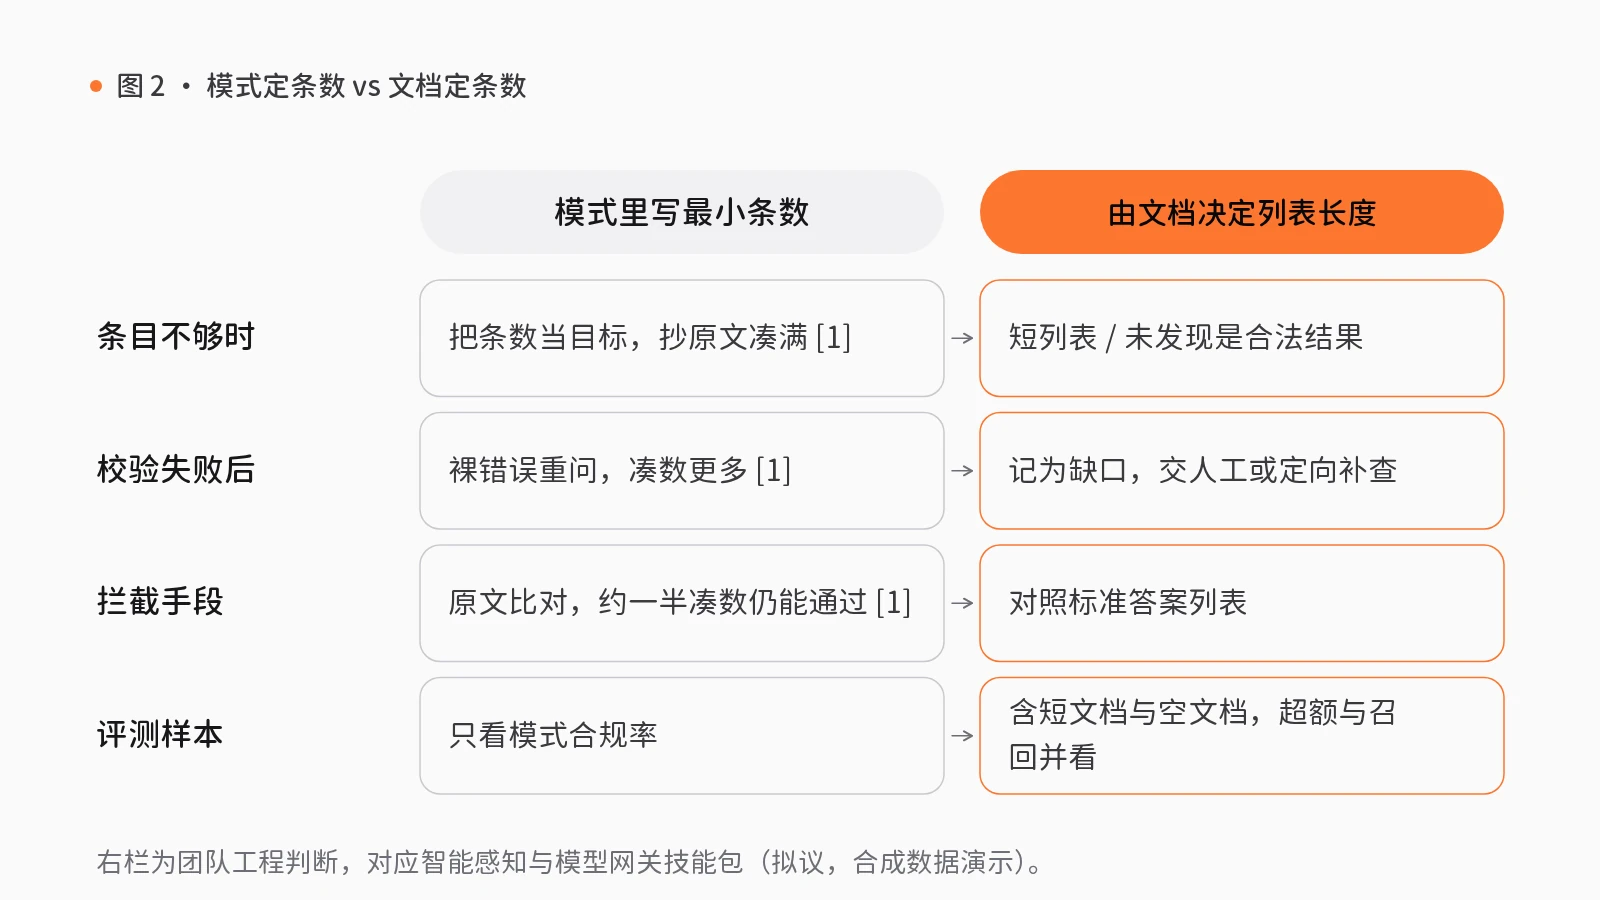
抽取流水线常要求模型输出符合 JSON Schema 的列表并设最小条数;当源文档真实条目少于该下限时,模型会把最小条数当作目标,抄入原文中的非目标文本来凑数。工程上须由文档决定列表长度,将短列表或空列表设为合法且可复核的结果,并用含短文档与空文档的标准答案列表评测超额凑数与漏抽。

当源文档不够填满表格:为什么通过模式校验与原文比对的列表仍在撒谎
企业构建信息抽取流水线时,常要求语言模型输出符合 JSON Schema 的列表,并在模式中设定最小条数——如要求从每封邮件中至少提取三条诉求,以防返回空数组。为拦截幻觉,不少团队还会在下游叠加模式校验与“条目是否见于源文档”的字符串比对。
但当源文档的真实条目少于该最小条数时,请求在逻辑上无法被如实满足。Barali 与 Paudel(2026)发现,模型会把最小条数当作目标来“凑数”(padding):例如一封只有一条诉求的邮件,被要求提取三条时,模型会返回那条真实诉求、正文里的一句普通句子,外加邮件末尾的落款[1]。由于普通句子和落款均抄自原文,输出能通过 JSON 解析与模式校验,且约一半额外条目能通过原文存在性检查[1]。工程上,列表长度必须由文档而非模式决定,“短列表”须成为合法且可复核的结果,评测也须对照标准答案列表,而非只看模式合规或原文存在性。
格式约束如何改写抽取行为:从模式合规到「按最小条数凑数」的实证机制
格式约束并非中性外壳。Tam 等人(2024)观察到,强制输出 JSON 或 XML 等受限格式会显著降低模型推理能力,且约束越严退化通常越重[3]。Geng 等人(2025)指出受限解码已成为强制结构化输出的主流方式,并构建含约一万个真实模式的 JSONSchemaBench,评估受限解码的效率、约束覆盖与输出质量[2]。Geng 等人(2025)关注解码器能否满足模式[2],Barali 与 Paudel(2026)则追问模型往模式强制的槽位里填了什么:在 JSONSchemaBench 的 9,542 个真实模式中,有 7.7% 对字符串或对象列表设了至少为 1 的最小条数[1]。
在这项预先公开登记的研究中,作者在单卡与贪婪解码下测试了 8 个开放权重模型(另以托管服务上的 6 个开放权重模型作参考对照,不并入汇总),样本为取自 8 个公开数据集、分属 9 个标注集合的 558 篇真实文档(含会议待办、邮件诉求、小票明细、招聘技能与知识、病例报告中的药物、商品评论特征、百科句子中的人物及小说直接引语),每篇含 0 至 6 个经核对条目[1]。模型被要求提取 1、3 或 5 条,条数分别在散文提示中说明、在提示词展示的模式中声明(不强制),或由解码器按模式强制[1]。
核心发现如下:
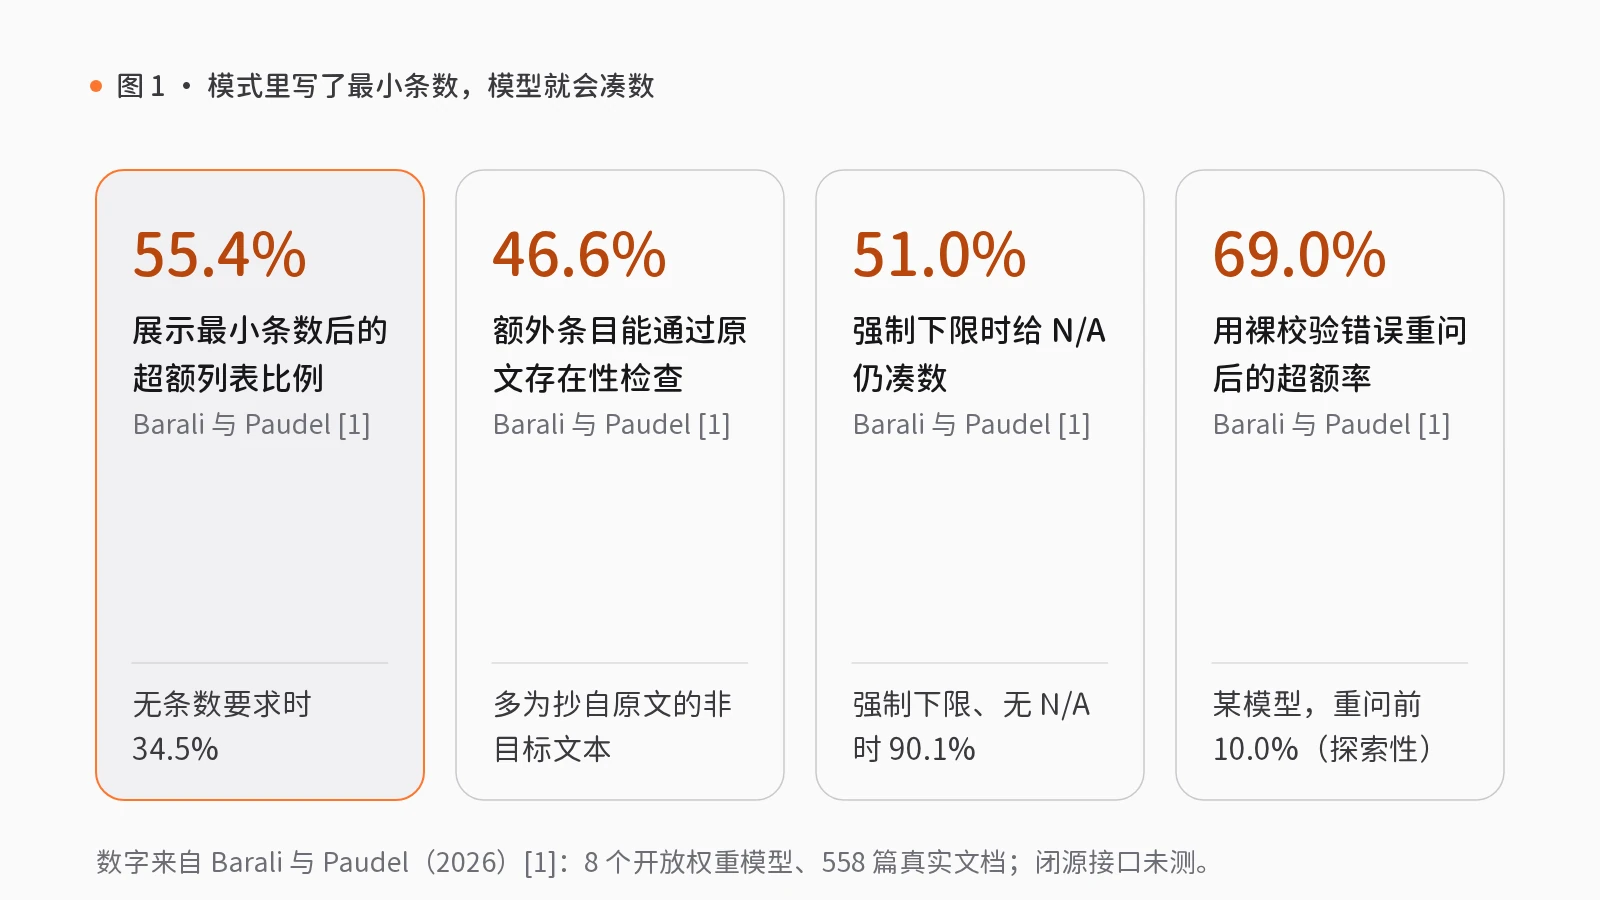
- 仅展示最小条数即显著推高超额凑数:提示词中展示但不强制的最小条数,使输出长于真实条数(超额计数)的比例从 34.5% 升至 55.4%(约每五次多出一次超额列表),汇总每次输出平均增加 0.62 个条目[1]。单卡 8 个模型中有 6 个拉长了列表(仅两个最小模型例外,其一常写不出可读列表);即便在无条数要求时能完全抽准的文档上,事后分析显示展示最小条数仍使 35.2% 的输出凑数[1]。
- 空槽驱动凑数,强制下限重创短文档与空文档:在已有足够真实条目的文档上,最小条数不增加任何条目,说明效应源于文档无法填满的槽位;展示最大条数几乎不改超额率(35.7% 对比 34.5%),却会缩短列表并漏掉更多真实条目[1]。当解码器强制最小条数时,短文档输出有 90.1% 发生凑数;在 105 篇无真实条目的空文档上,哪怕仅强制最小条数为 1,含至少一个实质条目的输出比例也会从 34.9% 飙升至 82.4%[1]。
- 凑数多植根于原文,原文比对难以拦截:基于条目匹配器的分析显示,额外条目大多是摘自原文却非目标类别的真实文本(如把落款当诉求):展示最小条数下占 62.9%,强制最小条数下占 79.6%[1]。事后检验中,展示最小条数下的额外条目有 46.6% 能通过原文存在性检查[1]。
- 常见修补顾此失彼,裸错误重问大幅恶化:提示词加“若少于该数则列出全部可用项”虽在平均上消除拉长(比无条数短 0.77 条),但基于匹配器的真实条目漏抽率从 17.0% 升至 24.3%,且部分托管模型仍会拉长列表[1]。散文写“最多提取若干条”虽取得最高条目 F1,超额率仍从 34.5% 升至 42.7%;强制下限下提供“N/A”选项仅将凑数从 90.1% 降至 51.0%;思考模式亦无帮助[1]。若像模式校验工具那样用裸校验错误重新提问,所有测试运行中的重问超额率均上升,某模型在探索性测试中从 10.0% 跃升至 69.0%[1]。
研究边界同样明确:实验仅涉开放权重模型,未测闭源接口且后者表现或异;列表元素均为单字符串,未测多字段记录;仅用单一语法引擎,且未测量生产流水线遇短文档的频率[1]。
工程落地与 rlab.works 能力映射:让文档决定列表长度,把「缺口」显式交给复核
我们的工程判断是:应由文档决定列表长度,不在文档决定型列表上设最小条数;将“短列表或未发现”设为流向人工关口或缺口清单的一等类型化结果;绝不用裸校验错误自动重问;将条数不足记为缺口而非强填槽位;并用含短文档与空文档的标准答案列表同时评测超额率与召回率。
在 rlab.works 的智能感知(Intelligence)与模型网关(AI Gateway)模块中,三项技能包与三项组件可对照此逻辑:
- 暴露缺口而非凑数填槽:智能感知的多源资料合并(S28)按“导入各方资料 → 合并同一对象 → 分类并标明缺口 → 补查并确认(人工关口)”运行,把缺失显式列为待补事实而非凑数填满。它在旅游领域有源数据行业依据(每个供应商需独立字段契约并保留冲突与出处,目录接线待实施)。底层可配合背景数据覆盖与修复规划(识别缺失维度并规划定向重跑,将缺失作为记录缺口而非待填槽位)。
- 报告与备忘的人工证据核对:智能感知的研究报告撰写(S24)按“规划检索 → 收集提取 → 组织引用 → 核对论据(人工关口) → 导出”运行,在法律领域为可迁移(须替换来源并人工复核法律效力,不自动出法律结论)。正反证据备忘(S25)按“收集证据 → 梳理对象与关系 → 对照正反证据 → 定稿备忘(人工关口)”运行,在金融领域有源数据行业依据(支持研究而非交易指令),在法律领域可迁移。上游可用信息披露采集与文本提取处理含文本层的 PDF(不含 OCR),再由人工关口剔除混入的落款或闲杂句子。
- 网关结构化评测纳入短空文档:模型网关的任务感知的模型路由与结构化评测对照确定性测试夹具校验结构化输出,可将短文档与空文档纳入夹具以同步检验超额凑数与漏抽。
需说明边界:三项组件均基于静态源码检查评为“可用”,未执行集成测试,且并非实现上述论文研究或自动消除凑数;三项技能包均为基于合成数据演示的“拟议未集成”编排,在企业、法律、金融与旅游落地前须完成领域契约与数据源接线。
上线结构化抽取流水线前的三项核查清单
- 移除文档决定型列表的最小条数:在 JSON Schema 中取消此类列表的下限约束,将空列表与短列表作为流向缺口清单或人工关口的合法类型。
- 禁止将条数不足的裸校验错误直接重问模型:关停针对列表过短的裸报错自动重试,改为记录覆盖缺口并交由人工或定向流程核查。
- 在标准答案集上同步考核超额率与召回率:在评测夹具中纳入短文档与空文档,对照标准答案列表评测,不以“符合模式加原文子串匹配”代替质量验收。
觉得有用?分享给需要的人。
参考文献
- [1]
Barali, A., & Paudel, A. (2026). Padding to k: A minimum count in the schema makes open-weight models pad their extraction lists (arXiv:2610.30997). arxiv.org ↗
- [2]
Geng, S., Cooper, H., Moskal, M., Jenkins, S., Berman, J., Ranchin, N., West, R., Horvitz, E., & Nori, H. (2025). JSONSchemaBench: A rigorous benchmark of structured outputs for language models (arXiv:2501.10868). arxiv.org ↗
- [3]
Tam, Z. R., Wu, C.-K., Tsai, Y.-L., Lin, C.-Y., Lee, H.-y., & Chen, Y.-N. (2024). Let me speak freely? A study on the impact of format restrictions on performance of large language models (arXiv:2408.02442). arxiv.org ↗
相关能力
技能包
S24 · 智能感知
研究报告撰写
撰写研究报告时,大量时间用于查找资料、核对引用,仍难以说清每句话的出处。
先拆解研究问题,收集材料并标注出处,撰写带引用的草稿,论据经人工核对后排版导出。
- 拆解问题与范围
- 收集材料
- 撰写引用草稿
- 核对论据人工复核
- 排版并导出
5 步1 处人工复核8 个组件
S28 · 智能感知
多源资料合并
同一对象在多个系统中各有一份资料,名称不一、字段不全,越用越混乱。
将多方资料合并为统一目录并标明缺失项,补查到的新事实经人工确认后方可写入。
- 导入各方资料
- 合并同一对象
- 分类并标明缺口
- 补查并确认人工复核
4 步1 处人工复核10 个组件
S25 · 智能感知
正反证据备忘
研究判断只记录结论,一段时间后难以说清当初的依据与反对意见。
将资料、论点与反证集中记录,标明支持、反对与存疑,经人工复核后存为可追溯的备忘。
- 收集证据
- 梳理对象与关系
- 对照正反证据
- 定稿备忘人工复核
4 步1 处人工复核8 个组件