强模型不必写每一步:把审稿放在会改环境的边界上
工具调用智能体若让昂贵的强模型逐字生成每一轮常规检索与读取,会在解码阶段消耗大量显存带宽、端到端时延与远端输出令牌。将工具划分为可逆只读与会改变外部状态的写入,让弱模型连续起草并执行只读步骤、在首个写入边界前挂起,由强模型单次预填充做语义级审阅与局部修复,可在保持任务质量的同时显著压缩强模型解码开销。

为什么让强模型写出每一次常规查询,正在拖垮多步智能体
企业部署多步工具调用智能体时,常为保证决策准确率,将整条轨迹全部交由最昂贵的强模型逐步生成。但拆解客服售后、工单处理或文档核验轨迹就会发现,绝大多数轮次都在执行无副作用的常规读取——查订单、列目录、检索条款或核对字段;真正改变外部状态的动作(如提交改签、修改账户、发送外部通知或写入业务表)只占少数节点。
若让强模型逐字解码每一步常规查询,系统既要为低风险步骤支付高额远端输出令牌费用,又会在解码阶段反复搬运模型权重,造成显存带宽瓶颈与时延。反之,若将整条任务直接交给弱模型,一旦在关键规则或状态写入上失误,又会引发质量滑坡。
破局的关键是将“起草轨迹”与“提交副作用”解耦:把工具分为可逆只读与不可逆写入;让弱模型连续推进只读收集,把昂贵的强模型审阅放在会改变环境状态的写入边界上。
从令牌级推测到轨迹级语义审阅:在写入边界拦截与提交
降低大模型推理开销通常沿两条路径演进,但直接用于多步工具智能体均有局限。
第一条是 Leviathan、Kalman 与 Matias(2023)提出的推测解码:小模型起草候选令牌,大模型在单次前向计算中并行核验,并在保持大模型输出分布的前提下接受前缀[2]。但多步工具智能体需与环境交互,同一目标存在多种等价的查询顺序与措辞;若强求弱模型与强模型逐字或动作完全一致,大量合理的只读探索会被推翻。第二条是 Chen、Zaharia 与 Zou(2024)在 FrugalGPT 中探讨的任务级级联与路由:按整条查询挑选单个模型来完成请求[3]。但单条轨迹内部存在步间异质性,整单选型无法在一条轨迹内实现“读取用弱模型、提交用强模型”的分段协作。
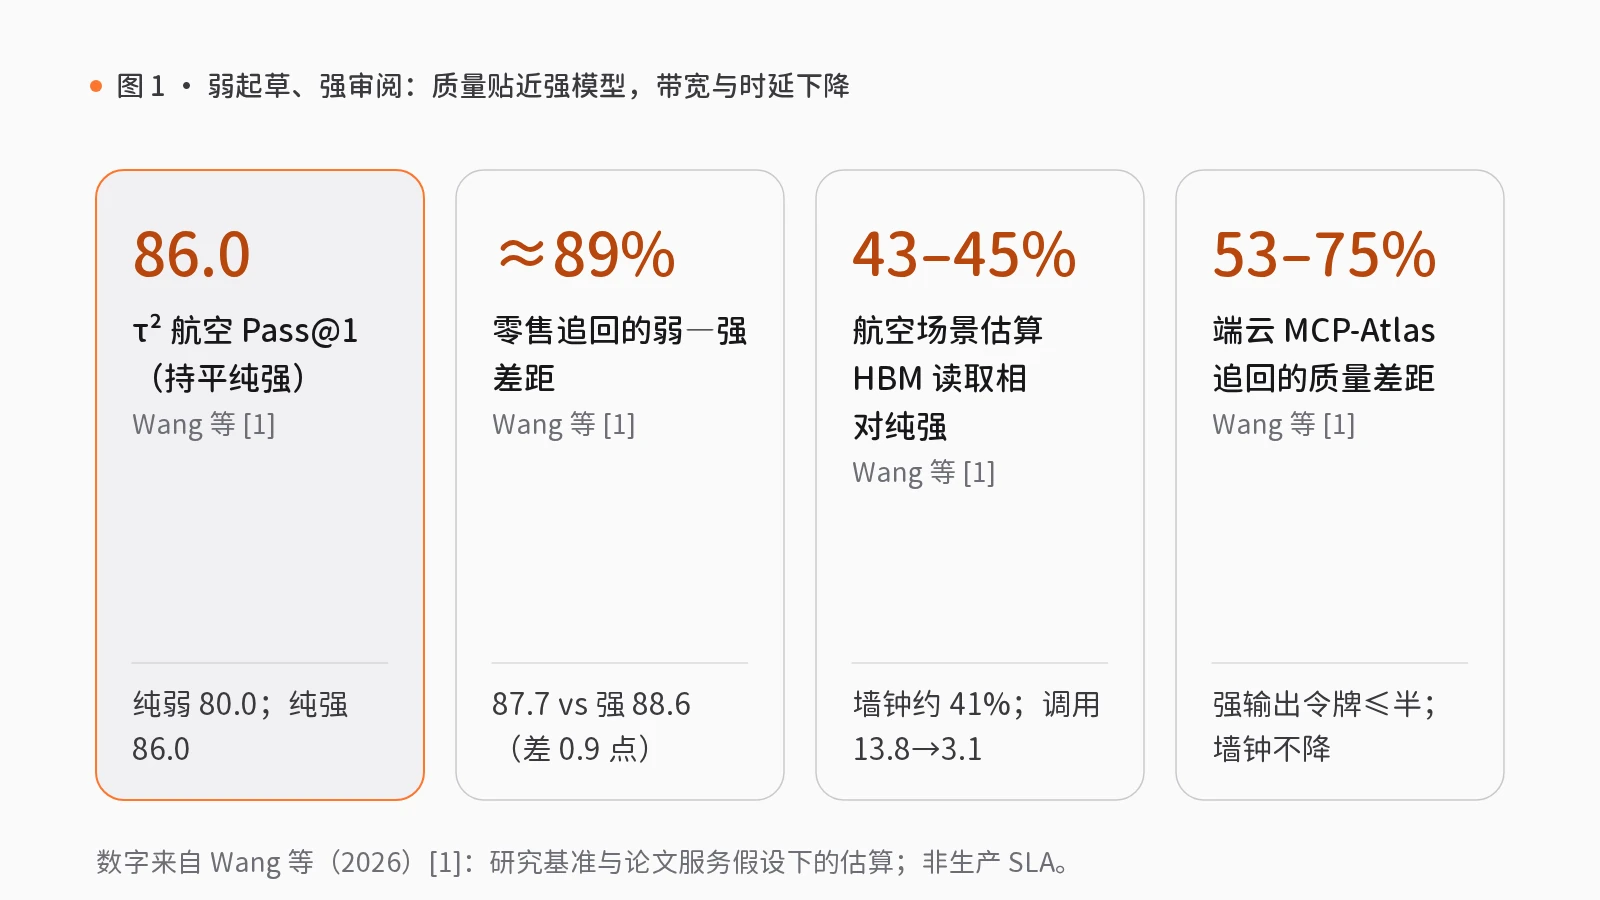
针对这一矛盾,Wang 等人(2026)提出面向工具调用智能体的轨迹级推测与语义核验框架 SpecAgent[1]。其协议在单条轨迹内重塑了弱强分工:弱模型以有界分块(如在 τ² 与 VitaBench 上 K=6 步,在 AutomationBench 上 K=8 步)向前起草;遇到只读工具调用时立即执行并获取真实环境反馈;一旦遇到首个改变外部状态的写入动作(或达分块上限),立即挂起该动作而不执行[1]。随后,强模型在单次预填充前向过程中批量审阅这段挂载真实观察的草稿,返回四元组(可接受的最长前缀步数 j、理由及可选替换动作),系统据此提交最长语义有效前缀,对首个被拒步骤优先做融合修复,无法融合时才执行一次强模型修复轮次[1]。
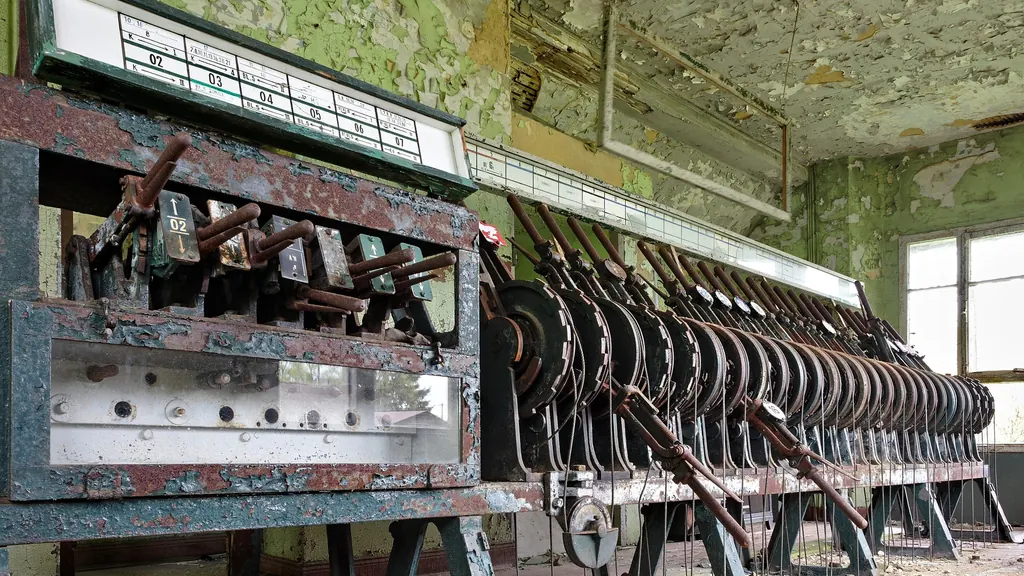
这里的收益源于用计算密集的预填充替代受限于显存带宽的强模型解码。在模拟用户与工具环境的基准评测中(Pass@1),SpecAgent 表现出清晰的质量与资源特征[1]:
- 质量保持与差距追回:在 τ² 航空基准上,SpecAgent 取得 86.0 的 Pass@1,与纯强模型(86.0)持平并高于纯弱模型(80.0);在 τ² 零售基准上达 87.7,距纯强模型(88.6)仅差 0.9 个百分点,追回纯弱模型(80.4)与强模型间约 89% 的质量差距;在 AutomationBench(弱模型 6.8、强模型 15.2、SpecAgent 10.5)与 VitaBench 外卖场景(弱模型 34.0、强模型 48.0、SpecAgent 44.5)上,分别追回 44% 与 75% 的差距[1]。
- 访存与时延下降,但算术运算量上升:在 τ² 上每条轨迹的强模型调用次数大幅下降(如航空场景从 13.8 次降至 3.1 次);对比纯强模型,航空场景估算高带宽显存读取降至 43%–45%,墙钟时间降至约 41%(126.2 秒对比 305.2 秒);零售场景 HBM 读取降至 53%–57%,墙钟时间降至约 54%(87.5 秒对比 162.4 秒);AutomationBench 与 VitaBench 的 HBM 读取分别降至 78%–84% 与 59%–65%,墙钟时间分别降至约 57% 与约 69%[1]。但四个评测块的估算浮点运算量反而上升 30%、38%、38% 与 87%——节省来自解码与显存带宽,而非算术运算量[1]。
- 端云协同表现:在连接真实 MCP 服务器的 101 个公开任务、三种不同强模型后端上,SpecAgent 追回 53%–75% 的弱强质量差距,强模型输出令牌降至纯强模型的至多一半(36%–50%),接口成本降至 59%–81%;但因本地弱模型与远端强模型时延相近,该部署下墙钟时间并未下降[1]。
零售基准消融实验进一步证实:若对包含只读在内的每个分块都做审阅,或将回复也一并挂起,强模型调用会增至三倍以上,HBM 读取甚至反超纯强模型;同理,让强模型充当主执行者或频繁升级的协作基线,往往比纯强模型消耗更多强模型调用[1]。此外,若将验收标准从“语义合理”收紧为“精确匹配(只保留强模型自己会做出的完全相同动作)”,零售 Pass@1 会跌至 82.5 且 FLOPs 增加约 70%——唯有语义验收才能保住弱模型的有效探索[1]。同时需说明:上述结果均基于模拟用户或受控 MCP 基准及论文服务假设下的资源估算,不构成生产环境 SLA 承诺[1]。
工程落地与 rlab.works 能力映射:工具读写分级、受控边界与工作点评测
我们的工程判断是,将上述机制转化为企业架构需落实五项准则:将工具盘点为可逆只读与不可逆写入;允许弱模型执行可逆只读收集;在不可逆写入前强制由强模型或人工提交确认;优先采用语义验收而非重生成每一步;在任务质量与强模型令牌/时延工作点上综合评估策略。
在 rlab.works 的智能中枢与模型网关模块中,可用三项组合技能包与三项组件对照这一设计:
- 在外部动作与案卷修改前设立挂起关口:智能中枢的经审批的电脑操作(S03)按“准备账号与登录 → 审批操作清单(人工关口) → 执行并截图 → 检查改动(人工关口)”运行,对应“只读先查、状态改变动作挂起待审”。该包在法律行业为可迁移应用,要求显式圈定读写目录,并将对外提交排除在默认权限之外。
- 把复杂工作流拆分为受控收集与审批交付:智能中枢的复杂任务拆解与执行(S01)通过“拆解任务清单 → 确认执行范围(人工关口) → 逐项执行 → 验收交付(人工关口)”推进任务,底层配合持久化受控智能体执行(提供受控执行循环)与沙箱化智能体任务与产物(在产生生产副作用前于隔离沙箱内运行作业)。在制造业中该包为可迁移模式:软件只编排任务与人工交班记录,物理维修仍由人员执行,须配置作业许可与确认点。
- 用真实样本评测强弱分工的工作点:模型网关的模型对比与切换(S12)按“检查可选模型 → 样例对比 → 审阅切换建议(人工关口) → 设定主备模型 → 切换后抽查(人工关口)”运行,配合任务感知的模型路由与结构化评测在结构化夹具上对比路由与成本质量工作点。该包在企业服务中为可迁移应用,要求用真实样本验证,不作自动最优模型承诺。
需如实说明适配边界:站点所有技能包均为“拟议未集成”编排,仅以合成数据演示;三项组件(持久化受控智能体执行与任务感知的模型路由与结构化评测经静态源码检查评为“可用”,沙箱化智能体任务与产物为“原型”)并未实现 SpecAgent 协议,仅提供受控执行、沙箱与路由评测基础。
上线多步工具智能体前的三项架构自检清单
架构与技术负责人在落地前可执行三项核查:
- 工具目录是否完成读写分级? 将无副作用查询与修改记录、触发外部接口等写入严格分离,使运行时能在首个写入动作处自动挂起。
- 高成本审阅是否放在写入边界而非每一步? 允许轻量模型连续完成只读取证,仅在跨越写入边界或达分块上限时触发强模型或人工审阅。
- 验收与评测是否兼顾语义有效性与多维工作点? 按目标与约束达成度做语义验收,并同步监控成功率、强模型输出令牌、显存带宽与时延。
觉得有用?分享给需要的人。
参考文献
- [1]
Wang, Z., Liu, Y., Chen, C., Liu, Q., & Guo, Z. (2026). Trajectory-level speculation with semantic verification for tool-using agents (arXiv:2610.21463). arxiv.org ↗
- [2]
Leviathan, Y., Kalman, M., & Matias, Y. (2023). Fast inference from transformers via speculative decoding. In *ICML 2023*. arxiv.org ↗
- [3]
Chen, L., Zaharia, M., & Zou, J. (2024). FrugalGPT: How to use large language models while reducing cost and improving performance. *TMLR*. arxiv.org ↗
相关能力
技能包

S01 · 智能中枢
复杂任务拆解与执行
交由 AI 处理的复杂任务常中途停止或偏离目标,进度也无从查看。
先将目标拆解为有序的任务清单,经人工确认范围后执行,交付前再次验收。
- 拆解任务清单
- 确认执行范围人工复核
- 逐项执行
- 验收交付人工复核
4 步2 处人工复核7 个组件

S03 · 智能中枢
经审批的电脑操作
后台录入、填表、修改文件等重复操作希望交由 AI 执行,又担心误操作。
AI 先列出操作位置与修改内容,经批准后执行;每一步均保留截图与改动记录。
- 准备账号与登录
- 审批操作清单人工复核
- 执行并截图
- 检查改动人工复核
4 步2 处人工复核8 个组件
S12 · 模型网关
模型对比与切换
新模型不断推出,更换担心效果下降,不换又担心落后。
用同一批样例对比新旧模型的质量、错误与费用差异,再确定主用与备用模型。
- 检查可选模型
- 样例对比
- 审阅切换建议人工复核
- 设定主备模型
- 切换后抽查人工复核
5 步2 处人工复核7 个组件