強模型不必寫每一步:把審稿放在會改環境的邊界上
工具調用智能體若讓昂貴的強模型逐字生成每一輪常規檢索與讀取,會在解碼階段消耗大量顯存帶寬、端到端時延與遠端輸出令牌。將工具劃分為可逆只讀與會改變外部狀態的寫入,讓弱模型連續起草並執行只讀步驟、在首個寫入邊界前掛起,由強模型單次預填充做語義級審閲與局部修復,可在保持任務質素的同時顯著壓縮強模型解碼開銷。

為什麼讓強模型寫出每一次常規查詢,正在拖垮多步智能體
企業部署多步工具調用智能體時,常為保證決策準確率,將整條軌跡全部交由最昂貴的強模型逐步生成。但拆解客服售後、工單處理或文檔核驗軌跡就會發現,絕大多數輪次都在執行無副作用的常規讀取——查訂單、列目錄、檢索條款或核對欄位;真正改變外部狀態的動作(如提交改簽、修改帳戶、發送外部通知或寫入業務表)只佔少數節點。
若讓強模型逐字解碼每一步常規查詢,系統既要為低風險步驟支付高額遠端輸出令牌費用,又會在解碼階段反覆搬運模型權重,造成顯存帶寬瓶頸與時延。反之,若將整條任務直接交給弱模型,一旦在關鍵規則或狀態寫入上失誤,又會引發質素滑坡。
破局的關鍵是將「起草軌跡」與「提交副作用」解耦:把工具分為可逆只讀與不可逆寫入;讓弱模型連續推進只讀收集,把昂貴的強模型審閲放在會改變環境狀態的寫入邊界上。
從令牌級推測到軌跡級語義審閲:在寫入邊界攔截與提交
降低大模型推理開銷通常沿兩條路徑演進,但直接用於多步工具智能體均有侷限。
第一條是 Leviathan、Kalman 與 Matias(2023)提出的推測解碼:小模型起草候選令牌,大模型在單次前向計算中並行核驗,並在保持大模型輸出分佈的前提下接受前綴[2]。但多步工具智能體需與環境交互,同一目標存在多種等價的查詢順序與措辭;若強求弱模型與強模型逐字或動作完全一致,大量合理的只讀探索會被推翻。第二條是 Chen、Zaharia 與 Zou(2024)在 FrugalGPT 中探討的任務級級聯與路由:按整條查詢挑選單個模型來完成請求[3]。但單條軌跡內部存在步間異質性,整單選型無法在一條軌跡內實現「讀取用弱模型、提交用強模型」的分段協作。
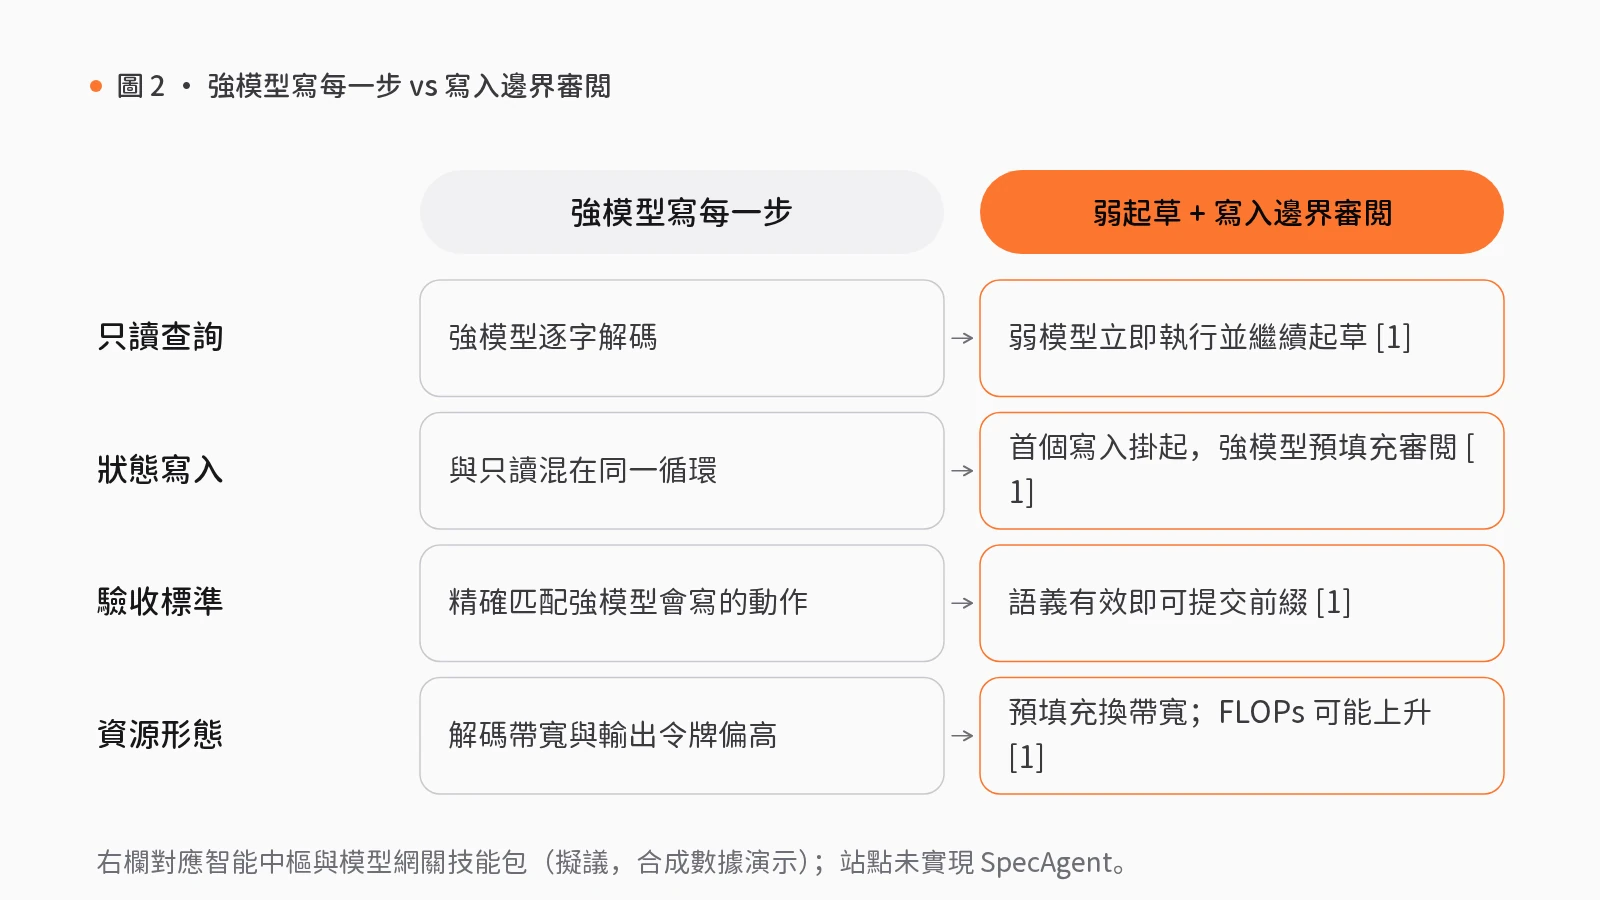
針對這一矛盾,Wang 等人(2026)提出面向工具調用智能體的軌跡級推測與語義核驗框架 SpecAgent[1]。其協議在單條軌跡內重塑了弱強分工:弱模型以有界分塊(如在 τ² 與 VitaBench 上 K=6 步,在 AutomationBench 上 K=8 步)向前起草;遇到只讀工具調用時立即執行並獲取真實環境反饋;一旦遇到首個改變外部狀態的寫入動作(或達分塊上限),立即掛起該動作而不執行[1]。隨後,強模型在單次預填充前向過程中批量審閲這段掛載真實觀察的草稿,返回四元組(可接受的最長前綴步數 j、理由及可選替換動作),系統據此提交最長語義有效前綴,對首個被拒步驟優先做融合修復,無法融合時才執行一次強模型修復輪次[1]。
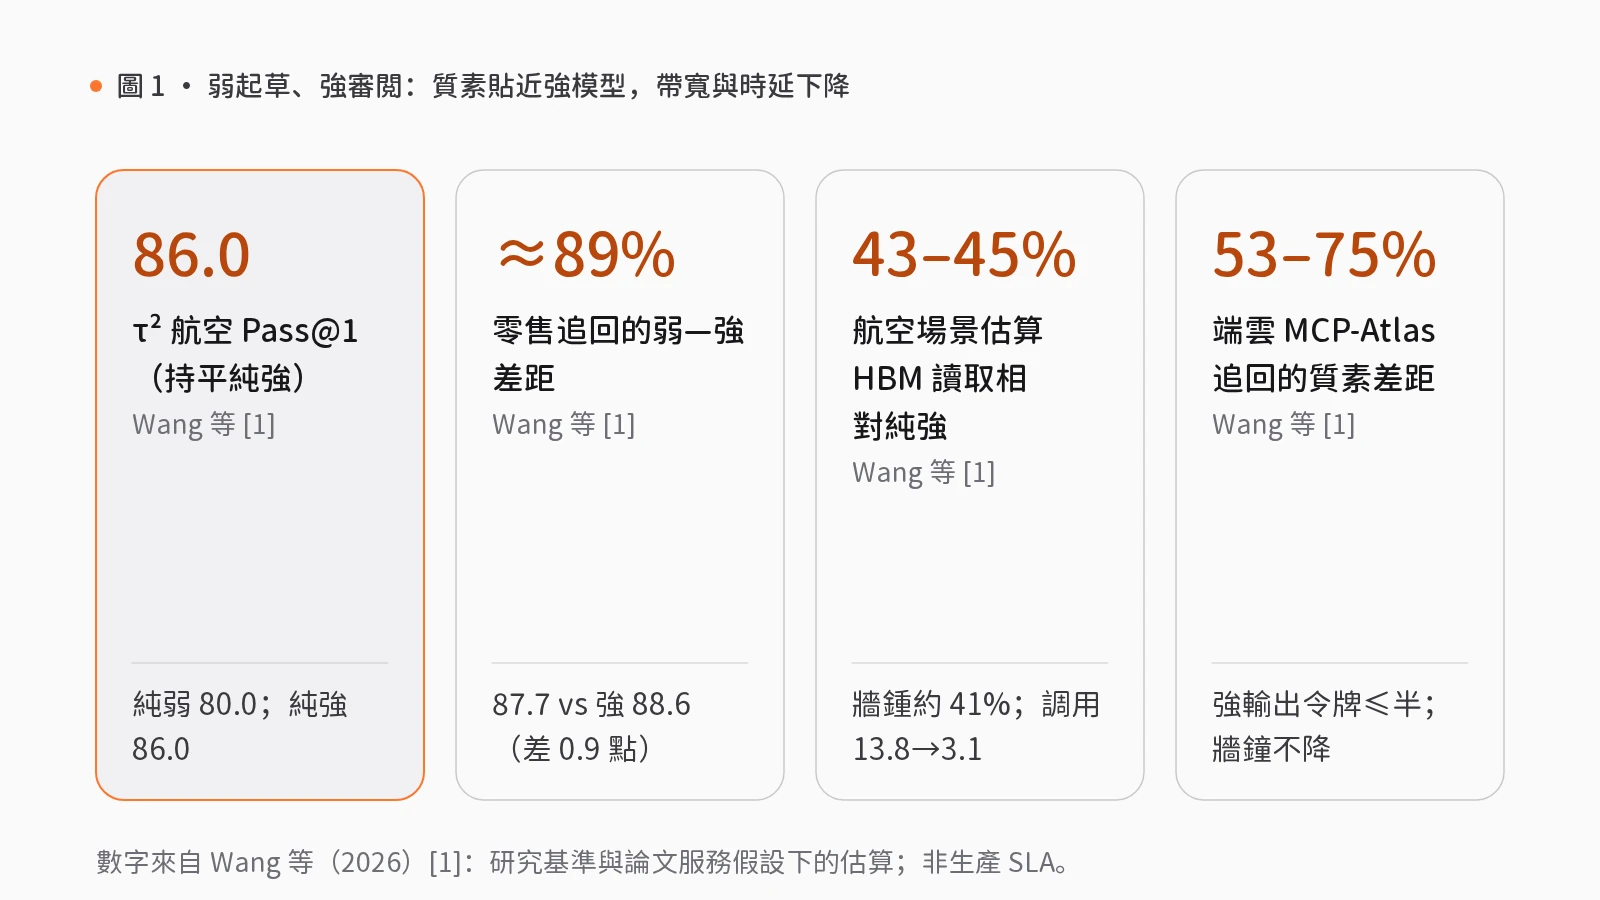
這裏的收益源於用計算密集的預填充替代受限於顯存帶寬的強模型解碼。在模擬用戶與工具環境的基準評測中(Pass@1),SpecAgent 表現出清晰的質素與資源特徵[1]:
- 質素保持與差距追回:在 τ² 航空基準上,SpecAgent 取得 86.0 的 Pass@1,與純強模型(86.0)持平並高於純弱模型(80.0);在 τ² 零售基準上達 87.7,距純強模型(88.6)僅差 0.9 個百分點,追回純弱模型(80.4)與強模型間約 89% 的質素差距;在 AutomationBench(弱模型 6.8、強模型 15.2、SpecAgent 10.5)與 VitaBench 外賣場景(弱模型 34.0、強模型 48.0、SpecAgent 44.5)上,分別追回 44% 與 75% 的差距[1]。
- 訪存與時延下降,但算術運算量上升:在 τ² 上每條軌跡的強模型調用次數大幅下降(如航空場景從 13.8 次降至 3.1 次);對比純強模型,航空場景估算高帶寬顯存讀取降至 43%–45%,牆鍾時間降至約 41%(126.2 秒對比 305.2 秒);零售場景 HBM 讀取降至 53%–57%,牆鍾時間降至約 54%(87.5 秒對比 162.4 秒);AutomationBench 與 VitaBench 的 HBM 讀取分別降至 78%–84% 與 59%–65%,牆鍾時間分別降至約 57% 與約 69%[1]。但四個評測塊的估算浮點運算量反而上升 30%、38%、38% 與 87%——節省來自解碼與顯存帶寬,而非算術運算量[1]。
- 端雲協同表現:在連接真實 MCP 伺服器的 101 個公開任務、三種不同強模型後端上,SpecAgent 追回 53%–75% 的弱強質素差距,強模型輸出令牌降至純強模型的至多一半(36%–50%),接口成本降至 59%–81%;但因本地弱模型與遠端強模型時延相近,該部署下牆鍾時間並未下降[1]。
零售基準消融實驗進一步證實:若對包含只讀在內的每個分塊都做審閲,或將回復也一並掛起,強模型調用會增至三倍以上,HBM 讀取甚至反超純強模型;同理,讓強模型充當主執行者或頻繁升級的協作基線,往往比純強模型消耗更多強模型調用[1]。此外,若將驗收標準從「語義合理」收緊為「精確匹配(只保留強模型自己會做出的完全相同動作)」,零售 Pass@1 會跌至 82.5 且 FLOPs 增加約 70%——唯有語義驗收才能保住弱模型的有效探索[1]。同時需説明:上述結果均基於模擬用戶或受控 MCP 基準及論文服務假設下的資源估算,不構成生產環境 SLA 承諾[1]。
工程落地與 rlab.works 能力映射:工具讀寫分級、受控邊界與工作點評測
我們的工程判斷是,將上述機制轉化為企業架構需落實五項準則:將工具盤點為可逆只讀與不可逆寫入;允許弱模型執行可逆只讀收集;在不可逆寫入前強制由強模型或人工提交確認;優先採用語義驗收而非重生成每一步;在任務質素與強模型令牌/時延工作點上綜合評估策略。
在 rlab.works 的智能中樞與模型網關模組中,可用三項組合技能包與三項組件對照這一設計:
- 在外部動作與案卷修改前設立掛起關口:智能中樞的經審批的電腦操作(S03)按「準備帳戶與登入 → 審批操作清單(人工關口) → 執行並截圖 → 檢查改動(人工關口)」運行,對應「只讀先查、狀態改變動作掛起待審」。該包在法律行業為可遷移應用,要求顯式圈定讀寫目錄,並將對外提交排除在預設權限之外。
- 把複雜工作流拆分為受控收集與審批交付:智能中樞的複雜任務拆解與執行(S01)通過「拆解任務清單 → 確認執行範圍(人工關口) → 逐項執行 → 驗收交付(人工關口)」推進任務,底層配合持久化受控智能體執行(提供受控執行循環)與沙箱化智能體任務與產物(在產生生產副作用前於隔離沙箱內運行作業)。在製造業中該包為可遷移模式:軟件只編排任務與人工交班記錄,物理維修仍由人員執行,須配置作業許可與確認點。
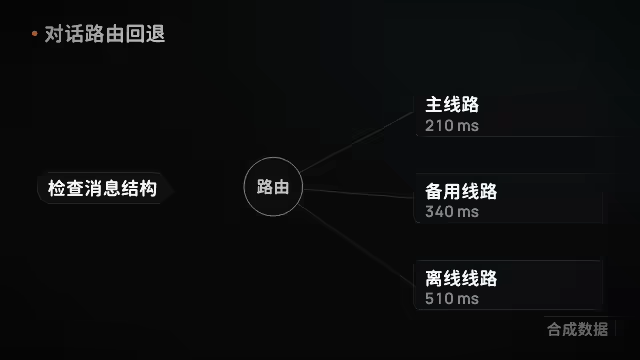
- 用真實樣本評測強弱分工的工作點:模型網關的模型對比與切換(S12)按「檢查可選模型 → 樣例對比 → 審閲切換建議(人工關口) → 設定主備模型 → 切換後抽查(人工關口)」運行,配合任務感知的模型路由與結構化評測在結構化夾具上對比路由與成本質素工作點。該包在企業服務中為可遷移應用,要求用真實樣本驗證,不作自動最優模型承諾。
需如實説明適配邊界:站點所有技能包均為「擬議未集成」編排,僅以合成數據演示;三項組件(持久化受控智能體執行與任務感知的模型路由與結構化評測經靜態源碼檢查評為「可用」,沙箱化智能體任務與產物為「原型」)並未實現 SpecAgent 協議,僅提供受控執行、沙箱與路由評測基礎。
上線多步工具智能體前的三項架構自檢清單
架構與技術負責人在落地前可執行三項核查:
- 工具目錄是否完成讀寫分級? 將無副作用查詢與修改記錄、觸發外部接口等寫入嚴格分離,使運行時能在首個寫入動作處自動掛起。
- 高成本審閲是否放在寫入邊界而非每一步? 允許輕量模型連續完成只讀取證,僅在跨越寫入邊界或達分塊上限時觸發強模型或人工審閲。
- 驗收與評測是否兼顧語義有效性與多維工作點? 按目標與約束達成度做語義驗收,並同步監控成功率、強模型輸出令牌、顯存帶寬與時延。
覺得有用?分享給需要的人。
參考文獻
- [1]
Wang, Z., Liu, Y., Chen, C., Liu, Q., & Guo, Z. (2026). Trajectory-level speculation with semantic verification for tool-using agents (arXiv:2610.21463). arxiv.org ↗
- [2]
Leviathan, Y., Kalman, M., & Matias, Y. (2023). Fast inference from transformers via speculative decoding. In *ICML 2023*. arxiv.org ↗
- [3]
Chen, L., Zaharia, M., & Zou, J. (2024). FrugalGPT: How to use large language models while reducing cost and improving performance. *TMLR*. arxiv.org ↗
相關能力
技能包

S01 · 智能中樞
複雜任務拆解與執行
交由 AI 處理的複雜任務常中途停止或偏離目標,進度也無從查看。
先將目標拆解為有序的任務清單,經人工確認範圍後執行,交付前再次驗收。
- 拆解任務清單
- 確認執行範圍人工複核
- 逐項執行
- 驗收交付人工複核
4 步2 處人工複核7 個組件

S03 · 智能中樞
經審批的電腦操作
後台錄入、填表、修改文件等重複操作希望交由 AI 執行,又擔心誤操作。
AI 先列出操作位置與修改內容,經批准後執行;每一步均保留截圖與改動記錄。
- 準備帳戶與登入
- 審批操作清單人工複核
- 執行並截圖
- 檢查改動人工複核
4 步2 處人工複核8 個組件
S12 · 模型網關
模型對比與切換
新模型不斷推出,更換擔心效果下降,不換又擔心落後。
用同一批樣例對比新舊模型的質素、錯誤與費用差異,再確定主用與備用模型。
- 檢查可選模型
- 樣例對比
- 審閲切換建議人工複核
- 設定主備模型
- 切換後抽查人工複核
5 步2 處人工複核7 個組件