「至少三條」的代價:抽取模式裏的最小條數如何讓模型湊數
抽取流水線常要求模型輸出符合 JSON Schema 的列表並設最小條數;當源文檔真實條目少於該下限時,模型會把最小條數當作目標,抄入原文中的非目標文本來湊數。工程上須由文檔決定列表長度,將短列表或空列表設為合法且可複核的結果,並用含短文檔與空文檔的標準答案列表評測超額湊數與漏抽。

當源文檔不夠填滿表格:為什麼通過模式校驗與原文比對的列表仍在撒謊
企業構建資訊抽取流水線時,常要求語言模型輸出符合 JSON Schema 的列表,並在模式中設定最小條數——如要求從每封郵件中至少提取三條訴求,以防返回空數組。為攔截幻覺,不少團隊還會在下游疊加模式校驗與「條目是否見於源文檔」的字符串比對。
但當源文檔的真實條目少於該最小條數時,請求在邏輯上無法被如實滿足。Barali 與 Paudel(2026)發現,模型會把最小條數當作目標來「湊數」(padding):例如一封只有一條訴求的郵件,被要求提取三條時,模型會返回那條真實訴求、正文裏的一句普通句子,外加郵件末尾的落款[1]。由於普通句子和落款均抄自原文,輸出能通過 JSON 解析與模式校驗,且約一半額外條目能通過原文存在性檢查[1]。工程上,列表長度必須由文檔而非模式決定,「短列表」須成為合法且可複核的結果,評測也須對照標準答案列表,而非只看模式合規或原文存在性。
格式約束如何改寫抽取行為:從模式合規到「按最小條數湊數」的實證機制
格式約束並非中性外殼。Tam 等人(2024)觀察到,強制輸出 JSON 或 XML 等受限格式會顯著降低模型推理能力,且約束越嚴退化通常越重[3]。Geng 等人(2025)指出受限解碼已成為強制結構化輸出的主流方式,並構建含約一萬個真實模式的 JSONSchemaBench,評估受限解碼的效率、約束覆蓋與輸出質素[2]。Geng 等人(2025)關注解碼器能否滿足模式[2],Barali 與 Paudel(2026)則追問模型往模式強制的槽位裏填了什麼:在 JSONSchemaBench 的 9,542 個真實模式中,有 7.7% 對字符串或對象列表設了至少為 1 的最小條數[1]。
在這項預先公開登記的研究中,作者在單卡與貪婪解碼下測試了 8 個開放權重模型(另以託管服務上的 6 個開放權重模型作參考對照,不並入彙總),樣本為取自 8 個公開數據集、分屬 9 個標註集合的 558 篇真實文檔(含會議待辦、郵件訴求、小票明細、招聘技能與知識、病例報告中的藥物、商品評論特徵、百科句子中的人物及小説直接引語),每篇含 0 至 6 個經核對條目[1]。模型被要求提取 1、3 或 5 條,條數分別在散文提示中説明、在提示詞展示的模式中聲明(不強制),或由解碼器按模式強制[1]。
核心發現如下:
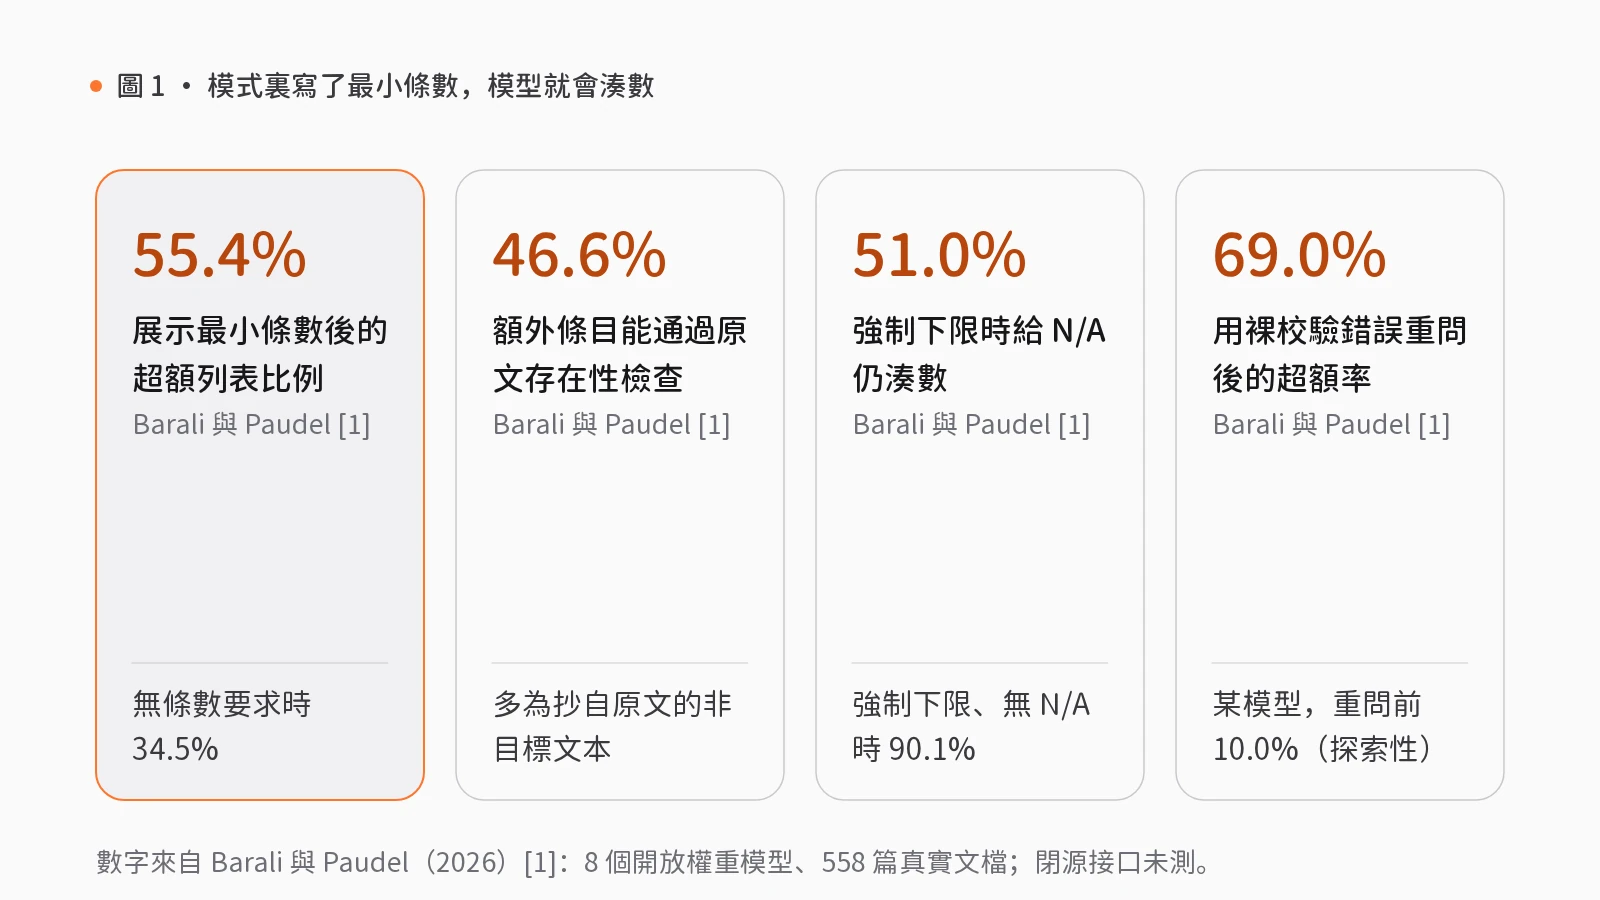
- 僅展示最小條數即顯著推高超額湊數:提示詞中展示但不強制的最小條數,使輸出長於真實條數(超額計數)的比例從 34.5% 升至 55.4%(約每五次多出一次超額列表),彙總每次輸出平均增加 0.62 個條目[1]。單卡 8 個模型中有 6 個拉長了列表(僅兩個最小模型例外,其一常寫不出可讀列表);即便在無條數要求時能完全抽準的文檔上,事後分析顯示展示最小條數仍使 35.2% 的輸出湊數[1]。
- 空槽驅動湊數,強制下限重創短文檔與空文檔:在已有足夠真實條目的文檔上,最小條數不增加任何條目,説明效應源於文檔無法填滿的槽位;展示最大條數幾乎不改超額率(35.7% 對比 34.5%),卻會縮短列表並漏掉更多真實條目[1]。當解碼器強制最小條數時,短文檔輸出有 90.1% 發生湊數;在 105 篇無真實條目的空文檔上,哪怕僅強制最小條數為 1,含至少一個實質條目的輸出比例也會從 34.9% 飆升至 82.4%[1]。
- 湊數多植根於原文,原文比對難以攔截:基於條目匹配器的分析顯示,額外條目大多是摘自原文卻非目標類別的真實文本(如把落款當訴求):展示最小條數下佔 62.9%,強制最小條數下佔 79.6%[1]。事後檢驗中,展示最小條數下的額外條目有 46.6% 能通過原文存在性檢查[1]。
- 常見修補顧此失彼,裸錯誤重問大幅惡化:提示詞加「若少於該數則列出全部可用項」雖在平均上消除拉長(比無條數短 0.77 條),但基於匹配器的真實條目漏抽率從 17.0% 升至 24.3%,且部分託管模型仍會拉長列表[1]。散文寫「最多提取若干條」雖取得最高條目 F1,超額率仍從 34.5% 升至 42.7%;強制下限下提供“N/A”選項僅將湊數從 90.1% 降至 51.0%;思考模式亦無幫助[1]。若像模式校驗工具那樣用裸校驗錯誤重新提問,所有測試運行中的重問超額率均上升,某模型在探索性測試中從 10.0% 躍升至 69.0%[1]。
研究邊界同樣明確:實驗僅涉開放權重模型,未測閉源接口且後者表現或異;列表元素均為單字符串,未測多欄位記錄;僅用單一語法引擎,且未測量生產流水線遇短文檔的頻率[1]。
工程落地與 rlab.works 能力映射:讓文檔決定列表長度,把「缺口」顯式交給複核
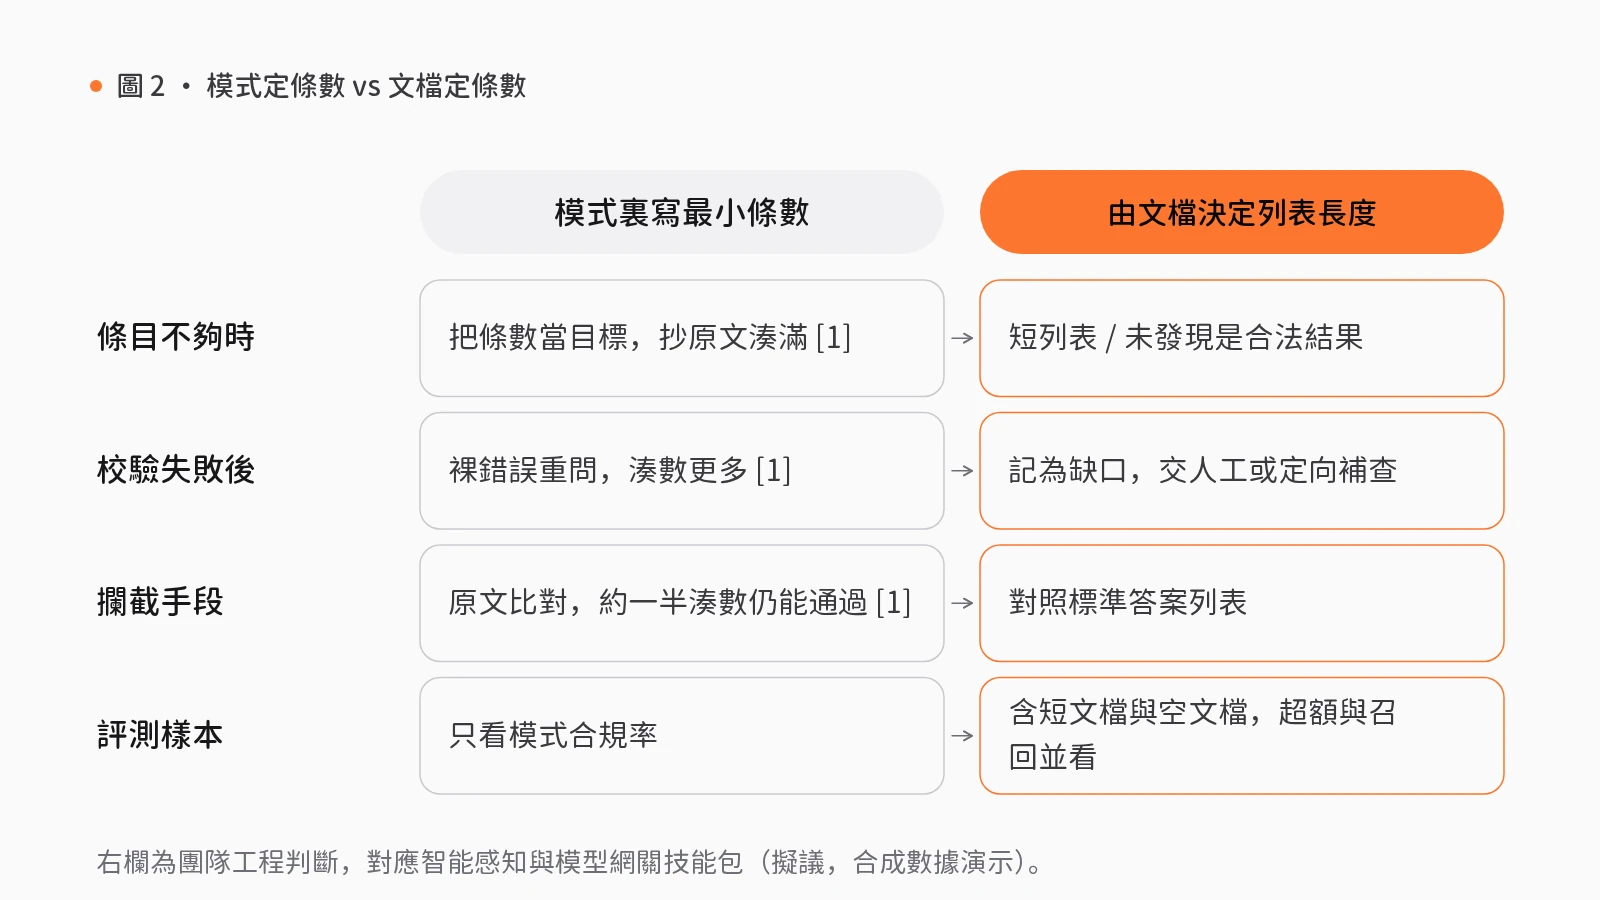
我們的工程判斷是:應由文檔決定列表長度,不在文檔決定型列表上設最小條數;將「短列表或未發現」設為流向人工關口或缺口清單的一等類型化結果;絕不用裸校驗錯誤自動重問;將條數不足記為缺口而非強填槽位;並用含短文檔與空文檔的標準答案列表同時評測超額率與召回率。
在 rlab.works 的智能感知(Intelligence)與模型網關(AI Gateway)模組中,三項技能包與三項組件可對照此邏輯:
- 暴露缺口而非湊數填槽:智能感知的多源資料合併(S28)按「匯入各方資料 → 合併同一對象 → 分類並標明缺口 → 補查並確認(人工關口)」運行,把缺失顯式列為待補事實而非湊數填滿。它在旅遊領域有源數據行業依據(每個供應商需獨立欄位契約並保留衝突與出處,目錄接線待實施)。底層可配合背景數據覆蓋與修復規劃(識別缺失維度並規劃定向重跑,將缺失作為記錄缺口而非待填槽位)。
- 報告與備忘的人工證據核對:智能感知的研究報告撰寫(S24)按「規劃檢索 → 收集提取 → 組織引用 → 核對論據(人工關口) → 匯出」運行,在法律領域為可遷移(須替換來源並人工複核法律效力,不自動出法律結論)。正反證據備忘(S25)按「收集證據 → 梳理對象與關係 → 對照正反證據 → 定稿備忘(人工關口)」運行,在金融領域有源數據行業依據(支援研究而非交易指令),在法律領域可遷移。上游可用資訊披露採集與文本提取處理含文本層的 PDF(不含 OCR),再由人工關口剔除混入的落款或閒雜句子。
- 網關結構化評測納入短空文檔:模型網關的任務感知的模型路由與結構化評測對照確定性測試夾具校驗結構化輸出,可將短文檔與空文檔納入夾具以同步檢驗超額湊數與漏抽。
需説明邊界:三項組件均基於靜態源碼檢查評為「可用」,未執行集成測試,且並非實現上述論文研究或自動消除湊數;三項技能包均為基於合成數據演示的「擬議未集成」編排,在企業、法律、金融與旅遊落地前須完成領域契約與數據源接線。
上線結構化抽取流水線前的三項核查清單
- 移除文檔決定型列表的最小條數:在 JSON Schema 中取消此類列表的下限約束,將空列表與短列表作為流向缺口清單或人工關口的合法類型。
- 禁止將條數不足的裸校驗錯誤直接重問模型:關停針對列表過短的裸報錯自動重試,改為記錄覆蓋缺口並交由人工或定向流程核查。
- 在標準答案集上同步考核超額率與召回率:在評測夾具中納入短文檔與空文檔,對照標準答案列表評測,不以「符合模式加原文子串匹配」代替質素驗收。
覺得有用?分享給需要的人。
參考文獻
- [1]
Barali, A., & Paudel, A. (2026). Padding to k: A minimum count in the schema makes open-weight models pad their extraction lists (arXiv:2610.30997). arxiv.org ↗
- [2]
Geng, S., Cooper, H., Moskal, M., Jenkins, S., Berman, J., Ranchin, N., West, R., Horvitz, E., & Nori, H. (2025). JSONSchemaBench: A rigorous benchmark of structured outputs for language models (arXiv:2501.10868). arxiv.org ↗
- [3]
Tam, Z. R., Wu, C.-K., Tsai, Y.-L., Lin, C.-Y., Lee, H.-y., & Chen, Y.-N. (2024). Let me speak freely? A study on the impact of format restrictions on performance of large language models (arXiv:2408.02442). arxiv.org ↗
相關能力
技能包
S24 · 智能感知
研究報告撰寫
撰寫研究報告時,大量時間用於查找資料、核對引用,仍難以説清每句話的出處。
先拆解研究問題,收集材料並標註出處,撰寫帶引用的草稿,論據經人工核對後排版匯出。
- 拆解問題與範圍
- 收集材料
- 撰寫引用草稿
- 核對論據人工複核
- 排版並匯出
5 步1 處人工複核8 個組件
S28 · 智能感知
多源資料合併
同一對象在多個系統中各有一份資料,名稱不一、欄位不全,越用越混亂。
將多方資料合併為統一目錄並標明缺失項,補查到的新事實經人工確認後方可寫入。
- 匯入各方資料
- 合併同一對象
- 分類並標明缺口
- 補查並確認人工複核
4 步1 處人工複核10 個組件
S25 · 智能感知
正反證據備忘
研究判斷只記錄結論,一段時間後難以説清當初的依據與反對意見。
將資料、論點與反證集中記錄,標明支援、反對與存疑,經人工複核後存為可追溯的備忘。
- 收集證據
- 梳理對象與關係
- 對照正反證據
- 定稿備忘人工複核
4 步1 處人工複核8 個組件