多一個智能體,多一份把握?分工複核的漏檢與誤報交換
將文檔複核拆給多個智能體分頭把關,常被預設等同於更可靠的系統。最新受控實驗表明,分工複核主要是在移動漏檢與誤報的工作點、消耗更多詞元,且本身並不會自動降低推理過程中的幻覺;合理的上線評估必須以同等調用次數的單智能體為基線,在已知無缺陷樣本上分開度量漏檢與誤報。

把清單拆給多個智能體,為何沒有換來更省心的複核
在信貸備忘錄核對、合同審查或交接單檢驗中,單智能體一次核對整張清單容易顧此失彼。常見建議是「把複核拆給幾個智能體」,或搭一套反思、辯論與彙總拓撲;看到多智能體方案的任務得分上升,團隊便以為系統更可信。但上線後可能出現另一種局面:人工複核被誤報佔滿,或彙總報告的推理理由裏仍夾帶偏離原文的內容。
這一困境源於把「工作點漂移」誤讀為「能力淨提升」。最新受控研究表明,拆分複核主要是在移動漏檢與誤報的工作點:它能多抓出部分隱蔽缺陷,但會引發更多誤報、消耗更多詞元,且本身並不會降低推理陳述中的幻覺。合理的評估必須固定並報告推理指令,在已知乾淨樣本上把漏檢與誤報拆開計分,並與同調用次數的單智能體基線對比。
移動工作點與能力再分配:分工複核的實證拆解
為何增加智能體常難以兑現可靠性?Cemri 等人(2025)指出,多智能體系統在主流基準上的性能增益往往微乎其微[3]。他們彙集跨 7 個主流框架的 1600 多條標註軌跡,由專家在 150 條軌跡上歸納出涵蓋系統設計問題、智能體間失配、任務核驗 3 大類共 14 種失效模式的分類法[3]。我們的解讀是:其中「智能體間失配」與「任務核驗」兩類,恰好對應分工複核中最容易出問題的交接與把關環節。
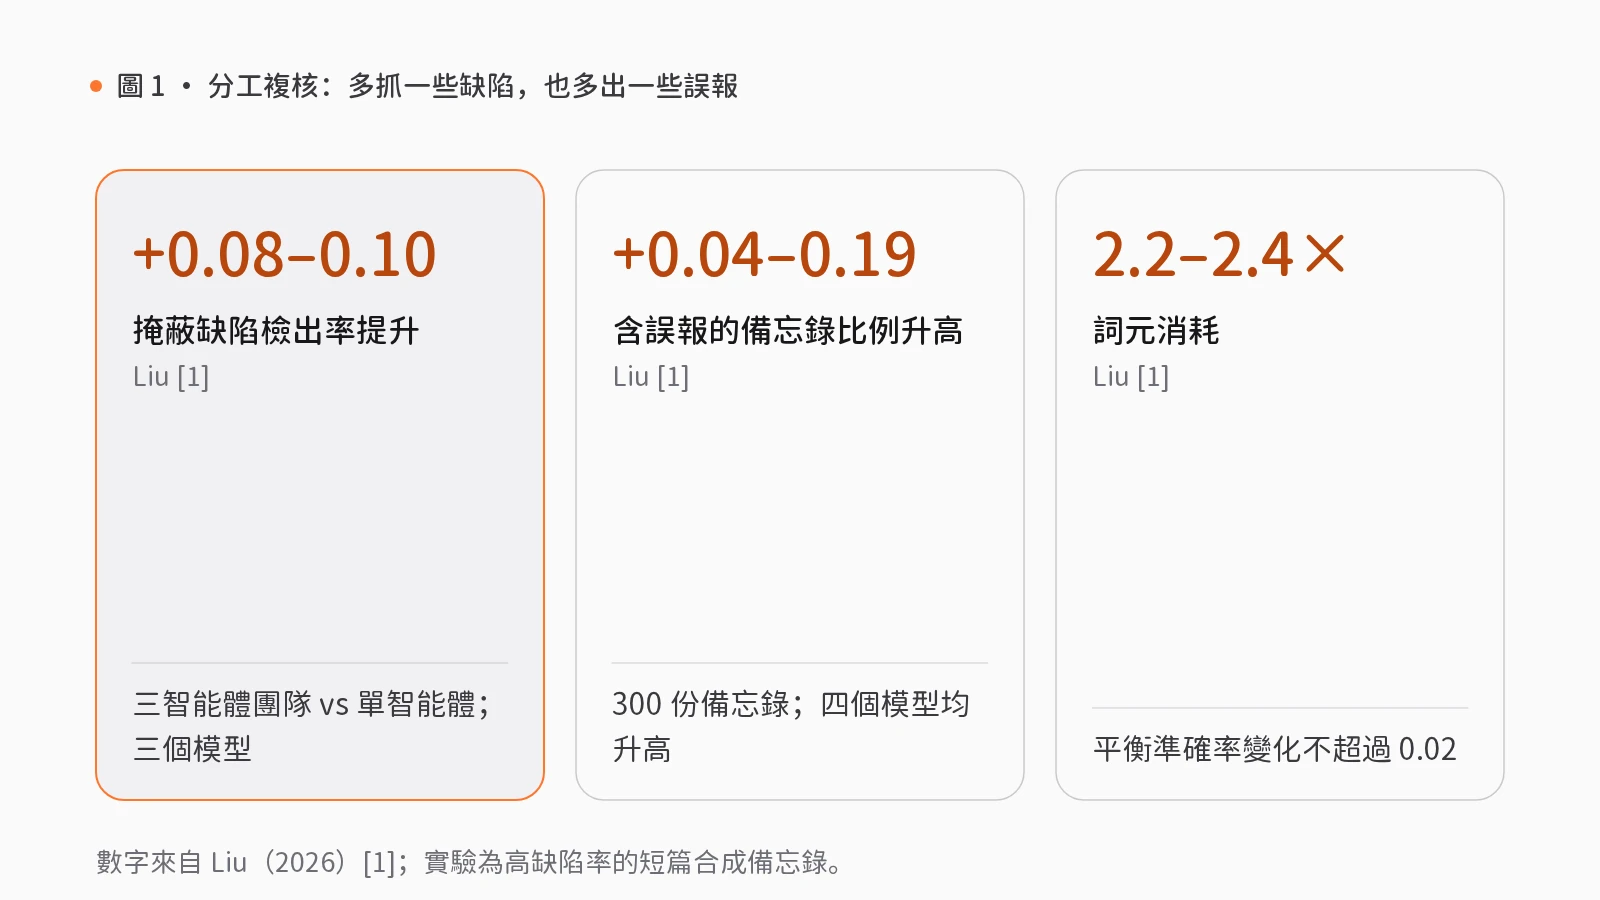
Liu(2026)通過受控金融複核實驗剝離了「拆分」的淨效應[1]。實驗由公開信用卡數據集記錄程式化生成 300 份合成信貸評估備忘錄(各約 1100 詞),對照 6 項書面要求形成 1800 個標註單元:1136 個乾淨、205 個裸露缺陷、229 個自帶解釋的掩蔽缺陷和 230 個算術缺陷,缺陷佔 37%(遠高於實際)[1]。材料與分析在運行前經提交哈希鎖定,在四個模型上按多重檢驗校正水準測試兩項主預測:單智能體一次調用查全部 6 項;同模型的三智能體團隊審同一備忘錄,各查 2 項,措辭相同,無角色設定,無後續階段[1]。
在「每項要求決定一次」指令下,對單智能體有漏檢的三個模型,團隊在自帶解釋的掩蔽缺陷上多抓出 0.08 至 0.10(兩個模型校正顯著)[1]。但團隊在四個模型上都引發更多誤報(三個模型校正顯著),300 份備忘錄中至少含一次誤報的比例在各模型上均升高 0.04 至 0.19[1]。探索性平衡準確率變化不超過 0.02,團隊卻用掉 2.2 至 2.4 倍詞元;去掉該指令後,團隊超出的誤報在四個模型上都更大[1]。
引入反思與辯論拓撲能否減少推理幻覺?Jang、Joshi 與 Yu(2026)在四個模型和三項帶金標的臨牀任務上,對比單模型基線與三種由聚合、反思、辯論模組構建並以聚合器收尾的多智能體拓撲;系統不接工具或檢索,在推理依據內部按事實性與忠實度對原子聲明計分[2]。結果顯示,協作能換取任務性能,卻不能作為通則降低幻覺,無一拓撲穩定更優[2]。在 36 組模型—系統—任務對比中,12 組變化足以分辨:4 組幻覺下降全來自同一模型,8 組上升分佈在其餘三個模型,無模型同時在兩側——決定幻覺水平與方向的是模型,而非拓撲或智能體數量[2]。將拓撲從 3 個智能體擴至 7 個影響甚微,僅替換聚合器模型卻能讓幻覺跨越大部分變化區間,系統落在其較強成員單獨達到的水平附近[2]。自我糾錯實驗中,展示被標出的錯誤後,除一個模型外其餘均降低幻覺;協作最能幫到的模型獲益最大,受協作損害最重的模型毫無獲益(與自我糾錯機制一致,但非證明)[2]。作者總結:協作「只是重新分配了其模型本已具備的能力,並不能供應它們所不具備的能力」[2]。
把分工複核裝進工程契約:範圍約束、同預算基線與人工關口
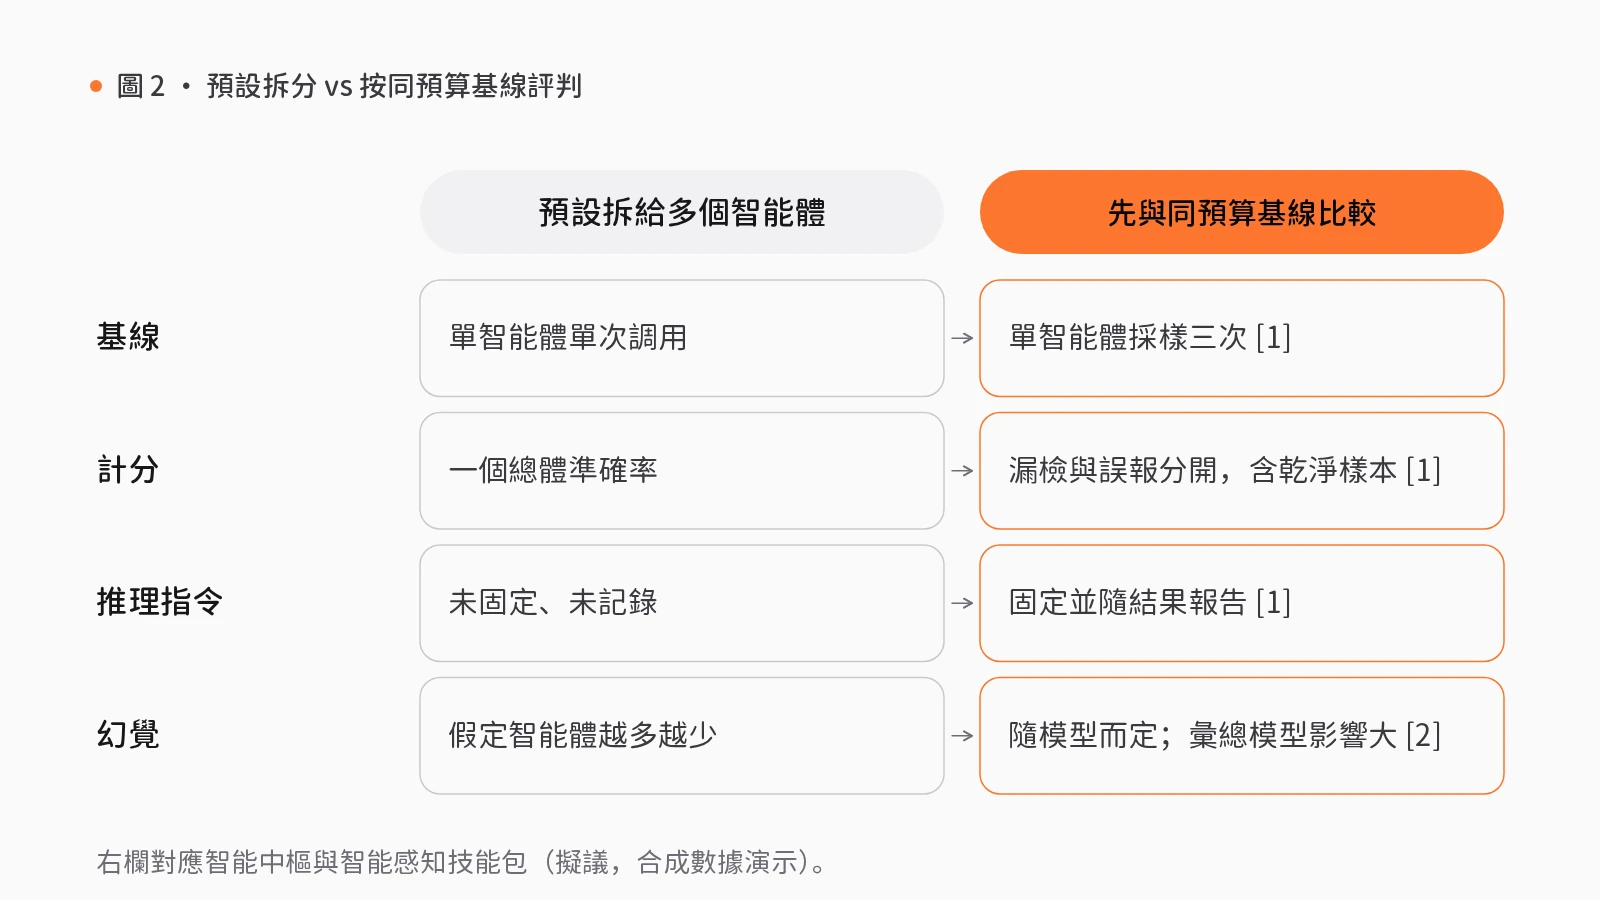
我們認為,工程團隊在拆分複核前應建立含已知乾淨案例的標註集,按單元和文件分別報告漏檢率與誤報率;與同調用預算的單智能體(如三次抽樣取任一或多數規則)對比;固定並記錄推理指令;若拆分,向各子審閲器展示其他審閲器覆蓋的範圍,並要求每次報警綁定原文引句;按漏檢與誤報的業務成本及真實缺陷率決策,由人工關口掌握最終結論。
在 rlab.works 的智能中樞與智能感知模組中,可以用三項技能包與三項組件對照這一約束:
- 拆分審批與受限執行:智能中樞的複雜任務拆解與執行按「拆解任務清單 → 確認執行範圍(人工關口) → 逐項執行 → 驗收交付(人工關口)」運行,是決定是否拆分及如何評判的節點。它除通用模式外在製造業為可遷移應用,軟件僅編排數字任務與交班記錄,機械作業由人員按許可執行。底層由可用狀態的持久目標、受限子智能體與定時任務限制子智能體能力範圍、深度與並發,並由可用狀態的協作交付、審批與證據門檻把關——證據門檻表達已配置要求,不保證業務成功。
- 金融證據備忘與裁決:智能感知的正反證據備忘按「收集證據 → 對齊實體 → 比較主張與反證 → 複核並保存備忘(人工關口)」運行,文獻[1]的信貸備忘錄核查與之類似但非站點案例。它在金融領域有源數據行業依據(僅表源數據標籤關聯,非真實部署),適配需對齊實體與時點定義,產出支援研究而非交易指令。底層由可用狀態的投資論點證據與結論跟蹤分離支援、挑戰與複雜化因素,結論可人工覆寫,編輯啓發式並非財務預測。
- 多源法律報告核查:智能感知的研究報告撰寫在法律領域為可遷移應用,需人工複核法律效力與判例適用性,不自動生成法律結論。
上述技能包均為合成數據演示的擬議編排,未接入生產服務;組件成熟度基於靜態源碼檢查。
拆分複核工作流前的三項核查清單
上線多智能體分工複核前,架構與風控負責人應核查三點:
- 以同調用預算單智能體為基線,在乾淨樣本上單列檔案級誤報率:在已知無缺陷樣本上對比分工團隊與單智能體多次採樣的檔案級誤報率與掩蔽缺陷漏檢率,按真實缺陷率核算期望成本。
- 固定推理指令並向子智能體展示排除範圍:鎖定並記錄「每項要求決定一次」等指令;拆分時向各子智能體列出其餘條款範圍,要求每條標記綁定原文引句。
- 將算力投向聚合模型並保留人工終審關口:在所測設定中,堆疊智能體並未憑空消除推理幻覺,而替換匯總節點的模型影響更大[2];優先保障彙總節點的模型能力,由人工關口做最終裁決。
覺得有用?分享給需要的人。
參考文獻
- [1]
Liu, P. (2026). The More the Better? A Comparison of Single- and Multi-Agent LLM Setups on a Financial Review Task (arXiv:2610.27488). arxiv.org ↗
- [2]
Jang, W. S., Joshi, H. B., & Yu, H. (2026). Does Multi-Agent Collaboration Reduce Hallucination in Clinical Tasks? (arXiv:2610.27027). arxiv.org ↗
- [3]
Cemri, M., Pan, M. Z., Yang, S., Agrawal, L. A., Chopra, B., Tiwari, R., Keutzer, K., Parameswaran, A., Klein, D., Ramchandran, K., Zaharia, M., Gonzalez, J. E., & Stoica, I. (2025). Why Do Multi-Agent LLM Systems Fail? (arXiv:2503.13657). arxiv.org ↗
相關能力
技能包

S01 · 智能中樞
複雜任務拆解與執行
交由 AI 處理的複雜任務常中途停止或偏離目標,進度也無從查看。
先將目標拆解為有序的任務清單,經人工確認範圍後執行,交付前再次驗收。
- 拆解任務清單
- 確認執行範圍人工複核
- 逐項執行
- 驗收交付人工複核
4 步2 處人工複核7 個組件
S25 · 智能感知
正反證據備忘
研究判斷只記錄結論,一段時間後難以説清當初的依據與反對意見。
將資料、論點與反證集中記錄,標明支援、反對與存疑,經人工複核後存為可追溯的備忘。
- 收集證據
- 梳理對象與關係
- 對照正反證據
- 定稿備忘人工複核
4 步1 處人工複核8 個組件
S24 · 智能感知
研究報告撰寫
撰寫研究報告時,大量時間用於查找資料、核對引用,仍難以説清每句話的出處。
先拆解研究問題,收集材料並標註出處,撰寫帶引用的草稿,論據經人工核對後排版匯出。
- 拆解問題與範圍
- 收集材料
- 撰寫引用草稿
- 核對論據人工複核
- 排版並匯出
5 步1 處人工複核8 個組件