把合規寫進語句庫,而不是寫進提示詞:受監管內容生成的數據架構
在受監管內容生成中,把合規與受眾約束不斷追加進長提示詞既昂貴又脆弱。生產案例與檢索機制研究表明,應將約束沉降為核准語句記錄上的結構化元數據,用檢索門禁控制准入,向生成器直接提供核准原文,並將結構性過濾指標、盲評質素與人工醫學法務註冊終審嚴格區分。

越寫越長的提示詞規則,為何管不住受監管內容生成
在醫藥推廣與醫學溝通材料等強監管場景中,每條核心表述都必須對應已獲批的適應症、受眾與文獻出處,且不得觸碰禁用詞。一種常見做法是把合規要求不斷塞進系統提示詞:每發現一次越界,就在長提示詞或模板裏追加一條引用規則或原話複述指令。
隨着產品與渠道增加,靜態提示詞容易膨脹為難以維護的規則清單。下文的生產案例中,基於規則提示詞的基線就常常給不出貼合受眾與情境的產出,出現受眾錯配、相關性低、過度使用失效或泛化聲明等問題[1]。癥結在於架構錯位:合規與受眾約束本是單條核准記錄的屬性,而非全局修辭指令。我們的判斷是,把規則沉降到語句級數據模型,用檢索門禁攔截不合格記錄,並向生成器直接提供未經改寫的核準原文,是更可擴展的做法;但支撐這一判斷的證據需要仔細讀。
從提示詞規則到語句級數據模型:檢索門禁、原典保真與成本真相
把生成錨定在外部索引上,源於 Lewis 等人(2020)提出的檢索增強生成範式:將參數化生成器與非參數化檢索索引結合,使輸出在檢索時直接調用外部文檔[3]。在強監管場景中,關鍵在於索引單元如何建模、原文是否保真,以及如何解讀評估與成本指標。
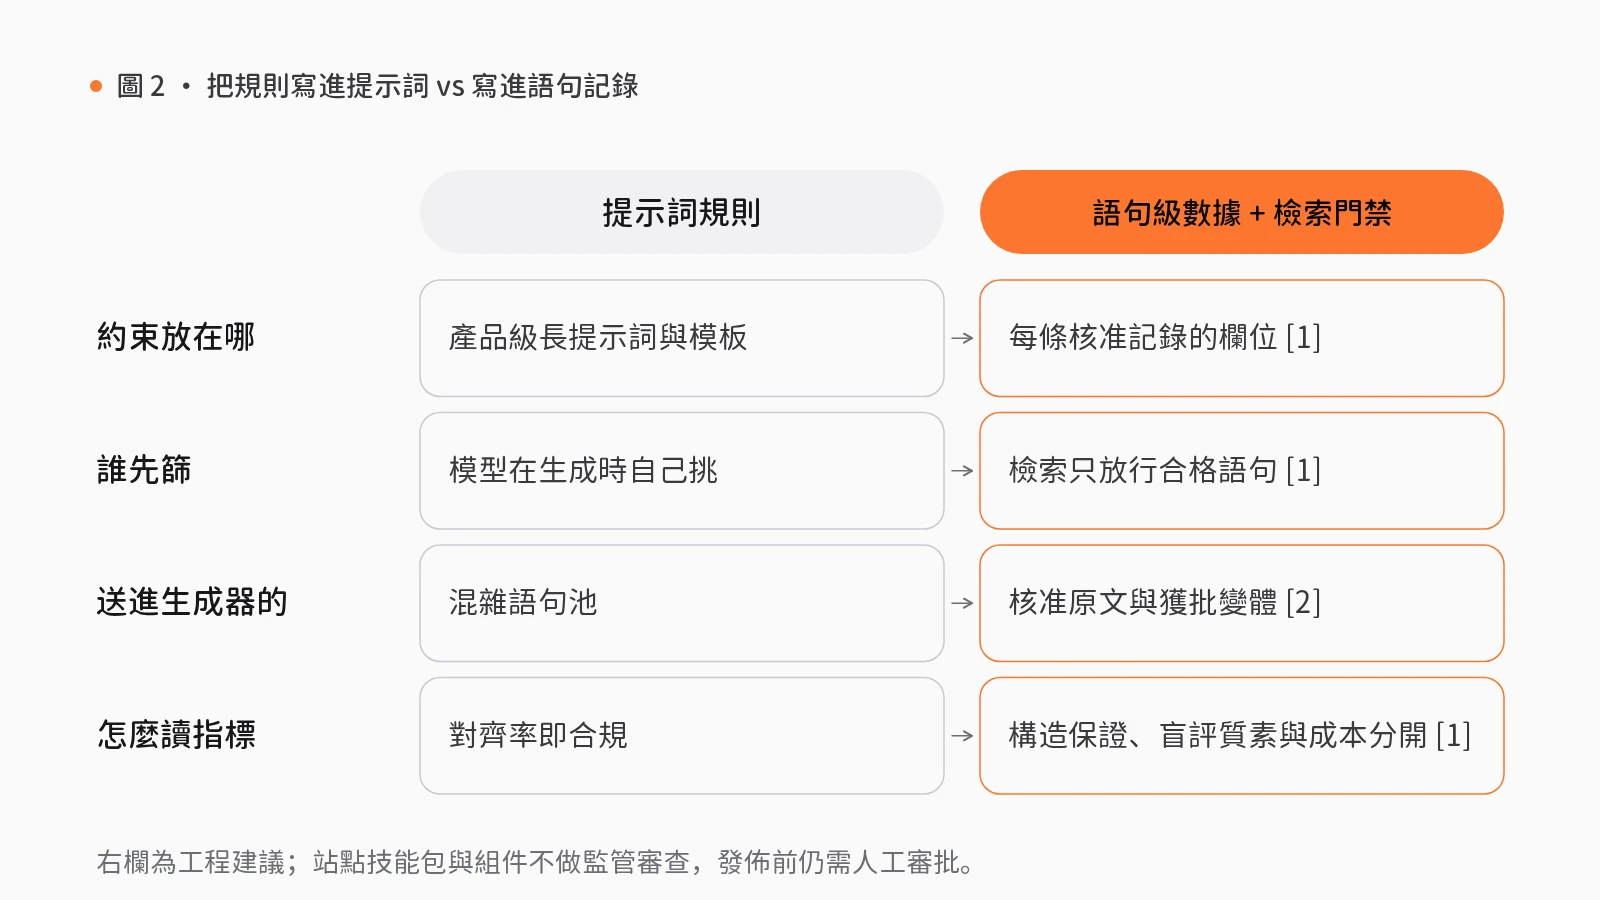
Mishra 等人(2026)報告了一項內部醫藥聲明生成工具的生產研究[1]。其數據模型覆蓋美國市場四款產品的 1,867 條已批准醫藥聲明,跨 11 個類別;98% 的聲明關聯了文獻(2% 無文獻),72% 已被物料採用[1]。基線採用規則提示詞加嚴格模板(含引文規則與原話約束);新管線並未消除規則,而是將其從產品級靜態提示詞遷移為聲明級的檢索門禁元數據[1]。每條記錄含已批准匹配文本、生命週期狀態(已批准、已歸檔、草稿)、文獻編號與正文、適應症、內容類型、目標受眾、專屬護欄、禁用詞與負向約束,以及涵蓋清晰度、完整性、一致性、關聯性、合規性與語境的六維質素分;系統對重複、近重複與矛盾聲明做聚類,以圖結構關聯聲明、文獻與物料,並由受眾過濾器排序、合併、抑制或標記[1]。
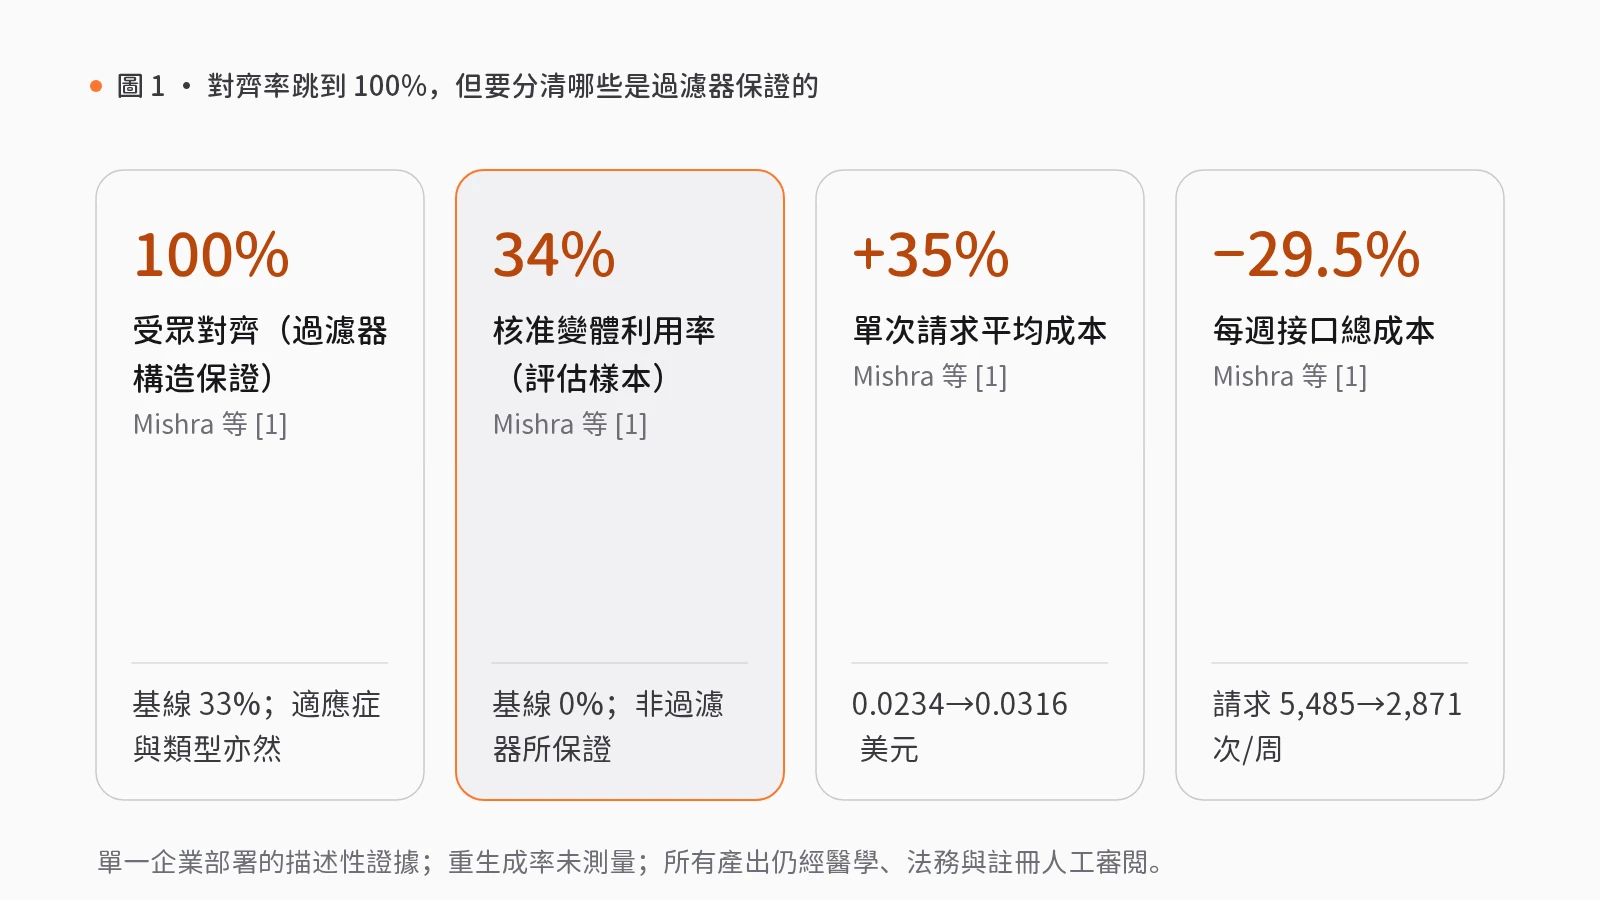
在六個產品與受眾細分場景的小樣本盲評中(每細分僅少量聲明,由未參與開發且對管線盲態的內部醫學撰稿人評判),已批准聲明採用率從 71% 升至 100%,適應症對齊從 71% 升至 100%,內容類型對齊從 38% 升至 100%,目標受眾對齊從 33% 升至 100%[1]。必須強調作者指出的關鍵前提:上述 100% 對齊與核准聲明採用率「在結構上由構造方式保證」——檢索管線只放行已匹配目標適應症、內容類型與受眾的聲明,100% 反映的是過濾器設計,不代表模型天然學會了合規[1]。真正檢驗結構化上下文價值的指標是核准變體複用率與六維質素分:樣本中聲明變體利用率從 0% 升至 34%(全庫層面,備有變體的聲明佔 42.69%,而在物料中實際用到變體的僅約 17.6%),且多數細分下入選聲明的平均六維質素分高於基線[1]。
生產日誌(前後同一模型)揭示了另一層成本真相:單次請求詞元數從 5,714 增至 9,126,單次平均成本從 0.0234 美元升至 0.0316 美元,上漲 35%[1]。但每週總請求從 5,485 次降至 2,871 次,周響應詞元降 65.4%,使周接口總成本從 128.70 美元降至 90.69 美元,淨降 29.5%;請求成功率從 99.2% 升至 100%,中位延遲從 2,100 毫秒降至 1,956 毫秒[1]。作者指出,若請求量不變,總成本會上升約 35%;費用下降源於請求減少(作者推測因重生成減少,但未測量重生成率、活躍用戶或活動結構,故屬部署層面的相關性描述而非因果證明)[1]。該研究限於單一企業、四款產品與單一市場,數據集未公開;工具不直接向患者或醫療人士發佈內容,所有產出仍須通過醫學、法務與註冊人工審閲,歸併記錄時完整保留溯源與審批狀態[1]。
工程落地與 rlab.works 能力映射:台賬歸一、過濾檢索與出版前人工關口
我們的工程判斷是,受監管內容管線應把約束建成核準記錄欄位(狀態、受眾、適應症、渠道、禁用短語、文獻),由檢索門禁控制准入,向生成器傳入核准原文與允許變體,將構造保證指標與盲評質素及人工審閲結果分開統計,按每份被接受產出(請求次數 × 單次成本)核算成本,並在歸併與發佈全程保留溯源與人工關口。
在 rlab.works 的智能感知、模型網關與智能商務模組中,可用三項技能包與三項組件映射這一設計並劃定邊界:
- 語句去重、衝突留存與缺口核查:智能感知的多源資料合併(S28)按「匯入各方資料 → 合併同一對象 → 分類並標明缺口 → 補查並確認(人工關口)」運行。該包目前僅在旅遊目錄中有源數據驗證(建立來源欄位契約,保留衝突與出處,目錄接線待實現)。類比至語句庫,可藉此去重核准聲明、顯式保留矛盾表述,並揪出那 2% 無文獻關聯的記錄交人工確認。
- 帶權限與元數據過濾的原文檢索:模型網關的帶出處的資料檢索(S17)執行「收集可查資料 → 檢索相關段落 → 撰寫摘要 → 核對出處(人工關口)」,可配合向量存儲、嵌入與重排完成帶過濾條件的向量寫入、查詢與重排。該包在法律行業為可遷移應用,要求連接文檔權限與位置、顯式保留出處,且摘要本身不構成法律意見。
- 多受眾變體生成與審閲發佈:智能商務的多語言內容發佈(S38)按「撰寫內容草稿 → 翻譯並校對 → 審閲事實與措辭(人工關口) → 發佈至網頁與渠道 → 優化搜尋與分享」運行,可結合多語言營銷文案變體(保留事實錨定生成受眾與渠道變體)與內容審核與 A/B 測試管理(持久化草稿隊列與審閲決定)。該包在傳媒領域為可遷移應用(需將酒店專屬翻譯欄位改為通用稿件欄位,各發布出口須引用同一獲批版本),在公共服務中亦為可遷移應用(發佈前保留人工審批)。
需誠實聲明邊界:站點沒有任何技能包在醫藥推廣中經過驗證,也沒有任何技能包或組件執行監管合規審查(醫療健康標籤僅涉行政接待服務)。三項技能包均為基於合成數據的擬議未集成方案;三項組件雖經靜態檢查標為可用,但不能替代醫學、法務與註冊人工終審。
受監管內容生成系統的三項上線前核查清單
- 核查約束住在記錄欄位還是提示詞裏:確認狀態、受眾、適用範圍、禁用詞與文獻已建成檢索門禁欄位,且向生成器傳遞核准原文與獲批變體。
- 核查報表是否拆開「構造保證」與「盲評質素及單產成本」:不把檢索過濾自帶的 100% 維度匹配當成模型合規證明,單獨追蹤變體複用率、盲評質素與每份合格產出總成本。
- 核查歸併溯源與人工終審關口是否到位:確認去重歸併保留了審批狀態與文獻溯源,且任何草稿均須經醫學、法務與註冊人工審閲後方可發佈。
覺得有用?分享給需要的人。
參考文獻
- [1]
Mishra, S., Li, Q., Adak, S., Phogat, U., Patil, S., & Pati, S. (2026). From prompt rules to golden data model: Production-scale generation of personalized, compliant pharmaceutical claims (arXiv:2610.31519). arxiv.org ↗
- [2]
Bao, Z., Zhang, S., Zhang, H., Lou, S., Wen, M., & Luo, M. (2026). Is complex agentic memory always needed? Naive RAG is stronger than we thought (arXiv:2610.30755). arxiv.org ↗
- [3]
Lewis, P., Perez, E., Piktus, A., Petroni, F., Karpukhin, V., Goyal, N., Küttler, H., Lewis, M., Yih, W., Rocktäschel, T., Riedel, S., & Kiela, D. (2020). Retrieval-augmented generation for knowledge-intensive NLP tasks. In *NeurIPS 2020*. arxiv.org ↗
相關能力
技能包
S38 · 智能商務
多語言內容發佈
一篇內容需翻譯成多種語言並發布到網頁和社交渠道,版本一多便難以對應。
依據核實的事實撰稿,翻譯後逐一語種校對,事實與措辭經人工審批,再發布至網頁與選定渠道。
- 撰寫內容草稿
- 翻譯並校對
- 審閲事實與措辭人工複核
- 發佈至網頁與渠道
- 優化搜尋與分享
5 步1 處人工複核8 個組件
S28 · 智能感知
多源資料合併
同一對象在多個系統中各有一份資料,名稱不一、欄位不全,越用越混亂。
將多方資料合併為統一目錄並標明缺失項,補查到的新事實經人工確認後方可寫入。
- 匯入各方資料
- 合併同一對象
- 分類並標明缺口
- 補查並確認人工複核
4 步1 處人工複核10 個組件
S17 · 模型網關
帶出處的資料檢索
AI 的回答看似完整,卻説不清出處,難以直接採用。
僅從授權資料中檢索相關段落,摘要標明所引用的段落,經人工核對出處後使用。
- 收集可查資料
- 檢索相關段落
- 撰寫摘要
- 核對出處人工複核
4 步1 處人工複核5 個組件