工具説「找到 20 條」,不等於只有 20 條:把工具輸出當作待核證據
在調用工具的智能體系統中,模型與下游核查器只能看到工具打印出的文本。兩項最新研究表明,即便沒有攻擊者且底層工具計算正確,省略截斷上限或估計標記的格式化文本也會誘導智能體過度斷言並讓核查器放行;而當工具給出安全保證時,模型審計員會表現出不對稱順從。工程上須為工具定義輸出契約、用代碼類型約束編號、在獨立步驟核驗工具保證,並由人工關口複核覆蓋範圍與出處。

工具打印的每句話都為真,為何智能體依然給出了假結論
設想法務或投研人員讓智能體查詢某年度檔案。檢索工具正常執行並返回「找到 20 份文檔」及列表;智能體隨即在報告中寫下「該年共有 20 份記錄」,下游模型核查器比對工具輸出後也判定結論「有據可查」。但庫中實有數千份匹配文檔——工具只是預設最多取 20 條,且未在打印文本中説明截斷。
這不同於惡意提示詞注入、評判模型偏好或測試預言機缺失。此處沒有任何攻擊者,工具計算完全正確,打印出的每句話在字面上都為真。癥結在於:模型及其後的核查器只能看到工具打印的文本。當格式化代碼省略搜尋上限、結果截斷、估計標記或編號命名空間,或當工具宣稱「某項檢查已存在」時,兩項新研究顯示,智能體會把殘缺文本當作完備事實,核查器隨之放行[1];模型審計員對工具「保證」的順從也遠多於對「告警」的順從[2]。
省略背景與不對稱順從:工具文本誤導模型的兩類機制
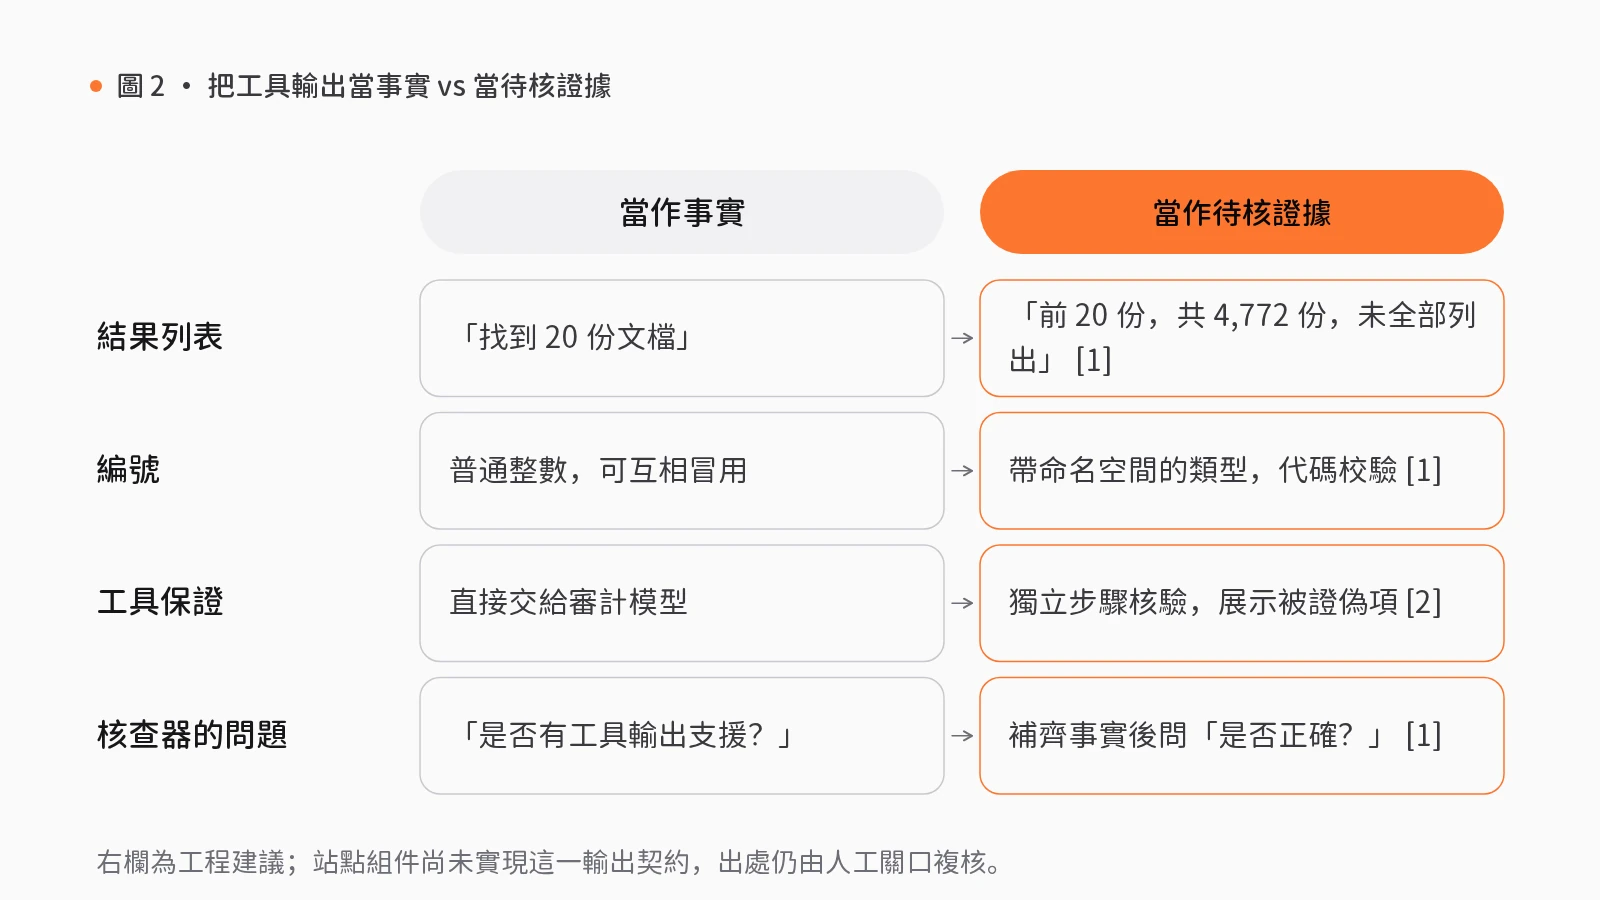
第一類機制是把工具內部結果轉為模型可讀文本的格式化代碼遺漏了邊界資訊。Jeffries(2026)審計了其本人蔘與維護的一套在用歷史檔案研究助手:系統含 17,807 份數字化檔案,智能體僅通過工具查詢,各工具計算均正確,但打印文本存在四類缺陷[1]:一是範圍,單文檔搜尋最多檢查前 1,000,000 個字符,未命中時卻打印已搜尋全文;二是完整性,日期搜尋最多取 20 條並打印「找到 20 份文檔」,而庫中 1920 年實有 4,772 條匹配(此前一次生產事故中,191 條匹配僅打印「找到 10 條」,是智能體向用戶提供錯誤資訊的原因之一);三是不確定性,估算頁碼未標為估計值(代碼審查中捕獲並復現);四是出處命名空間,文檔編號與掃描件編號均為普通整數,17,807 個文檔編號中除 2 個外也是無關條目的有效掃描件編號,傳錯編號會返回看似合法的錯誤條目[1]。
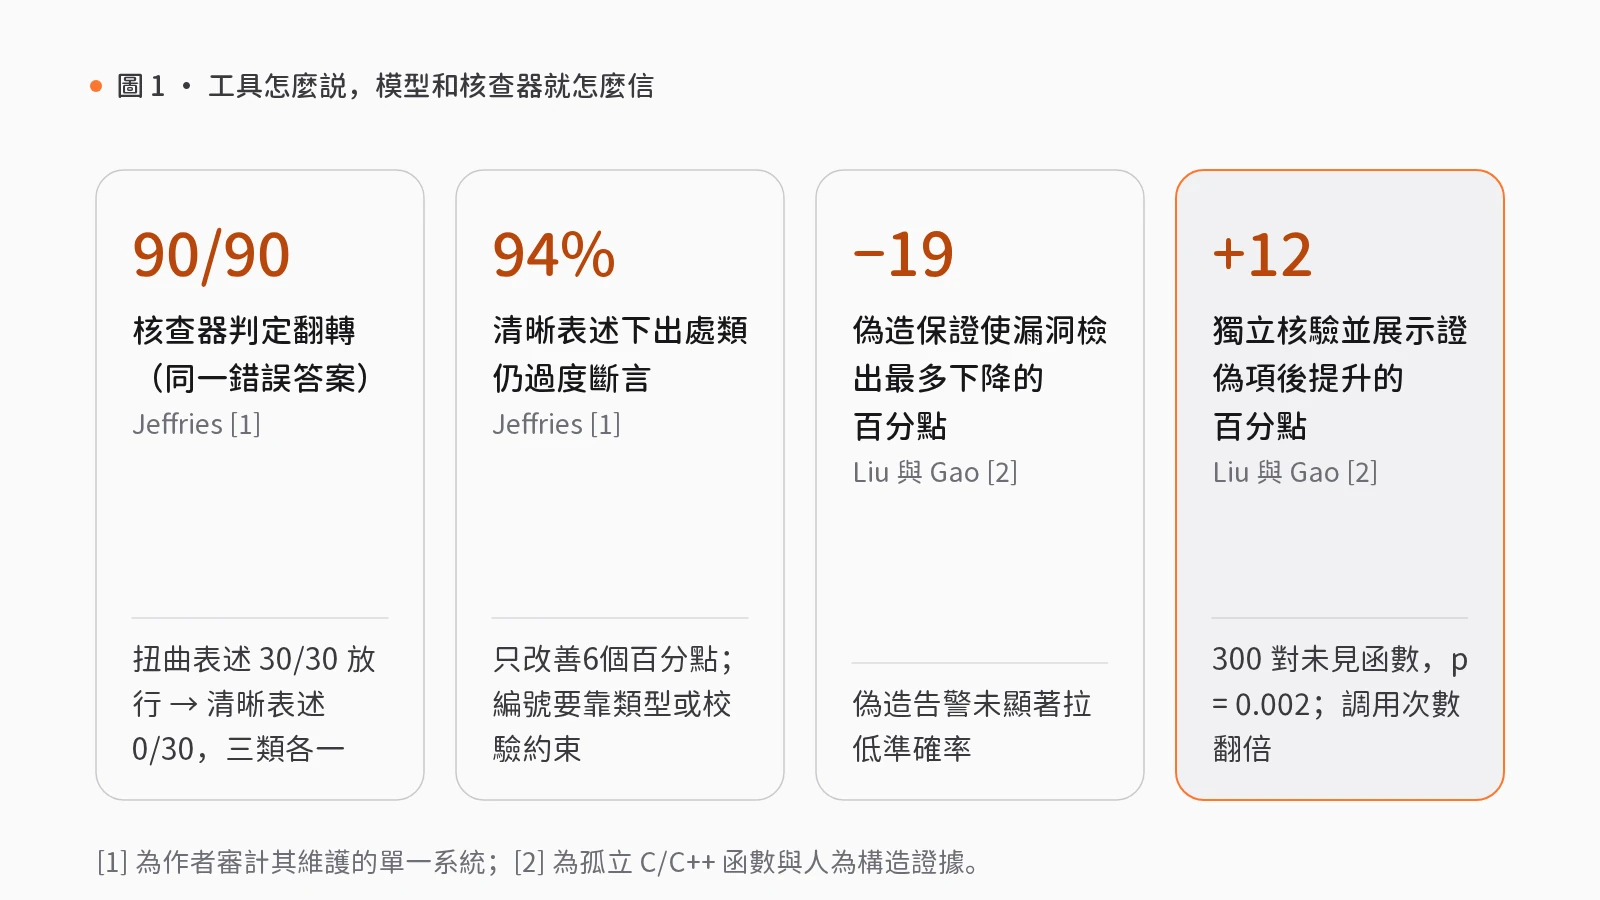
作者將相同真實結果渲染為「扭曲表述」與交代範圍、完整性、不確定性及編號來源的「清晰表述」,在 40 個案例(每類 10 個,8 個調優排除,32 個留出)、三類模型家族、5 次重複共 1,200 次運行中按預凍結規則評分[1]。扭曲表述下,智能體按類別在 62% 至 100% 的回答中過度斷言;清晰表述將範圍、完整性、不確定性的過度斷言率降至 8%、0%、20%,改善 62 至 92 個百分點(不確定性餘下 20% 源於對已標頁碼保持謹慎、卻將推算出的檔案頁當作事實的「估計值洗白」),但出處類仍達 94%,僅改善 6 個百分點,120 次清晰條件回答中僅 7 次正確指出無掃描件編號[1]。
固定錯誤答案、僅換工具表述時,核查器在範圍、完整性、不確定性三類上由每類 30/30 放行變為 0/30 放行,90/90 判定翻轉;出處類僅從 18/30 變為 14/30[1]。對 46 個扭曲表述錯誤答案(每格 92 次判定)的對照顯示:僅給工具輸出並問「是否受支援」,放行率 96%;補齊核實事實仍問「是否受支援」,放行率 61%;僅給工具輸出改問「是否正確」,放行率 98%;唯有同時補齊事實並問「是否正確」,放行率才降至 0%[1]。需注意:清晰表述混合了事實披露與行為指令,測得的是完整文本效果;編號命名空間須靠代碼類型或校驗約束;有時移除截斷上限等深層修復優於披露;研究僅針對作者維護的單一系統,審計提示詞演示亦在已知缺陷下編寫[1]。
第二類機制是模型對工具「保證」與「告警」的不對稱順從。Parasuraman 與 Manzey(2010)指出,人類操作員使用自動化輔助時易因注意力偏移產生自動化自滿與偏見,表現為漏掉輔助系統未提示的問題、或照做其錯誤建議[3]。Liu 與 Gao(2026)指出消費工具輸出的大模型正處於該操作員位置[2]。他們用過程內 C/C++ 靜態分析器生成通往敏感操作路徑上的「證明義務」(哪些檢查在所有路徑成立),在公開漏洞集 916 對「漏洞—修補」函數(四個不相交子集)上構造六種僅註釋不同的條件,含偽造保證(稱缺失檢查已存在)與偽造告警(稱已加檢查缺失),跨四家供應商 11 種模型配置完成 16,572 次無訓練審計[2]。
真實證據幾乎未提效(準確率 +0.02,95% 置信區間 −0.03 至 +0.07);偽造保證使真實漏洞檢出率比同操作真實註釋降最多 19 個百分點;偽造告警從未顯著拉低準確率且常被模型查代碼反駁[2]。7 個新模型上的內部註冊復現測得平均不對稱度 +0.16(95% 置信區間 +0.10 至 +0.24)[2]。提示詞指令無法可靠降低順從,研究集最佳提示詞(+0.18)在留出集未能復現[2]。在獨立調用中對照代碼核驗每條註釋並展示被證偽註釋,在 300 對未見函數的預指定測試中使偽造保證下準確率提升 12 個百分點,p = 0.002,真實證據下無損;但第二個模型上增益約減半且不顯著,且調用次數翻倍[2]。作者指出最需核驗的是分析器的保證而非告警;研究限於 150 行內孤立 C/C++ 函數(留出集 300 對)、人為構造證據及每條件單一提示詞[2]。
工程落地與 rlab.works 能力映射:輸出契約、獨立核驗與人工關口
我們的工程判斷是:(1)為每個檢索工具建立輸出契約(搜尋範圍與上限、返回數與真實總數或未知、估計與確認標記、帶命名空間的類型化編號);(2)在文本入模前用固定檢查器機械核驗(如 Jeffries 用固定規則檢查全部 80 段工具文本);(3)將工具的「已檢查、完備、安全」等保證視為最高風險輸入,在獨立步驟核驗並展示被證偽斷言;(4)向核查器補齊事實並問「是否正確」;(5)讓人工關口直接看到覆蓋披露。
在 rlab.works 的模型網關與智能感知模組中,可映射三項技能包與三項組件:
- 帶權限與覆蓋披露的檢索:模型網關的帶出處的資料檢索(S17)執行「收集可查資料 → 檢索相關段落 → 撰寫摘要 → 核對出處(人工關口)」,配合向量存儲、嵌入與重排做過濾向量查詢。該包在法律場景可遷移,需連接文檔權限與條款位置,摘要輸出不構成法律意見;我們建議在「核對出處」關口同時展示結果上限與總命中數,避免把截斷列表當成全集。
- 範圍透明的報告撰寫:智能感知的研究報告撰寫(S24)執行「拆解問題與範圍 → 收集材料 → 撰寫引用草稿 → 核對論據(人工關口) → 排版並匯出」,可調網頁搜尋與研究綜合獲取帶歸一化文檔元數據的搜尋與研究輸出。該包在法律行業可遷移,需替換論文來源與新聞主題模型、審查法律效力與判例適用性,不自動化出具法律結論。
- 正反論據對照與備忘:智能感知的正反證據備忘(S25)執行「收集證據 → 梳理對象與關係 → 對照正反證據 → 定稿備忘(人工關口)」,配合投資論點證據與結論跟蹤分級來源、區分支援與反駁及複雜情況並保留人工可覆寫結論。該包在金融行業有源數據驗證(產出支援研究而非交易指令,實體與時間口徑仍需對齊),在法律行業可遷移;「對照正反證據」可承接工具保證的獨立核驗結果。
三項技能包均為基於合成數據演示的擬議未集成方案;三項組件雖經靜態源碼檢查標為可用,但目前均未實現上述工具輸出契約、類型化編號或獨立核驗調用——這是我們從文獻提煉的工程要求。本文不構成法律或安全審計建議。
工具調用鏈上線前的三項核查清單
- 核查工具格式化文本與編號類型:確認工具輸出打印搜尋上限、返回數與真實總數、估計與確認標記,並用代碼類型區分不同編號命名空間。
- 核查工具保證是否經獨立步驟驗證:對工具保證增設獨立核驗步驟並展示被證偽斷言;向核查器補齊邊界事實並提問「是否正確」。
- 核查人工關口是否展示覆蓋範圍與反證:在「核對出處」「核對論據」與「定稿備忘」關口同屏展示搜尋上限、截斷總數及被證偽保證。
覺得有用?分享給需要的人。
參考文獻
- [1]
Jeffries, W. (2026). Who verifies the tools? How warped formatters mislead agents and their verifiers (arXiv:2610.32110). arxiv.org ↗
- [2]
Liu, Z., & Gao, S. (2026). Trusting the tool: Asymmetric deference of LLM vulnerability auditors to static-analysis evidence (arXiv:2610.32876). arxiv.org ↗
- [3]
Parasuraman, R., & Manzey, D. H. (2010). Complacency and bias in human use of automation: An attentional integration. *Human Factors*, 52(3), 381–410. doi.org/10.1177/0018720810376055
相關能力
技能包
S17 · 模型網關
帶出處的資料檢索
AI 的回答看似完整,卻説不清出處,難以直接採用。
僅從授權資料中檢索相關段落,摘要標明所引用的段落,經人工核對出處後使用。
- 收集可查資料
- 檢索相關段落
- 撰寫摘要
- 核對出處人工複核
4 步1 處人工複核5 個組件
S24 · 智能感知
研究報告撰寫
撰寫研究報告時,大量時間用於查找資料、核對引用,仍難以説清每句話的出處。
先拆解研究問題,收集材料並標註出處,撰寫帶引用的草稿,論據經人工核對後排版匯出。
- 拆解問題與範圍
- 收集材料
- 撰寫引用草稿
- 核對論據人工複核
- 排版並匯出
5 步1 處人工複核8 個組件
S25 · 智能感知
正反證據備忘
研究判斷只記錄結論,一段時間後難以説清當初的依據與反對意見。
將資料、論點與反證集中記錄,標明支援、反對與存疑,經人工複核後存為可追溯的備忘。
- 收集證據
- 梳理對象與關係
- 對照正反證據
- 定稿備忘人工複核
4 步1 處人工複核8 個組件