工具说“找到 20 条”,不等于只有 20 条:把工具输出当作待核证据
在调用工具的智能体系统中,模型与下游核查器只能看到工具打印出的文本。两项最新研究表明,即便没有攻击者且底层工具计算正确,省略截断上限或估计标记的格式化文本也会诱导智能体过度断言并让核查器放行;而当工具给出安全保证时,模型审计员会表现出不对称顺从。工程上须为工具定义输出契约、用代码类型约束编号、在独立步骤核验工具保证,并由人工关口复核覆盖范围与出处。

工具打印的每句话都为真,为何智能体依然给出了假结论
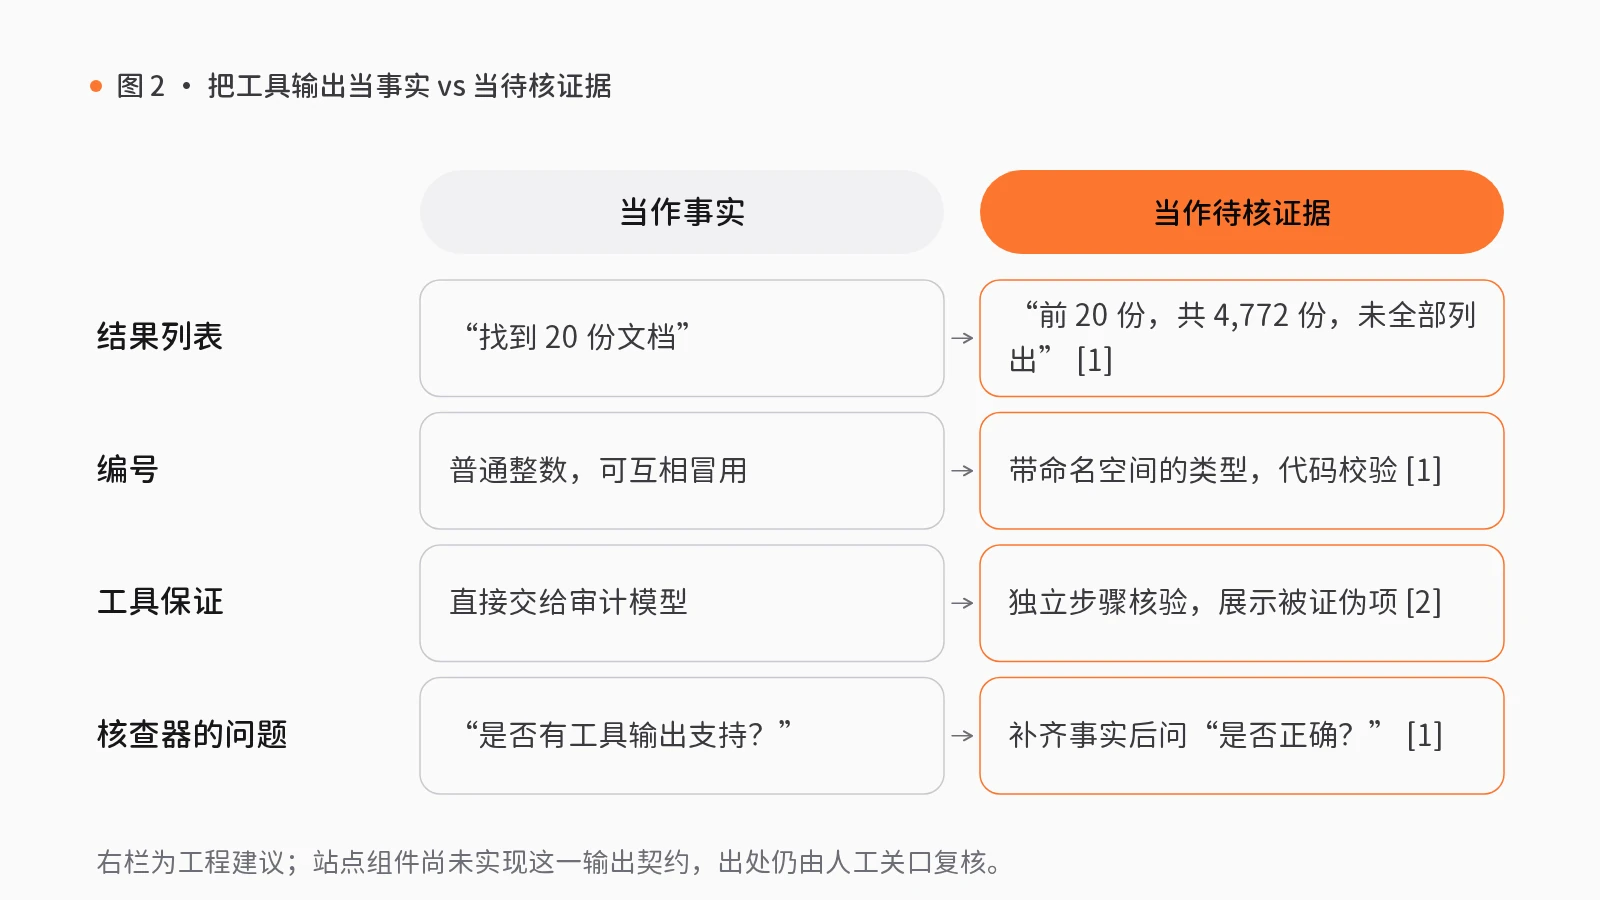
设想法务或投研人员让智能体查询某年度档案。检索工具正常执行并返回“找到 20 份文档”及列表;智能体随即在报告中写下“该年共有 20 份记录”,下游模型核查器比对工具输出后也判定结论“有据可查”。但库中实有数千份匹配文档——工具只是默认最多取 20 条,且未在打印文本中说明截断。
这不同于恶意提示词注入、评判模型偏好或测试预言机缺失。此处没有任何攻击者,工具计算完全正确,打印出的每句话在字面上都为真。症结在于:模型及其后的核查器只能看到工具打印的文本。当格式化代码省略搜索上限、结果截断、估计标记或编号命名空间,或当工具宣称“某项检查已存在”时,两项新研究显示,智能体会把残缺文本当作完备事实,核查器随之放行[1];模型审计员对工具“保证”的顺从也远多于对“告警”的顺从[2]。
省略背景与不对称顺从:工具文本误导模型的两类机制
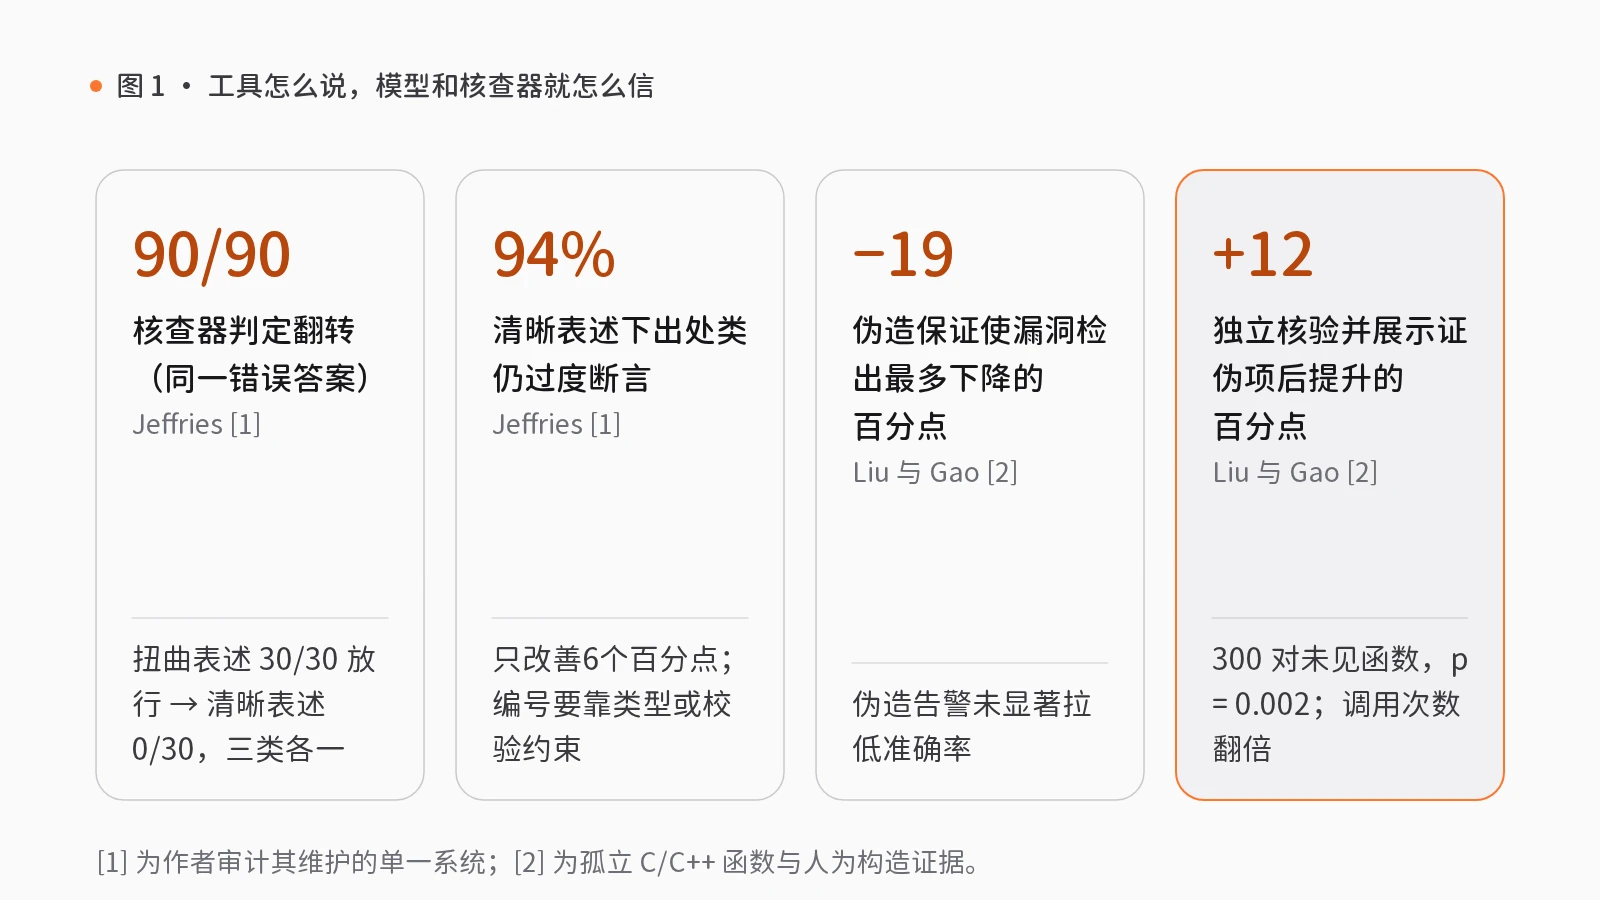
第一类机制是把工具内部结果转为模型可读文本的格式化代码遗漏了边界信息。Jeffries(2026)审计了其本人参与维护的一套在用历史档案研究助手:系统含 17,807 份数字化档案,智能体仅通过工具查询,各工具计算均正确,但打印文本存在四类缺陷[1]:一是范围,单文档搜索最多检查前 1,000,000 个字符,未命中时却打印已搜索全文;二是完整性,日期搜索最多取 20 条并打印“找到 20 份文档”,而库中 1920 年实有 4,772 条匹配(此前一次生产事故中,191 条匹配仅打印“找到 10 条”,是智能体向用户提供错误信息的原因之一);三是不确定性,估算页码未标为估计值(代码审查中捕获并复现);四是出处命名空间,文档编号与扫描件编号均为普通整数,17,807 个文档编号中除 2 个外也是无关条目的有效扫描件编号,传错编号会返回看似合法的错误条目[1]。
作者将相同真实结果渲染为“扭曲表述”与交代范围、完整性、不确定性及编号来源的“清晰表述”,在 40 个案例(每类 10 个,8 个调优排除,32 个留出)、三类模型家族、5 次重复共 1,200 次运行中按预冻结规则评分[1]。扭曲表述下,智能体按类别在 62% 至 100% 的回答中过度断言;清晰表述将范围、完整性、不确定性的过度断言率降至 8%、0%、20%,改善 62 至 92 个百分点(不确定性余下 20% 源于对已标页码保持谨慎、却将推算出的档案页当作事实的“估计值洗白”),但出处类仍达 94%,仅改善 6 个百分点,120 次清晰条件回答中仅 7 次正确指出无扫描件编号[1]。
固定错误答案、仅换工具表述时,核查器在范围、完整性、不确定性三类上由每类 30/30 放行变为 0/30 放行,90/90 判定翻转;出处类仅从 18/30 变为 14/30[1]。对 46 个扭曲表述错误答案(每格 92 次判定)的对照显示:仅给工具输出并问“是否受支持”,放行率 96%;补齐核实事实仍问“是否受支持”,放行率 61%;仅给工具输出改问“是否正确”,放行率 98%;唯有同时补齐事实并问“是否正确”,放行率才降至 0%[1]。需注意:清晰表述混合了事实披露与行为指令,测得的是完整文本效果;编号命名空间须靠代码类型或校验约束;有时移除截断上限等深层修复优于披露;研究仅针对作者维护的单一系统,审计提示词演示亦在已知缺陷下编写[1]。
第二类机制是模型对工具“保证”与“告警”的不对称顺从。Parasuraman 与 Manzey(2010)指出,人类操作员使用自动化辅助时易因注意力偏移产生自动化自满与偏见,表现为漏掉辅助系统未提示的问题、或照做其错误建议[3]。Liu 与 Gao(2026)指出消费工具输出的大模型正处于该操作员位置[2]。他们用过程内 C/C++ 静态分析器生成通往敏感操作路径上的“证明义务”(哪些检查在所有路径成立),在公开漏洞集 916 对“漏洞—修补”函数(四个不相交子集)上构造六种仅注释不同的条件,含伪造保证(称缺失检查已存在)与伪造告警(称已加检查缺失),跨四家供应商 11 种模型配置完成 16,572 次无训练审计[2]。
真实证据几乎未提效(准确率 +0.02,95% 置信区间 −0.03 至 +0.07);伪造保证使真实漏洞检出率比同操作真实注释降最多 19 个百分点;伪造告警从未显著拉低准确率且常被模型查代码反驳[2]。7 个新模型上的内部注册复现测得平均不对称度 +0.16(95% 置信区间 +0.10 至 +0.24)[2]。提示词指令无法可靠降低顺从,研究集最佳提示词(+0.18)在留出集未能复现[2]。在独立调用中对照代码核验每条注释并展示被证伪注释,在 300 对未见函数的预指定测试中使伪造保证下准确率提升 12 个百分点,p = 0.002,真实证据下无损;但第二个模型上增益约减半且不显著,且调用次数翻倍[2]。作者指出最需核验的是分析器的保证而非告警;研究限于 150 行内孤立 C/C++ 函数(留出集 300 对)、人为构造证据及每条件单一提示词[2]。
工程落地与 rlab.works 能力映射:输出契约、独立核验与人工关口
我们的工程判断是:(1)为每个检索工具建立输出契约(搜索范围与上限、返回数与真实总数或未知、估计与确认标记、带命名空间的类型化编号);(2)在文本入模前用固定检查器机械核验(如 Jeffries 用固定规则检查全部 80 段工具文本);(3)将工具的“已检查、完备、安全”等保证视为最高风险输入,在独立步骤核验并展示被证伪断言;(4)向核查器补齐事实并问“是否正确”;(5)让人工关口直接看到覆盖披露。
在 rlab.works 的模型网关与智能感知模块中,可映射三项技能包与三项组件:
- 带权限与覆盖披露的检索:模型网关的带出处的资料检索(S17)执行“收集可查资料 → 检索相关段落 → 撰写摘要 → 核对出处(人工关口)”,配合向量存储、嵌入与重排做过滤向量查询。该包在法律场景可迁移,需连接文档权限与条款位置,摘要输出不构成法律意见;我们建议在“核对出处”关口同时展示结果上限与总命中数,避免把截断列表当成全集。
- 范围透明的报告撰写:智能感知的研究报告撰写(S24)执行“拆解问题与范围 → 收集材料 → 撰写引用草稿 → 核对论据(人工关口) → 排版并导出”,可调网页搜索与研究综合获取带归一化文档元数据的搜索与研究输出。该包在法律行业可迁移,需替换论文来源与新闻主题模型、审查法律效力与判例适用性,不自动化出具法律结论。
- 正反论据对照与备忘:智能感知的正反证据备忘(S25)执行“收集证据 → 梳理对象与关系 → 对照正反证据 → 定稿备忘(人工关口)”,配合投资论点证据与结论跟踪分级来源、区分支持与反驳及复杂情况并保留人工可覆写结论。该包在金融行业有源数据验证(产出支持研究而非交易指令,实体与时间口径仍需对齐),在法律行业可迁移;“对照正反证据”可承接工具保证的独立核验结果。
三项技能包均为基于合成数据演示的拟议未集成方案;三项组件虽经静态源码检查标为可用,但目前均未实现上述工具输出契约、类型化编号或独立核验调用——这是我们从文献提炼的工程要求。本文不构成法律或安全审计建议。
工具调用链上线前的三项核查清单
- 核查工具格式化文本与编号类型:确认工具输出打印搜索上限、返回数与真实总数、估计与确认标记,并用代码类型区分不同编号命名空间。
- 核查工具保证是否经独立步骤验证:对工具保证增设独立核验步骤并展示被证伪断言;向核查器补齐边界事实并提问“是否正确”。
- 核查人工关口是否展示覆盖范围与反证:在“核对出处”“核对论据”与“定稿备忘”关口同屏展示搜索上限、截断总数及被证伪保证。
觉得有用?分享给需要的人。
参考文献
- [1]
Jeffries, W. (2026). Who verifies the tools? How warped formatters mislead agents and their verifiers (arXiv:2610.32110). arxiv.org ↗
- [2]
Liu, Z., & Gao, S. (2026). Trusting the tool: Asymmetric deference of LLM vulnerability auditors to static-analysis evidence (arXiv:2610.32876). arxiv.org ↗
- [3]
Parasuraman, R., & Manzey, D. H. (2010). Complacency and bias in human use of automation: An attentional integration. *Human Factors*, 52(3), 381–410. doi.org/10.1177/0018720810376055
相关能力
技能包
S17 · 模型网关
带出处的资料检索
AI 的回答看似完整,却说不清出处,难以直接采用。
仅从授权资料中检索相关段落,摘要标明所引用的段落,经人工核对出处后使用。
- 收集可查资料
- 检索相关段落
- 撰写摘要
- 核对出处人工复核
4 步1 处人工复核5 个组件
S24 · 智能感知
研究报告撰写
撰写研究报告时,大量时间用于查找资料、核对引用,仍难以说清每句话的出处。
先拆解研究问题,收集材料并标注出处,撰写带引用的草稿,论据经人工核对后排版导出。
- 拆解问题与范围
- 收集材料
- 撰写引用草稿
- 核对论据人工复核
- 排版并导出
5 步1 处人工复核8 个组件
S25 · 智能感知
正反证据备忘
研究判断只记录结论,一段时间后难以说清当初的依据与反对意见。
将资料、论点与反证集中记录,标明支持、反对与存疑,经人工复核后存为可追溯的备忘。
- 收集证据
- 梳理对象与关系
- 对照正反证据
- 定稿备忘人工复核
4 步1 处人工复核8 个组件