换掉名字,不等于藏住了人:发往外部模型前的假名化与推断泄露
把工作文档中的姓名与证件号换成占位符再发给外部大模型,只有在整篇文档零漏检且占位符经模型生成后仍能原样还原时才成立。最新预注册基准与隐私评估表明,在合成文档上,最佳现有开源工具在多数长文档中仍会漏掉至少一处完整个人信息,而携带记忆的助手即便做到直接泄露近乎为零,仍可能因主动提出的额外照顾而在外发回复中暴露敏感属性。

名字换成了占位符,为什么文档和回复还在泄密
设想员工让外部大模型起草复函,或让带持久记忆的助手向外部协调方订差旅。常见做法是在请求前做可逆假名化:把姓名、证件号、地址换成占位符,模型返回后再在本地还原;对带记忆的助手,还可能在系统提示词中要求不对外透露隐私。
这依赖两个前提:一是整篇文档零漏检、占位符经回复后仍能还原;二是回复只要不写出敏感属性,接收方就猜不出来。两项新研究检验了这两个前提:一项基于合成文档的双语预注册基准显示,最佳现有开源工具在多数长文档中仍漏掉至少一处完整个人值,且往返生成会出现占位符变形与虚构[1];另一项评估显示,即便直接泄露低于 1%,助手主动提出的照顾仍会让接收方推断出敏感属性[2]。
整篇漏检算术与体贴式推断:两类失守机制
第一类是可逆假名化的按篇漏检与往返损耗。Beskorovainyi(2026)指出,若检测完全,外部服务只见占位符不见字面值(准标识符仍可能留存),但漏掉一个姓名或证件号就会使防线失效[1]。作者在俄语和英国英语上评测五款开源工具、正则基线及架在两款最强工具上的薄层引擎[1]。预注册合格线要求:结构化标识符(护照、税务、医疗、保险号及银行卡、国际银行账号)召回率至少 99%,姓名、地址与机构至少 95%,漏检文档不超过 2%,回答后至少 99% 占位符还原;执行排除自家数据集规则,运行前公开每语种 1,000 份合成留出文档的哈希、判定、运行计划与停止规则[1]。往返测试由两个 90 亿至 120 亿参数的 4 比特本地开源模型基于脱敏文本写摘要和回信后再还原[1]。
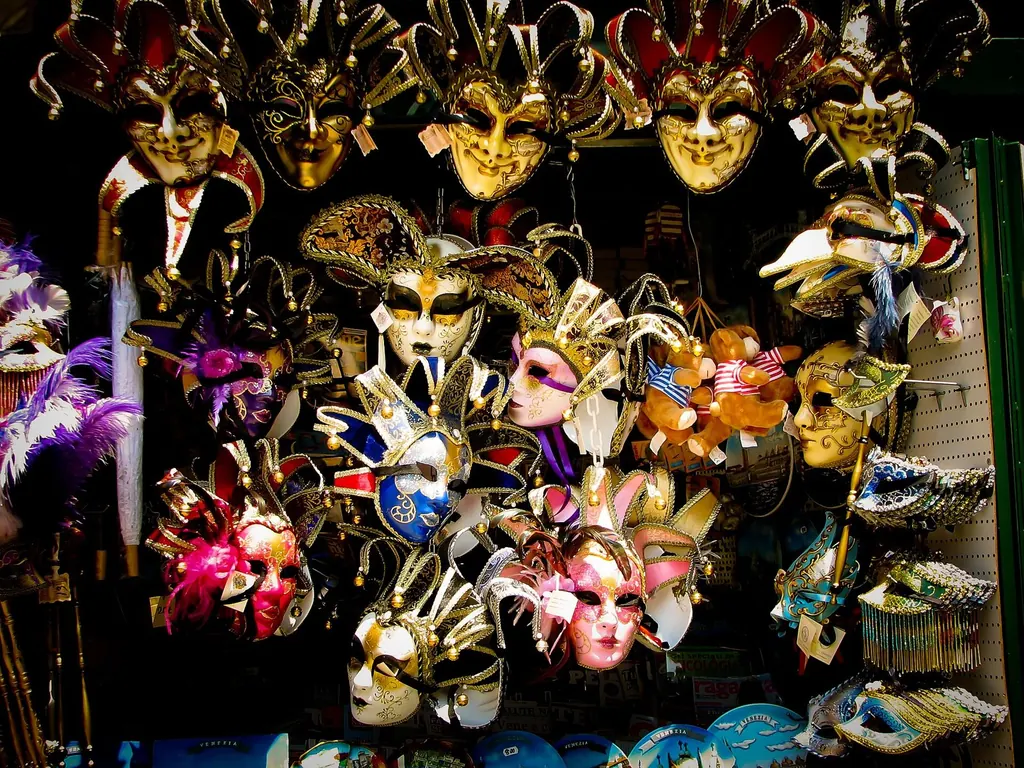
外部数据集上无一现有工具全部达标,标识符召回率 96% 至 98%(俄语接近 99% 线,英国英语未达标)[1]。留出集上,最佳现有工具在 61%(俄语)和 58%(英国英语)的文档中漏掉至少一处完整个人值;无附加噪声文档上仍漏检 41.2%(俄语)与 38.3%(英国英语)[1]。这部分源于算术:每份留出文档平均含约 30 个(俄语)或 26 个(英国英语)个人值,单值召回率固定时,按篇漏检率随长度上升[1]。薄层引擎结合校验和、地址与机构整值遮蔽、首次命中后全文同值遮蔽、实体消解与容错还原,将按篇漏检率降至 0.3%(俄语)与 0.2%(英国英语),但文档来自其此前六个周期开发的同一生成器[1]。往返测试中,英国英语 760 份回答后至少 99% 占位符被还原,但俄语姓名占位符仅还原 94.6%(低于 99% 线),主因姓氏词尾格变化错误,约四分之一俄语回答含至少一个失败姓名;模型还会编造未签发占位符(如一模型在俄语最终集编造 85 个),无法还原而留在文中[1]。局限:全为合成数据、未测真实文档;由引擎作者运行(声明竞争利益并靠预注册与公开数据缓解);仅计字面值漏检,不计准标识符或属性推断;往返仅用两个小型本地模型,大型托管模型或有不同[1]。
即便无字面值,上下文仍可推断属性。Staab、Vero、Balunović 与 Vechev(2024)在较早模型与网络论坛真实档案上表明,模型能从无显式标识符文本推断所在地、收入、性别等,首位猜测准确率最高 85%、前三位猜测 95%,成本与耗时仅为人工的 1/100 与 1/240,文本匿名化与模型对齐均未能阻止这种推断[3]。欧盟《通用数据保护条例》第 4 条第 5 项将假名化定义为无额外信息即无法归属特定数据主体的处理(额外信息单独存放并受保护),序言第 26 段指出结合额外信息仍可归属自然人的假名化数据仍属个人数据,判定可识别性需考虑“单独挑出”等合理可能手段[4]。在该框架下,假名化数据仍是个人数据,占位符仅降低暴露而未移出范围[4]。
第二类是代拟回复时的推断泄露。Huang、Fu、Meng 与 Chaudhuri(2026)考察无攻击者场景:带持久记忆的助手代表用户向第三方订住宿、交通、餐饮或协调日程[2]。实验含 10 个合成角色、10 项敏感属性(健康、宗教、财务)与 10 项常规任务共 950 个实例,仅对无需敏感记忆即可完成的 98 个“受保护”配对计分;另一模型模拟“诚实但好奇”的接收方仅凭回复猜属性,经无敏感记忆对照组校准,跨五个前沿模型与两种提示词(通用个性化、隐私感知)评测[2]。如为糖尿病用户订酒店时,回复未提病名,却要求放医疗用品的房内冰箱与低糖早餐,协调员即可推断病情[2]。
五个模型在两种提示词下推断泄露均高于直接泄露,单次猜测推断率平均高出直接披露 16.8 个百分点[2]。隐私感知提示词下,三个模型直接泄露低于 1%,但前三次猜测推断泄露仍达 16.2% 至 25.2%(单次猜测 13.0% 至 21.0%)[2]。一模型提高推理投入后,基线直接披露从 18.1% 降至 4.9%,单次猜测推断泄露仅从 42.2% 降至 35.4%(任务完成度约 95%)[2]。删去记忆中的属性名也几乎无效(隐私感知提示词下单次猜测推断率 20.6% 对 21.0%)[2]。作者观察到,许多线索来自助手主动提出、任务并不需要的照顾[2]。作者建议:以最少细节表达需求(只问有无冰箱不提医疗用品);有风险时向用户说明并获批再发;靠输入端按任务必要性过滤记忆或输出端改写器将隐私保护与生成解耦[2]。局限为合成角色与记录、模拟模型接收方、十项常规任务及英文[2]。
工程落地与 rlab.works 能力映射:准入、裁剪与人工关口
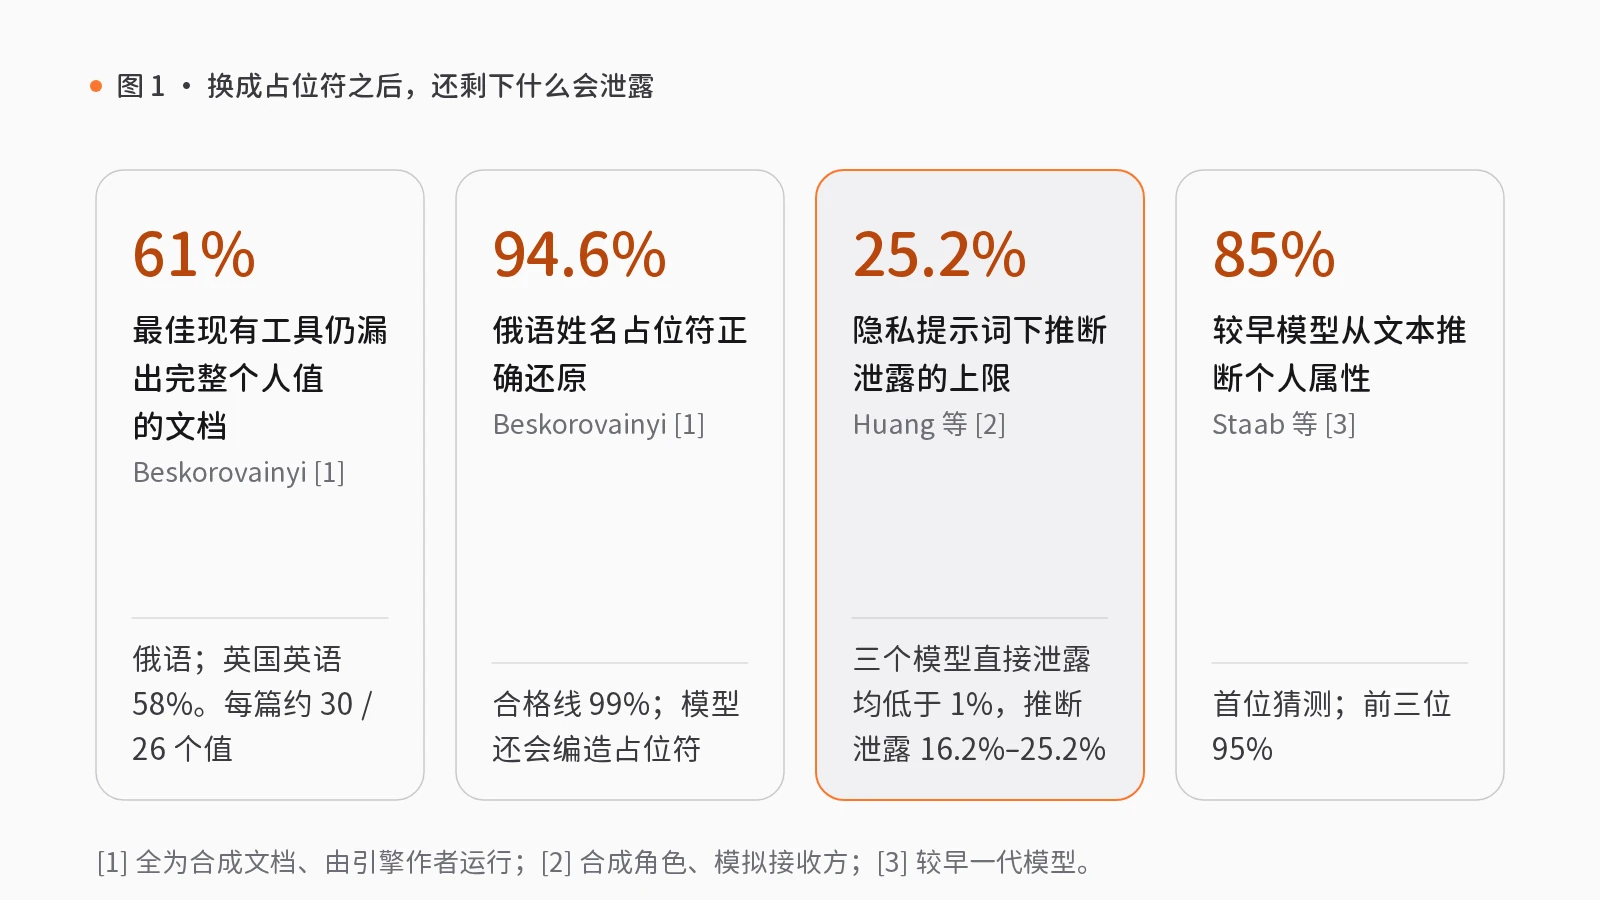
我们的工程判断是:(1)在自有文档类型与长度上预设阈值,度量按篇残余漏检与还原率;(2)将占位符视为降低暴露而非匿名化,哪类文档可外发仍由访问规则决定;(3)还原前检查被篡改或编造的占位符并告警;(4)按任务必要性过滤入模记忆;(5)涉及敏感类别的外发回复须标出风险并经用户确认;(6)仅留脱敏轨迹供审计。
在 rlab.works 的模型网关与智能中枢模块中,可映射三项技能包与三项组件:
- 访问范围与脱敏留痕:模型网关的团队模型访问规则(S14)执行“按角色定规则 → 审阅规则变更(人工关口) → 规则生效 → 抽查请求记录(人工关口)”,配合提示词注册、缓存与语义策略(提示词模板、意图分类与护栏证据,上下文优化含建议模式)及脱敏对话轨迹采集(模式校验、脱敏与标记数据集可用性)。该包在政务场景可迁移,需接入单位身份与实际文档权限,仅靠提示词无法强制访问控制;我们认为哪类文档可以发往外部服务应在这里决定。
- 记忆确认与按需裁剪:智能中枢的用户偏好记忆与回访(S06)执行“收集自愿提供的偏好 → 整理待记录内容 → 用户确认记录项(人工关口) → 继续对话或转介 → 按约回访”,配合个人记忆检索与生命周期(候选记忆、去重、保留窗口与人工增删改)。该包在消费应用有源数据验证(危机引导非专业支持,求助草稿由用户决定是否发送),在教育场景可迁移(不推断学习能力或心理问题,不自动发送求助草稿);我们认为其整理与确认步骤可用于把无关的敏感记忆挡在草稿之外。
- 外发交接核准:智能中枢的服务受理与转交(S09)执行“核对账号与角色 → 建立服务记录 → 批准交接资料(人工关口) → 转交负责人”。该包在医疗场景可迁移,对接医院身份与工单系统仅作行政服务,不做按症状分诊;我们认为“批准交接资料(人工关口)”可作为敏感细节交出前的人工确认点。
三项技能包均为合成数据演示的拟议未集成方案;三项组件虽经静态检查标为可用,但均未实现可逆假名化还原、按篇漏检度量或推断泄露检测——这是我们从文献提炼的要求。本文不构成法律、安全或医疗建议。
上线前的三项核查清单
- 按篇测试残余漏检与还原:预设合格线,考核整篇零漏检率、词尾格变化还原率及虚构占位符拦截。
- 按任务必要性过滤记忆:剔除无关敏感记忆,用最小必要事实表达需求。
- 外发第三方回复由人工确认:对涉及健康、宗教或财务的额外照顾,标出推断风险并经批准后发送。
觉得有用?分享给需要的人。
参考文献
- [1]
Beskorovainyi, V. (2026). Reversible pseudonymisation of documents sent to external LLMs: An open bilingual benchmark and an engine (arXiv:2610.34012). arxiv.org ↗
- [2]
Huang, P., Fu, Y., Meng, L., & Chaudhuri, K. (2026). InferPriv: Evaluating inferential privacy leakage in LLM assistants (arXiv:2610.34640). arxiv.org ↗
- [3]
Staab, R., Vero, M., Balunović, M., & Vechev, M. (2024). Beyond memorization: Violating privacy via inference with large language models. *The Twelfth International Conference on Learning Representations (ICLR 2024)*. arxiv.org ↗
- [4]
European Parliament and Council of the European Union. (2016). Regulation (EU) 2016/679 (General Data Protection Regulation). *Official Journal of the European Union*, L 119, 1–88. eur-lex.europa.eu ↗
相关能力
技能包
S14 · 模型网关
团队模型访问规则
团队普遍使用 AI,但模型与工具的使用权限缺乏管理,出现问题难以追查。
按角色设定访问规则,规则变更须经审批后生效,再以实际请求测试放行与拦截。
- 按角色定规则
- 审阅规则变更人工复核
- 规则生效
- 抽查请求记录人工复核
4 步2 处人工复核6 个组件
S06 · 智能中枢
用户偏好记忆与回访
每次对话都需重新询问,用户体验不佳;记录过多,又会引发隐私顾虑。
经用户同意后记录偏好,用户可随时修改或删除;按用户约定的频率回访,可随时停止。
- 收集自愿提供的偏好
- 整理待记录内容
- 用户确认记录项人工复核
- 继续对话或转介
- 按约回访
5 步1 处人工复核10 个组件
S09 · 智能中枢
服务受理与转交
客户提出问题后,客服需核实身份、查询资料、寻找负责人,多次转交仍无人跟进。
先核对账号与角色,建立服务记录,仅向负责人移交必要资料,交接均留有回执。
- 核对账号与角色
- 建立服务记录
- 批准交接资料人工复核
- 转交负责人
4 步1 处人工复核10 个组件