单次调用更便宜,成功交付却更贵:智能体的「每次成功交付成本」
智能体成本通常按单次调用或单次尝试汇报,但真实业务结果取决于多步决策、故障恢复与完工核验。当廉价决策模型省下的单步开销被辅助推理、拉长的交互、失败恢复与过早宣告完工吞噬时,计入失败重试后的每次成功交付成本可能持平甚至上升。

单步账单缩水与总账超支:智能体成本的核算错位
设想一个企业智能体试点:技术团队把动作选择换成更轻、更便宜的模型后,网关看板上的单次调用均价与单步延迟明显下降。但当财务与运营把月度总账和实际办结的工单对起来看时,每笔有效业务的平均支出可能几乎没变,排查卡住的运行、撤回“假完工”的人工负担反而可能加重。若不按完整交付结果核算,单步层面的账面节约就可能被异常处置与人工监督抵消。
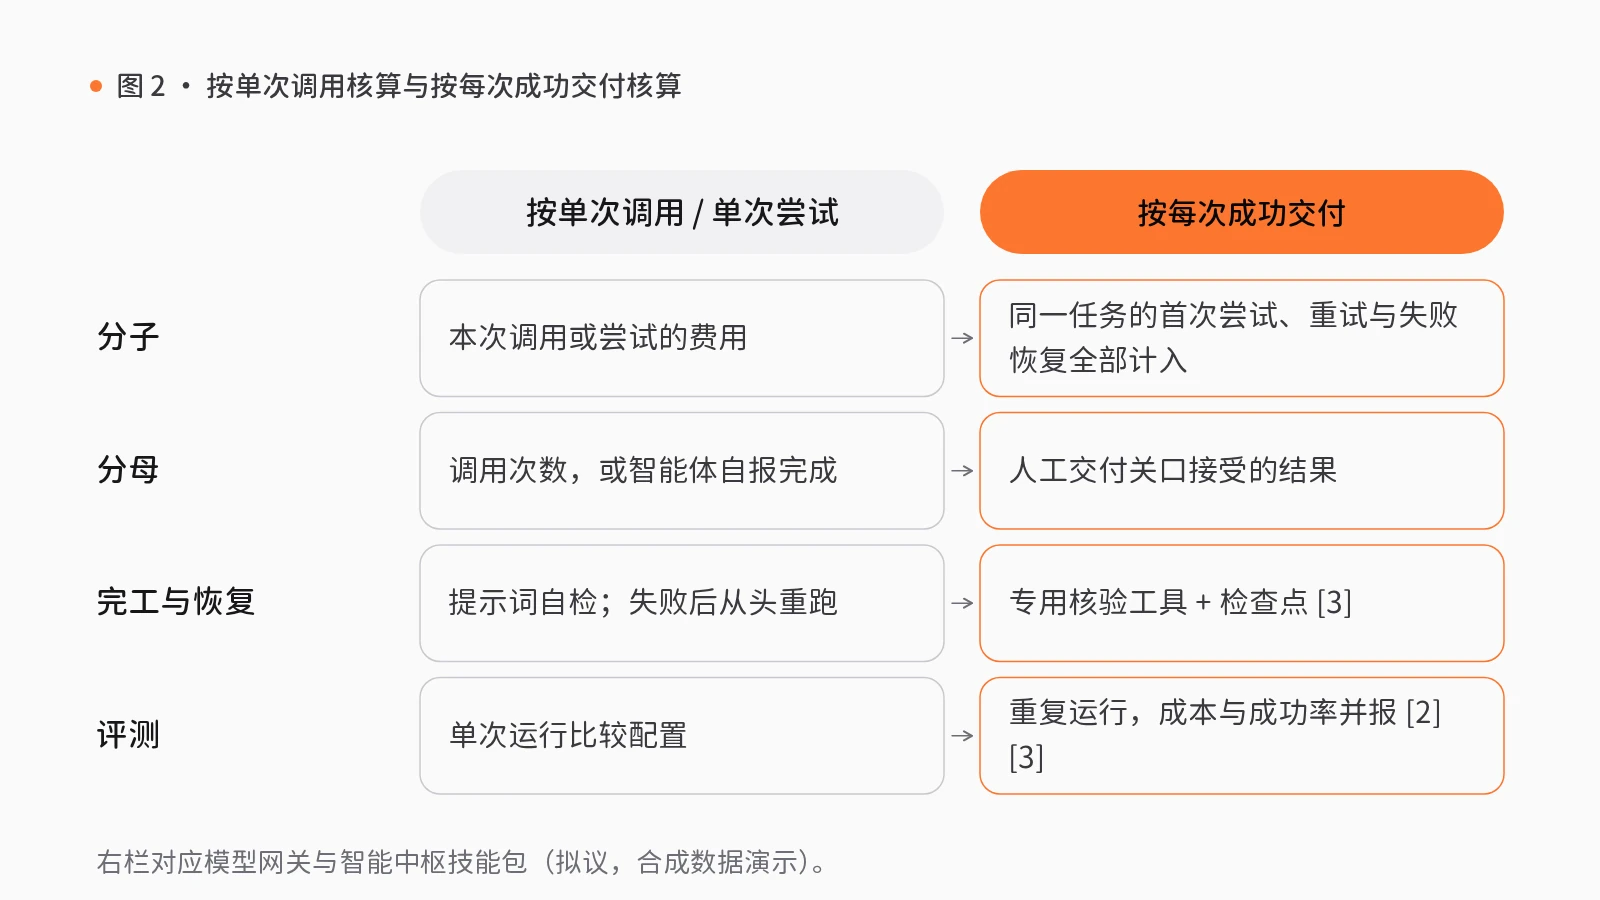
这一反差源于核算口径错位。智能体成本通常按单次调用或单次尝试汇报,但业务结果依赖一连串决策、故障恢复与完工核验。廉价决策模型虽能压低单步成本,但外围辅助推理、拉长的交互、失败恢复与过早宣告完工会将省下的开销悉数吸收——若将失败尝试计入分子、以最终被接受的成功交付作为分母,每次成功交付成本可能持平甚至上升。因此,评测必须兼顾成本与重复运行,而完工核验与进度保护也应固化为系统组件而非提示词请求。
为什么「更快更省」的决策未必造就更经济的智能体
三项关于智能体工作流与评测方法学的研究,从决策节约吸收、成本与准确率联合优化以及系统级方差分解拆解了这一机制。
Ling、Yu、Chen 与 Fang(2026)在包含 134 项任务的文本家居环境与涵盖 116 类任务的移动应用环境中评估了五个智能体家族,每个配置重复运行三次,共执行 4,500 次任务,对比原始大模型动作选择与一种快速、低价的结构化决策模型[1]。在单步层面,五个智能体家族的平均决策成本下降 66.1% 至 78.4%,决策时间缩短 73.9% 至 81.5%;尽管每次决策词元数上升 53.5% 至 134.9%,更低的单价仍带来显著单步节约[1]。
但在完整工作流层面,辅助推理与额外交互吸收了单步节约。文本家居任务成功率接近基线(仅落后 1.49 与 1.74 个百分点),而移动应用环境中两个智能体的成功率分别下跌 13.22 与 18.10 个百分点,第三个下跌 2.30 个百分点[1]。按「每次成功交付成本」(含失败尝试的总成本除以成功次数)计算,四个智能体家族指标下降,但其中一个移动智能体尽管单次尝试成本下降 17.1%,每次成功交付成本的观测均值却从 68.70 毫美元升至 73.97 毫美元,上升 7.7%(其 95% 置信区间跨越零点,应视为观测均值变化而非已证实的显著效应);另一移动智能体的每次成功交付耗时则从 239.4 秒升至 377.8 秒[1]。
吞噬节约的症结在于恢复失败与过早宣告完工。某一配置中,仅 2.0% 的执行就因无效恢复消耗了 53.3% 的推理总支出;在持续失败案例中,快速决策模型的 57 次执行中有 40 次恢复失败,而基线 57 次中仅有 3 次[1]。启用跨尝试反思时,快速决策变体首次尝试成功率虽更高(383/402 即 95.27%,基线为 376/402 即 93.53%),却仅挽回 19 次初始失败中的 11 次,远低于基线 26 次中的 25 次,最终总成功率更低[1]。此外还存在过早宣告完工,例如点击标有“关闭”的开关便宣告成功,而无线网络仍处于关闭状态[1]。作者总结,工作流必须保护进度、支持恢复并核验完工,以成功交付、恢复表现与每次交付消耗的资源评估价值[1]。
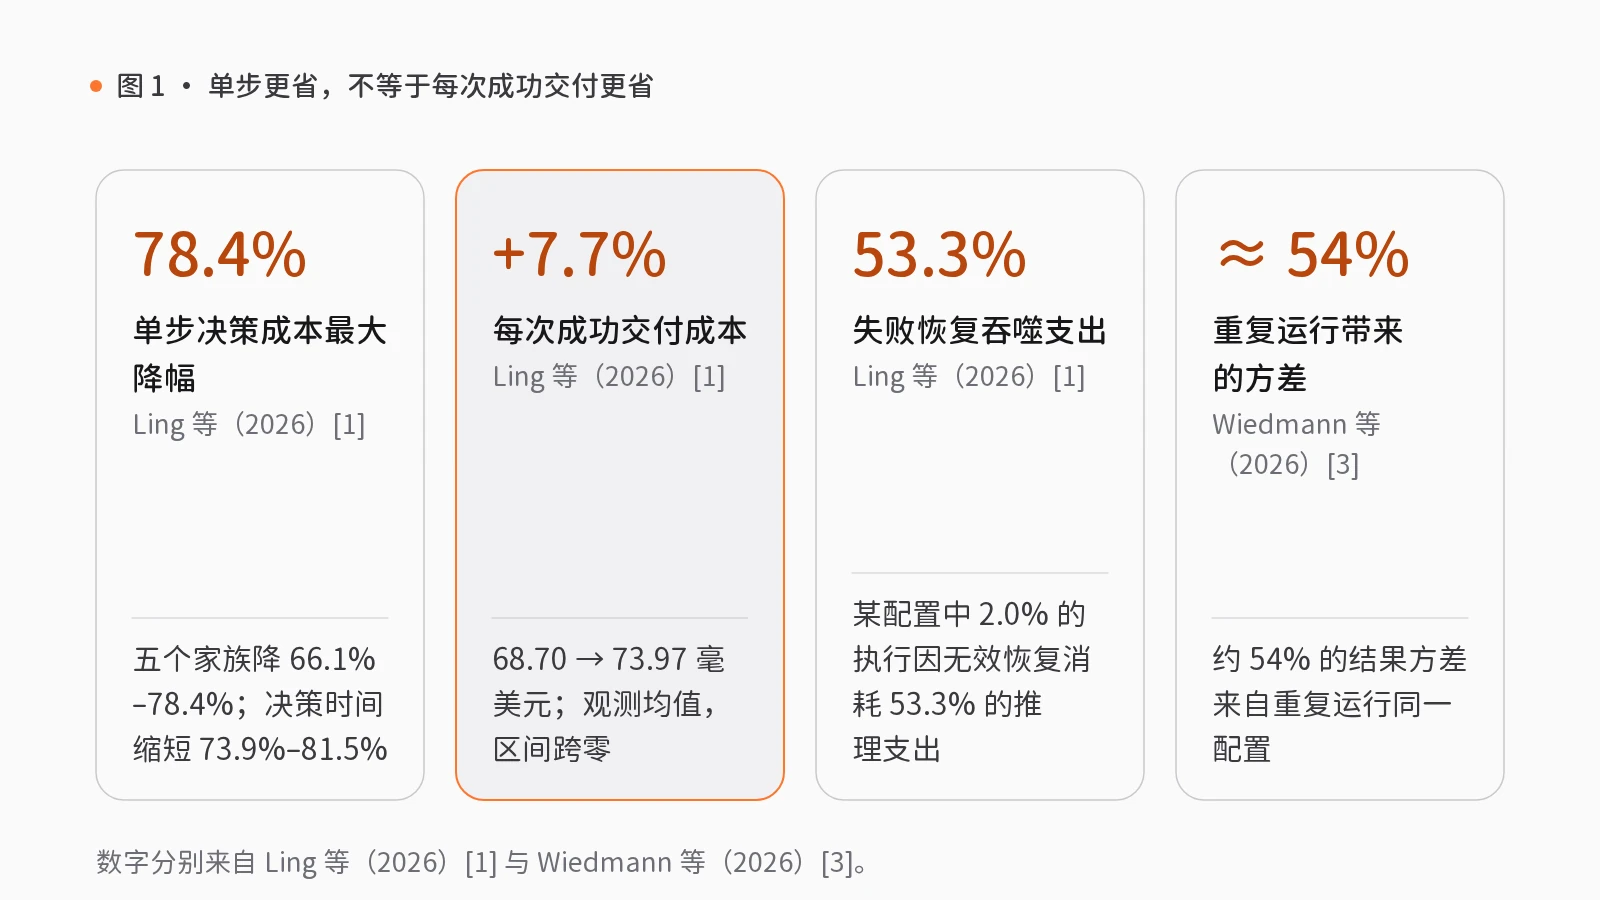
Wiedmann、Girrbach、Schmid 与 Akata(2026)在涵盖四项科学任务(要求编码智能体查找并操作已发布专用模型)、释放逾 18,000 条轨迹的研究中指出,智能体是可配置系统而非单一模型[3]。对比任务信息、推理、自我核验、时间预算与骨干模型五个部分后发现,在该基准上约 54% 的结果方差来自重复运行同一配置而非改变配置;提供给智能体的任务信息影响最大,超过时间预算与模型规模,同时能降低成本并改善校准度;增加时间仅在信息充足或模型足够强时有效[3]。尤其关键的是,用提示词要求核验答案对核验行为影响甚微,而提供专用核验工具则能显著改变核验行为[3]。
面向「每次成功交付」的工程核算与系统架构
我们认为,上述结论指向明确的工程准则:不能以智能体自报完成作为核算终点,也不能靠提示词防范无效恢复。在 rlab.works 的模型网关与智能中枢模块中,我们建议为每次模型与工具调用绑定任务与运行标识,将失败与重试开销归集至同一任务账本,并以人工交付关口验收通过的结果作为分母。
在模型网关层,技能包模型用量与费用核算按“预留预算 → 提交任务 → 逐笔记账 → 人工对账(人工关口)”运行。它在公共服务与金融场景均为可迁移应用;金融场景的适配边界是研究工具运营成本核算,需指定单一计费归口并统一单位,绝不用于金融交易清算。底层由两项处于可用状态的组件支撑:
- 用量预留、预算、版本化定价与结算:预留并结算用量、执行预算硬约束、核对已定价或未定价账本凭证,我们认为可借此为失败恢复循环设定预算上限,避免其无节制消耗算力。
- 网关用量、财务、可靠性与集群分析:追踪请求、延迟、错误率、缓存节约、用量与成本。我们认为,看板应将失败与重试归入主任务,直接报告失败支出占比及每次被接受交付的累计耗时与成本。
在智能中枢层,技能包中断任务接续执行通过“找回历史记录 → 确认接续点(人工关口) → 继续运行 → 验收结果(人工关口)”保护进度,依托处于可用状态的组件**可恢复的智能体运行时与上下文管理**实现准入控制、上下文预算、持久化事件、检查点与重放以及可重连运行。它在消费应用中为可迁移应用,适配边界是导入的历史记录不得触发自动新执行或自动扣费,恢复运行必须使用原生检查点或显式确认新任务。
最终交付分母由技能包复杂任务拆解与执行界定。它在制造业中为可迁移应用,在其他场景作为通用模式复用,于范围审批与交付复核处设人工关口。我们认为,应把完工核验实现为交付关口前的专用工具步骤,仅将人工交付关口正式接受的结果计入成功交付分母。
上线前的三项成本与可靠性核查清单
在替换决策模型或扩建智能体工作流前,工程与财务团队可执行三项核查:
- 重构核算分母与失败支出口径:按任务归集首次尝试、重试与失败放弃的全部成本,除以人工交付关口接受的产出数,同步追踪失败支出占比与每次成功交付耗时。
- 把检查点与完工核验做成系统组件:不依赖提示词自检,配置独立核验工具与原生检查点,确保失败从有效检查点恢复且历史导入不触发自动扣费。
- 补齐任务信息并执行多次重复评测:鉴于有研究观察到约 54% 的结果方差来自重复运行同一配置,任何配置比选都应包含重复运行,并优先改善任务信息与工具契约。
觉得有用?分享给需要的人。
参考文献
- [1]
Ling, Y., Yu, S., Chen, Z., & Fang, C. (2026). When Faster Decisions Do Not Make Better Agents: An Empirical Study of Jev in Agent Workflows (arXiv:2610.13092). arxiv.org ↗
- [2]
Kapoor, S., Stroebl, B., Siegel, Z. S., Nadgir, N., & Narayanan, A. (2024). AI Agents That Matter (arXiv:2407.01502). arxiv.org ↗
- [3]
Wiedmann, L., Girrbach, L., Schmid, C., & Akata, Z. (2026). Agents Are Systems, Not Models: Rethinking Agentic Evaluation (arXiv:2610.01618). arxiv.org ↗
相关能力
技能包
S13 · 模型网关
模型用量与费用核算
模型账单月底才出具,超支后也难以说明费用花在哪些请求上。
调用前预留预算,运行后按每次请求记账,对不上的差异逐条列出。
- 预留预算
- 提交任务
- 逐笔记账
- 人工对账人工复核
4 步1 处人工复核5 个组件
S02 · 智能中枢
中断任务接续执行
长时间运行的任务因断线、超时或重启而中断,往往只能从头开始。
找回历史记录与中断位置,经人工确认接续点后继续运行,并验收结果。
- 找回历史记录
- 确认接续点人工复核
- 继续运行
- 验收结果人工复核
4 步2 处人工复核6 个组件

S01 · 智能中枢
复杂任务拆解与执行
交由 AI 处理的复杂任务常中途停止或偏离目标,进度也无从查看。
先将目标拆解为有序的任务清单,经人工确认范围后执行,交付前再次验收。
- 拆解任务清单
- 确认执行范围人工复核
- 逐项执行
- 验收交付人工复核
4 步2 处人工复核7 个组件