自动派单还是转人工?把成本感知弃权当作上线前的就绪检验
由于错误路由的业务代价通常高于人工分拣,仅凭分类准确率无法判断自动派单何时值得信赖。将成本感知弃权作为上线前的离线就绪评估——在显式成本假设下用校准集选定阈值、冻结策略并在留出集上做一次性评测——能够检验置信度信号是否具备真实的错误排序能力,并在信号薄弱时将「全部转人工」作为合理的上线拦截结论。

为什么整体准确率不能回答「这张工单敢不敢自动派发」
企业在内部信息技术服务台或客服队列引入自动分单时,上线评审往往围绕测试集整体准确率展开。一旦接入提示词驱动的大语言模型,看到样例能输出工单类别与高置信度分数,团队便容易认为只要设一个置信度阈值,就能自动派发把握大的工单、把不确定的留给人工。
但生产路由并非对称猜谜。把工单派给错误团队会引发跨部门退单与延误,代价可能高于入口处的人工分拣[1]。当错误路由代价高于人工分拣时,仅凭整体准确率无法说明何时应信赖自动路由器。同时,弃权只能作为暴露薄弱置信度信号的护栏,而不能修复分类器本身。把“自动派单还是转人工”建立在显式成本假设与离线冻结评测之上,才是上线前的就绪检验。
从错误—拒识权衡到成本感知弃权:离线就绪评估的文献机制
对不确定输入选择拒识源于 Chow(1970)的错误—拒识权衡理论:拒识(转交人工)以牺牲覆盖率换取更低错误率,最优阈值取决于错误与拒识的相对代价[3]。而在现代神经网络中套用该规则会遇到校准问题:Guo 等人(2017)指出,现代神经网络普遍校准不良(置信度不等于真实正确概率);事后校准(如温度缩放)可以有效修正概率水平[4]。至于校准后的分数能否把错误排在正确预测之后(即排序区分度),则是另一个问题,正是下文研究要检验的。
围绕内部信息技术工单,Gupta(2026)将 Chow 式错误—拒识框架落地为离线、成本条件化的就绪评估:在显式成本下于校准集选定“路由或转人工”策略,将其冻结,再于留出测试集做一次性评估[1]。研究采用含 47,837 张内部信息技术工单、8 个类别的公开数据集,按 70/10/20 分层划分为训练、校准与测试集(33,486 / 4,784 / 9,567 张),对比 4 个受训非大语言模型分类器与 4 个大语言模型在零样本及少样本下的 8 种提示词条件(在分层抽取的 1,000 张测试子集上评测)[1]。
论文设定了**说明性(非实测)**的单张工单成本:正确自动路由为 0,人工分拣为 1,错误路由为 5;作者强调这只是说明性假设而非实测数据,所有结论均以它为前提,各组织须估算自身成本[1]。在 0/1/5 说明性成本下,盈亏平衡正确概率为 0.80(仅当正确概率达到 0.80 时才自动路由)[1]。实验呈现四项核心结果:
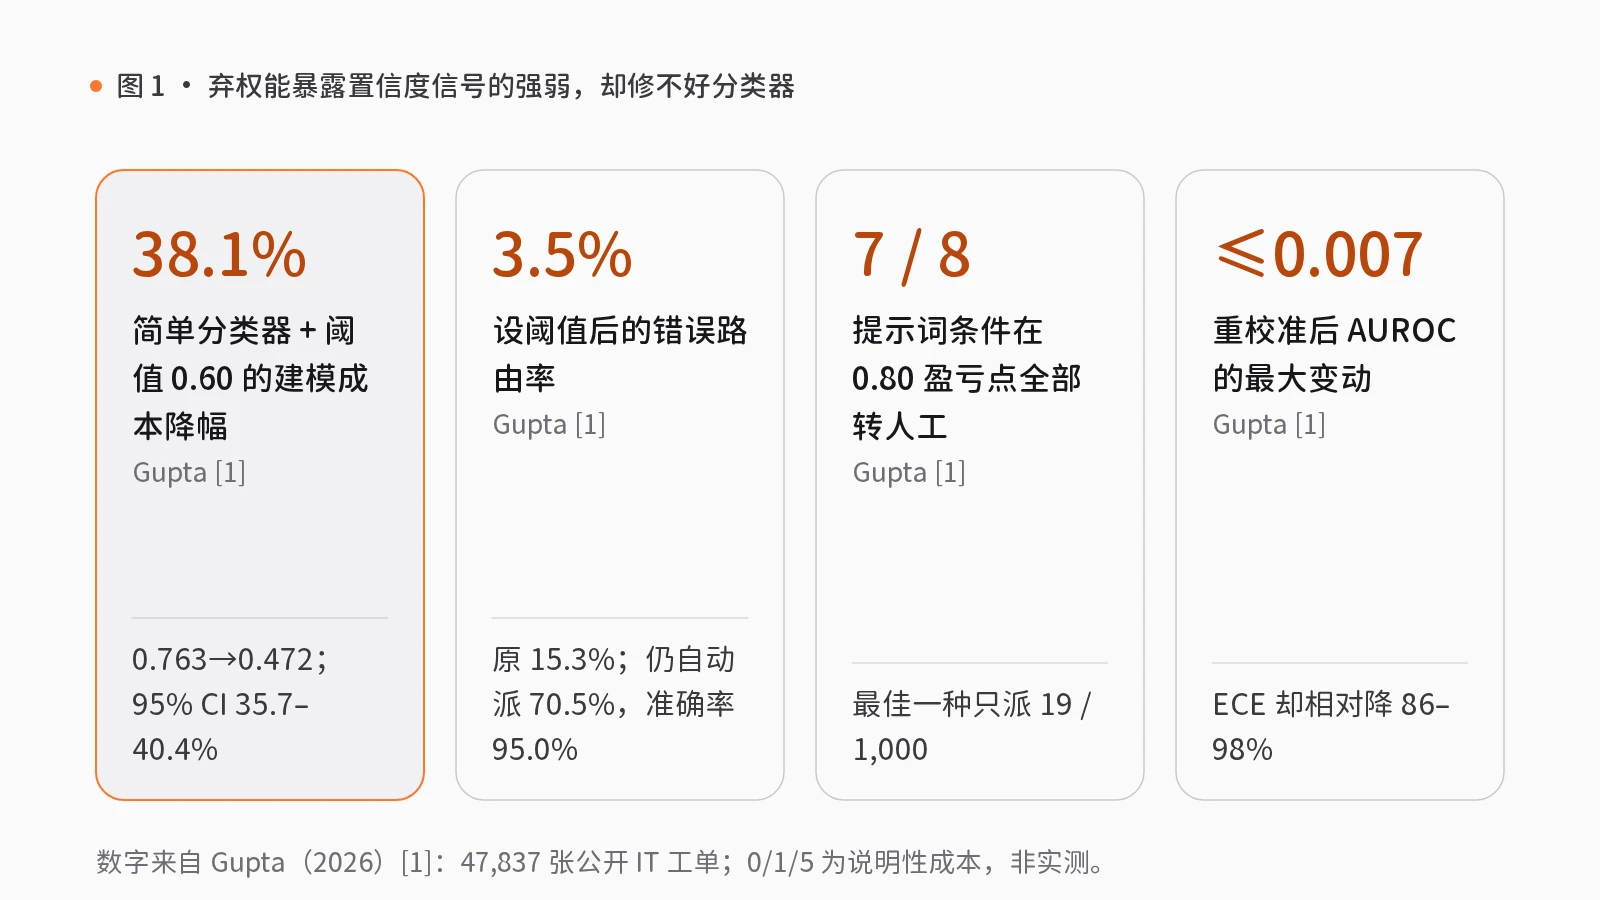
- 简单受训分类器显著降低建模成本:词频逆文档频率(TF-IDF)加逻辑回归的简单受训文本分类器基线,在校准集选定阈值 0.60 并冻结;在留出测试集上,按上述说明性成本计算,单张工单期望成本从 0.763 降至 0.472,相对降幅 38.1%(95% 置信区间 35.7%–40.4%),错误路由从 15.3% 降至 3.5%,仍自动路由 70.5% 的工单且在已路由工单上准确率达 95.0%[1]。4 个受训分类器的相对成本降幅集中在 35.5%–38.1%;跨 16 组说明性成本设定的事后敏感性分析中,校准集冻结策略在 14 组设定下均优于“全部自动路由”与“全部转人工”(等成本边界处校准集选择全部自动路由)[1]。
- 准确率差距与公平前提:在 1,000 张测试子集上,最佳提示词配置准确率为 0.477,微调小型编码器模型在同一子集上为 0.879[1]。必须说明:受训模型从 33,486 张标注工单中学习了分类体系,而提示词模型仅获类别名称与最多 24 个示例且无类别定义,并非纯粹能力对比[1]。
- 重校准无法创造排序区分度:所有提示词模型均过度自信;保序回归重校准虽将期望校准误差(ECE)相对降低 86%–98%,但正确性受试者工作特征曲线下面积(AUROC)最多仅变动 0.007;一种提示词配置对所有工单均输出相同置信度(1.000),正确性 AUROC 停留在 0.500——重校准无法创造原始分数中没有的排序信息[1]。
- 盈亏平衡规则下的「全部转人工」:在 0/1/5 说明性成本对应的 0.80 盈亏平衡规则下,8 种提示词条件中有 7 种在 1,000 张工单上路由 0 张(全部转人工),最佳的 1 种仅路由 19 张(全部正确)——这只是极低覆盖率观测,而非广泛可用策略的证据[1]。作者强调,“弃权不会修好薄弱的分类器”,它是“护栏而非修复手段”;该研究是特定数据集、提示词、接口与说明性成本下的评估框架,而非新算法或通用上线认证[1]。
工程落地与 rlab.works 能力映射:拆分预测、置信度与路由策略
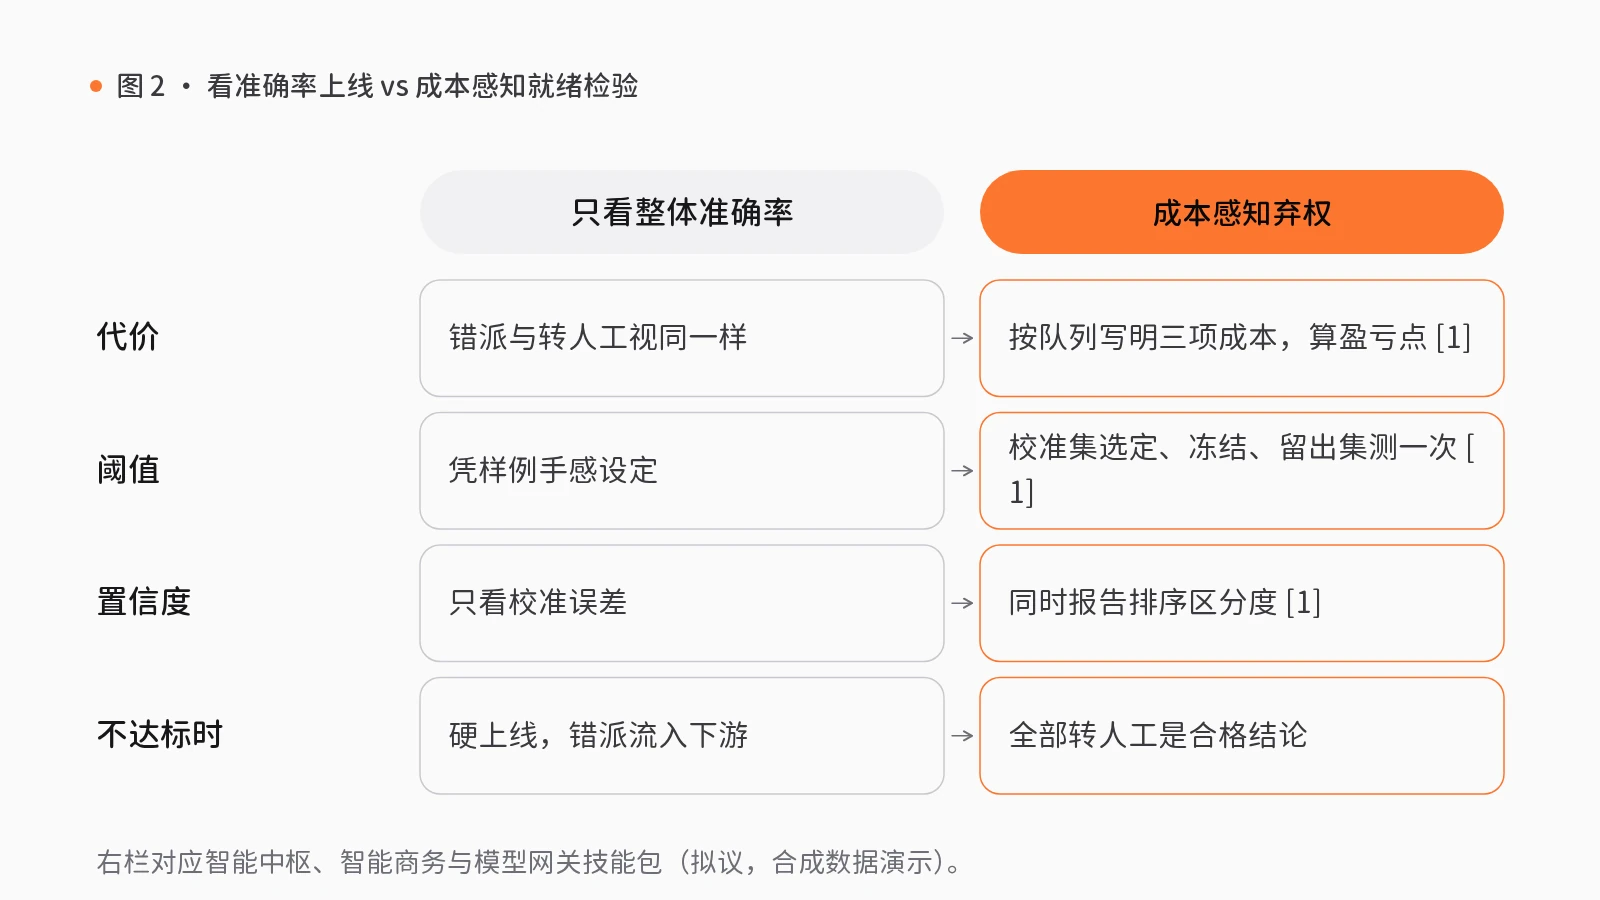
我们的工程判断是:上线前应按队列写明三项成本,将预测器、置信度信号与阈值策略拆为可独立审计的阶段,在校准集选定阈值后冻结并在影子模式下做一次性测试,将区分度(AUROC 与风险—覆盖率)与校准误差并列报告,把“全部转人工”视为合格的上线否决结果,把转人工做成带上下文的一等队列路由,并在成本、分布或模型变化时重测。
在 rlab.works 的智能中枢、智能商务与模型网关模块中,可用三项技能包与三项组件对照这套机制及适配边界:
- 受理与交接队列:智能中枢的服务受理与转交(S09)按“核对账号与角色 → 建立服务记录 → 批准交接资料(人工复核) → 转交负责人”运行。弃权转人工时,系统经由客服工单与通知收件箱(管理工单、通知收件箱、分派、优先级、部门与历史)登记上下文,并由可审计工作流、人工确认与决策复盘暂停等待人工分拣决定。需说明:该技能包仅在医疗健康标为可迁移,且仅限行政服务,不按症状分诊;用于内部信息技术服务台属需重接本地身份与工单系统的可迁移模式,无已验证的内部服务台投产声明。
- 客服与权益人工裁决:智能商务的会员权益与客服处理(S36)按“核对身份与权益 → 计算费用 → 客服决定处理(人工复核) → 通知并留存”运行,在消费应用中标为可迁移(登录状态不等同于付费权益),可配合工单收件箱与可审计工作流承接弃权工单。
- 模型对比与影子评估:模型网关的模型对比与切换(S12)按“检查可选模型 → 样例对比 → 审阅切换建议(人工复核) → 设定主备模型 → 切换后抽查(人工复核)”运行,在企业服务中为可迁移(须用实际样本核验,不承诺自动选出最优模型),可借助模型对比与影子评估在数据集上对比模型并收集离线影子评估证据。
需如实说明现状边界:三项技能包均为合成数据演示的“拟议未集成”编排;工单收件箱与影子评估组件虽评为“可用”,但仅基于静态源码检查,可审计工作流组件为原型(工具步骤仅为记录与占位)。且这些组件均未实现论文的弃权框架或成本阈值路由器。
自动派单上线前的三项成本感知就绪核查清单
上线前可执行三项核查:
- 写明队列专属成本并计算盈亏平衡点:切勿照搬文献中 0/1/5 的说明性假设;按队列估算正确路由、人工分拣与错误路由代价,明确自动放行所需的最低正确概率。
- 冻结校准阈值并同时核查校准度与排序区分度:解耦预测、置信度与策略;若重校准后正确性 AUROC 仍接近随机,或冻结策略在盈亏平衡点将几乎全部工单转人工,应判定未达就绪度,可把用领域标注工单训练的分类器作为对照方案。
- 把「转交人工」建成携带上下文的一等路由:确保弃权工单附带候选类别、校准概率与审计记录进入人工队列,并在成本、分布或模型变更时重做评测。
觉得有用?分享给需要的人。
参考文献
- [1]
Gupta, S. (2026). Cost-aware abstention for LLM-based IT ticket classification (arXiv:2610.31657). arxiv.org ↗
- [2]
Demir, M. M. (2026). Commit or abstain? System One decision models, LLMs, and missing legal authority (arXiv:2610.29961). arxiv.org ↗
- [3]
Chow, C. K. (1970). On optimum recognition error and reject tradeoff. *IEEE Transactions on Information Theory*, 16(1), 41–46. doi.org/10.1109/TIT.1970.1054406
- [4]
Guo, C., Pleiss, G., Sun, Y., & Weinberger, K. Q. (2017). On calibration of modern neural networks. In *ICML 2017*. arxiv.org ↗
相关能力
技能包
S09 · 智能中枢
服务受理与转交
客户提出问题后,客服需核实身份、查询资料、寻找负责人,多次转交仍无人跟进。
先核对账号与角色,建立服务记录,仅向负责人移交必要资料,交接均留有回执。
- 核对账号与角色
- 建立服务记录
- 批准交接资料人工复核
- 转交负责人
4 步1 处人工复核10 个组件
S36 · 智能商务
会员权益与客服处理
会员咨询折扣与积分时,客服需在多个系统中核实身份、计算费用,争议处理缓慢。
先核对身份与会员权益,计算使用权益后的费用,争议由客服决定处理方式,结果通知会员并留存记录。
- 核对身份与权益
- 计算费用
- 客服决定处理人工复核
- 通知并留存
4 步1 处人工复核6 个组件
S12 · 模型网关
模型对比与切换
新模型不断推出,更换担心效果下降,不换又担心落后。
用同一批样例对比新旧模型的质量、错误与费用差异,再确定主用与备用模型。
- 检查可选模型
- 样例对比
- 审阅切换建议人工复核
- 设定主备模型
- 切换后抽查人工复核
5 步2 处人工复核7 个组件