自動派單還是轉人工?把成本感知棄權當作上線前的就緒檢驗
由於錯誤路由的業務代價通常高於人工分揀,僅憑分類準確率無法判斷自動派單何時值得信賴。將成本感知棄權作為上線前的離線就緒評估——在顯式成本假設下用校準集選定閾值、凍結策略並在留出集上做一次性評測——能夠檢驗置信度信號是否具備真實的錯誤排序能力,並在信號薄弱時將「全部轉人工」作為合理的上線攔截結論。

為什麼整體準確率不能回答「這張工單敢不敢自動派發」
企業在內部資訊技術服務枱或客服隊列引入自動分單時,上線評審往往圍繞測試集整體準確率展開。一旦接入提示詞驅動的大語言模型,看到樣例能輸出工單類別與高置信度分數,團隊便容易認為只要設一個置信度閾值,就能自動派發把握大的工單、把不確定的留給人工。
但生產路由並非對稱猜謎。把工單派給錯誤團隊會引發跨部門退單與延誤,代價可能高於入口處的人工分揀[1]。當錯誤路由代價高於人工分揀時,僅憑整體準確率無法説明何時應信賴自動路由器。同時,棄權只能作為暴露薄弱置信度信號的護欄,而不能修復分類器本身。把「自動派單還是轉人工」建立在顯式成本假設與離線凍結評測之上,才是上線前的就緒檢驗。
從錯誤—拒識權衡到成本感知棄權:離線就緒評估的文獻機制
對不確定輸入選擇拒識源於 Chow(1970)的錯誤—拒識權衡理論:拒識(轉交人工)以犧牲覆蓋率換取更低錯誤率,最優閾值取決於錯誤與拒識的相對代價[3]。而在現代神經網絡中套用該規則會遇到校準問題:Guo 等人(2017)指出,現代神經網絡普遍校準不良(置信度不等於真實正確概率);事後校準(如温度縮放)可以有效修正概率水平[4]。至於校準後的分數能否把錯誤排在正確預測之後(即排序區分度),則是另一個問題,正是下文研究要檢驗的。
圍繞內部資訊技術工單,Gupta(2026)將 Chow 式錯誤—拒識框架落地為離線、成本條件化的就緒評估:在顯式成本下於校準集選定「路由或轉人工」策略,將其凍結,再於留出測試集做一次性評估[1]。研究採用含 47,837 張內部資訊技術工單、8 個類別的公開數據集,按 70/10/20 分層劃分為訓練、校準與測試集(33,486 / 4,784 / 9,567 張),對比 4 個受訓非大語言模型分類器與 4 個大語言模型在零樣本及少樣本下的 8 種提示詞條件(在分層抽取的 1,000 張測試子集上評測)[1]。
論文設定了**説明性(非實測)**的單張工單成本:正確自動路由為 0,人工分揀為 1,錯誤路由為 5;作者強調這只是説明性假設而非實測數據,所有結論均以它為前提,各組織須估算自身成本[1]。在 0/1/5 説明性成本下,盈虧平衡正確概率為 0.80(僅當正確概率達到 0.80 時才自動路由)[1]。實驗呈現四項核心結果:
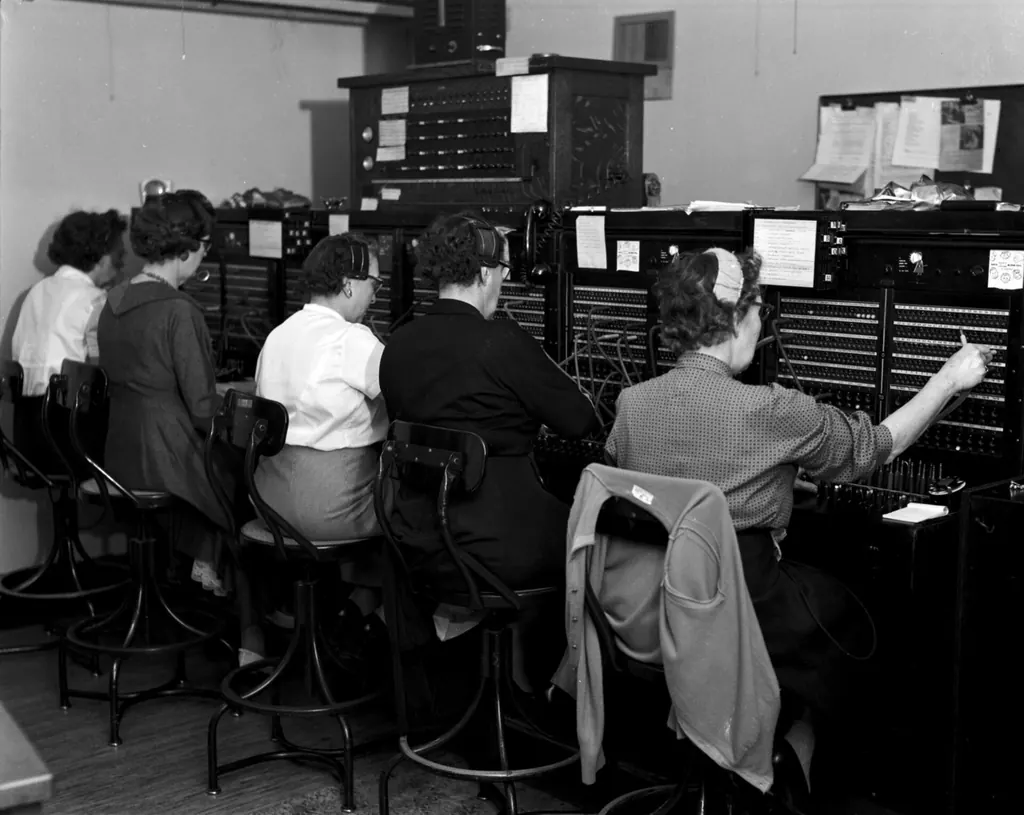
- 簡單受訓分類器顯著降低建模成本:詞頻逆文檔頻率(TF-IDF)加邏輯迴歸的簡單受訓文本分類器基線,在校準集選定閾值 0.60 並凍結;在留出測試集上,按上述説明性成本計算,單張工單期望成本從 0.763 降至 0.472,相對降幅 38.1%(95% 置信區間 35.7%–40.4%),錯誤路由從 15.3% 降至 3.5%,仍自動路由 70.5% 的工單且在已路由工單上準確率達 95.0%[1]。4 個受訓分類器的相對成本降幅集中在 35.5%–38.1%;跨 16 組説明性成本設定的事後敏感性分析中,校準集凍結策略在 14 組設定下均優於「全部自動路由」與「全部轉人工」(等成本邊界處校準集選擇全部自動路由)[1]。
- 準確率差距與公平前提:在 1,000 張測試子集上,最佳提示詞配置準確率為 0.477,微調小型編碼器模型在同一子集上為 0.879[1]。必須説明:受訓模型從 33,486 張標註工單中學習了分類體系,而提示詞模型僅獲類別名稱與最多 24 個示例且無類別定義,並非純粹能力對比[1]。
- 重校準無法創造排序區分度:所有提示詞模型均過度自信;保序迴歸重校準雖將期望校準誤差(ECE)相對降低 86%–98%,但正確性受試者工作特徵曲線下面積(AUROC)最多僅變動 0.007;一種提示詞配置對所有工單均輸出相同置信度(1.000),正確性 AUROC 停留在 0.500——重校準無法創造原始分數中沒有的排序資訊[1]。
- 盈虧平衡規則下的「全部轉人工」:在 0/1/5 説明性成本對應的 0.80 盈虧平衡規則下,8 種提示詞條件中有 7 種在 1,000 張工單上路由 0 張(全部轉人工),最佳的 1 種僅路由 19 張(全部正確)——這只是極低覆蓋率觀測,而非廣泛可用策略的證據[1]。作者強調,「棄權不會修好薄弱的分類器」,它是「護欄而非修復手段」;該研究是特定數據集、提示詞、接口與説明性成本下的評估框架,而非新算法或通用上線認證[1]。
工程落地與 rlab.works 能力映射:拆分預測、置信度與路由策略
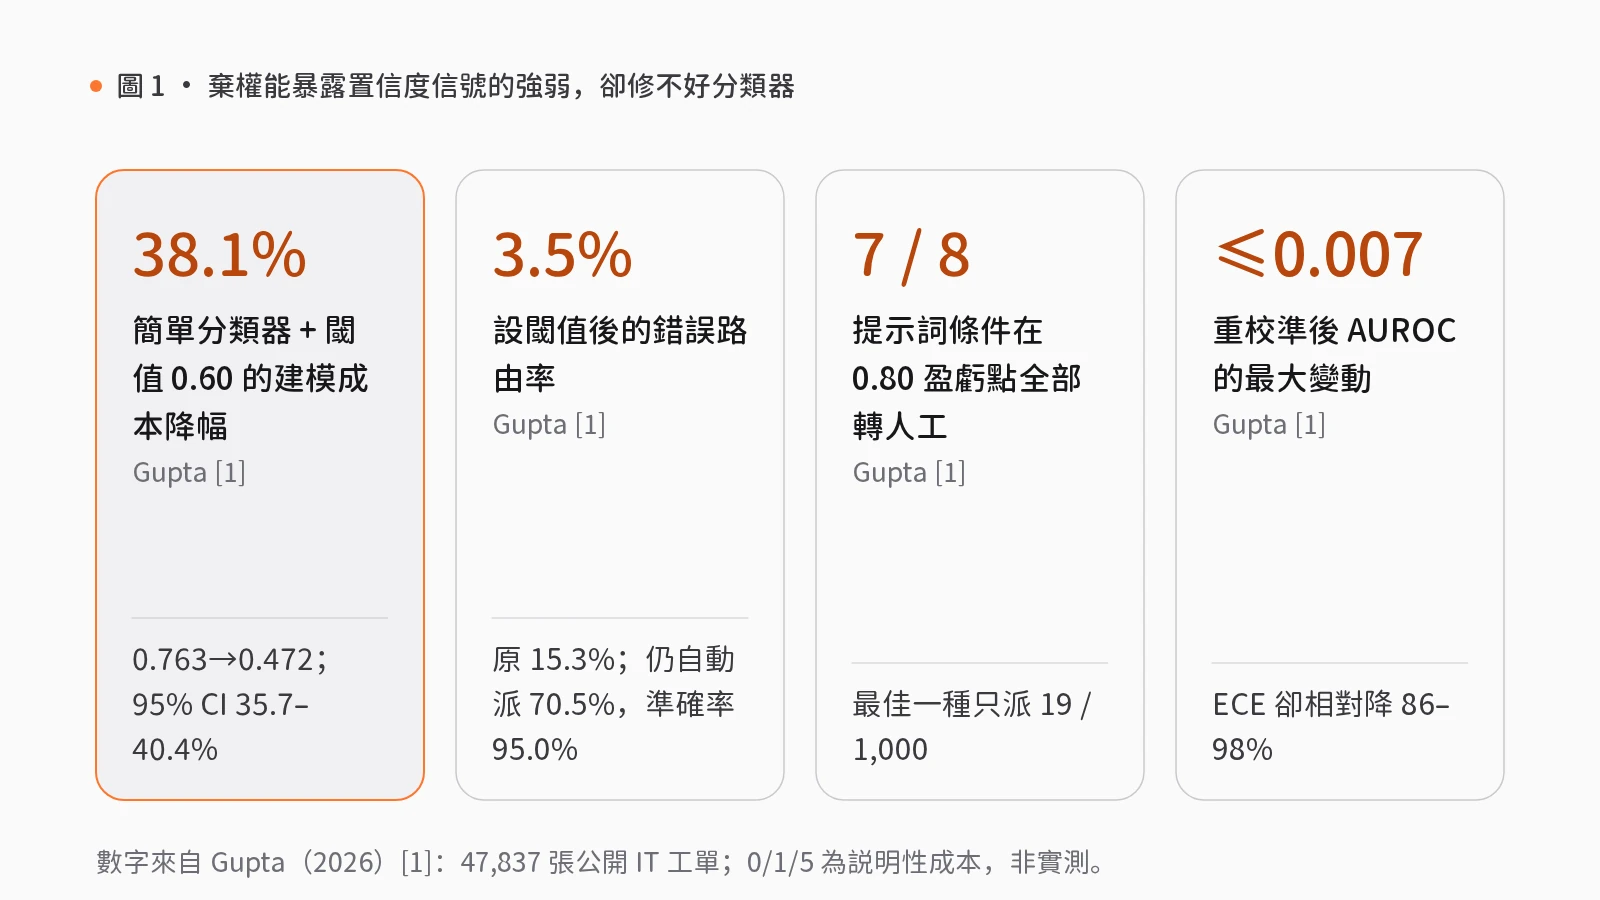
我們的工程判斷是:上線前應按隊列寫明三項成本,將預測器、置信度信號與閾值策略拆為可獨立審計的階段,在校準集選定閾值後凍結並在影子模式下做一次性測試,將區分度(AUROC 與風險—覆蓋率)與校準誤差並列報告,把「全部轉人工」視為合格的上線否決結果,把轉人工做成帶上下文的一等隊列路由,並在成本、分佈或模型變化時重測。
在 rlab.works 的智能中樞、智能商務與模型網關模組中,可用三項技能包與三項組件對照這套機制及適配邊界:
- 受理與交接隊列:智能中樞的服務受理與轉交(S09)按「核對帳戶與角色 → 建立服務記錄 → 批准交接資料(人工複核) → 轉交負責人」運行。棄權轉人工時,系統經由客服工單與通知收件箱(管理工單、通知收件箱、分派、優先級、部門與歷史)登記上下文,並由可審計工作流、人工確認與決策復盤暫停等待人工分揀決定。需説明:該技能包僅在醫療健康標為可遷移,且僅限行政服務,不按症狀分診;用於內部資訊技術服務枱屬需重接本地身份與工單系統的可遷移模式,無已驗證的內部服務枱投產聲明。
- 客服與權益人工裁決:智能商務的會員權益與客服處理(S36)按「核對身份與權益 → 計算費用 → 客服決定處理(人工複核) → 通知並留存」運行,在消費應用中標為可遷移(登入狀態不等同於付費權益),可配合工單收件箱與可審計工作流承接棄權工單。
- 模型對比與影子評估:模型網關的模型對比與切換(S12)按「檢查可選模型 → 樣例對比 → 審閲切換建議(人工複核) → 設定主備模型 → 切換後抽查(人工複核)」運行,在企業服務中為可遷移(須用實際樣本核驗,不承諾自動選出最優模型),可藉助模型對比與影子評估在數據集上對比模型並收集離線影子評估證據。
需如實説明現狀邊界:三項技能包均為合成數據演示的「擬議未集成」編排;工單收件箱與影子評估組件雖評為「可用」,但僅基於靜態源碼檢查,可審計工作流組件為原型(工具步驟僅為記錄與佔位)。且這些組件均未實現論文的棄權框架或成本閾值路由器。
自動派單上線前的三項成本感知就緒核查清單
上線前可執行三項核查:
- 寫明隊列專屬成本並計算盈虧平衡點:切勿照搬文獻中 0/1/5 的説明性假設;按隊列估算正確路由、人工分揀與錯誤路由代價,明確自動放行所需的最低正確概率。
- 凍結校準閾值並同時核查校準度與排序區分度:解耦預測、置信度與策略;若重校準後正確性 AUROC 仍接近隨機,或凍結策略在盈虧平衡點將幾乎全部工單轉人工,應判定未達就緒度,可把用領域標註工單訓練的分類器作為對照方案。
- 把「轉交人工」建成攜帶上下文的一等路由:確保棄權工單附帶候選類別、校準概率與審計記錄進入人工隊列,並在成本、分佈或模型變更時重做評測。
覺得有用?分享給需要的人。
參考文獻
- [1]
Gupta, S. (2026). Cost-aware abstention for LLM-based IT ticket classification (arXiv:2610.31657). arxiv.org ↗
- [2]
Demir, M. M. (2026). Commit or abstain? System One decision models, LLMs, and missing legal authority (arXiv:2610.29961). arxiv.org ↗
- [3]
Chow, C. K. (1970). On optimum recognition error and reject tradeoff. *IEEE Transactions on Information Theory*, 16(1), 41–46. doi.org/10.1109/TIT.1970.1054406
- [4]
Guo, C., Pleiss, G., Sun, Y., & Weinberger, K. Q. (2017). On calibration of modern neural networks. In *ICML 2017*. arxiv.org ↗
相關能力
技能包
S09 · 智能中樞
服務受理與轉交
客戶提出問題後,客服需核實身份、查詢資料、尋找負責人,多次轉交仍無人跟進。
先核對帳戶與角色,建立服務記錄,僅向負責人移交必要資料,交接均留有回執。
- 核對帳戶與角色
- 建立服務記錄
- 批准交接資料人工複核
- 轉交負責人
4 步1 處人工複核10 個組件
S36 · 智能商務
會員權益與客服處理
會員諮詢折扣與積分時,客服需在多個系統中核實身份、計算費用,爭議處理緩慢。
先核對身份與會員權益,計算使用權益後的費用,爭議由客服決定處理方式,結果通知會員並留存記錄。
- 核對身份與權益
- 計算費用
- 客服決定處理人工複核
- 通知並留存
4 步1 處人工複核6 個組件
S12 · 模型網關
模型對比與切換
新模型不斷推出,更換擔心效果下降,不換又擔心落後。
用同一批樣例對比新舊模型的質素、錯誤與費用差異,再確定主用與備用模型。
- 檢查可選模型
- 樣例對比
- 審閲切換建議人工複核
- 設定主備模型
- 切換後抽查人工複核
5 步2 處人工複核7 個組件