不確定性能發現失敗,卻找不到該插手的那一步
在多步智能體運行中,高不確定性雖能在軌跡層面提示失敗風險,卻難以定位真正值得幹預的步驟;對原本能成功的軌跡隨意糾偏反而會拉低任務得分。工程上需將「是否干預、在哪一步干預、採用何種機制」拆分為獨立決策,用實測干預收益增量替代單純的失敗標籤訓練監控器,並為成功軌跡設定嚴格的誤觸發預算。

當不確定性觸發器變成多步運行裏的干擾源
部署多步工具調用智能體時,工程團隊常依賴一條直覺設計運行期監控:實時追蹤模型的不確定性或低置信度信號;一旦指標越過閾值,便立即觸發自我反思、審查器反饋、調用更強模型或注入記憶等糾偏機制。
但在生產流程中,把不確定性閾值直接當成干預開關往往事與願違。系統頻繁打斷智能體,不僅推高延遲與成本,還常改壞原本能走通的路徑;而在真正需要干預的關鍵分叉步上,不確定性卻未必最高。這一悖論源於混淆了兩個問題:不確定性信號可以提示哪條軌跡正在走向失敗,卻無法可靠定位在哪一步插手才能帶來正收益。工程上須將「是否干預、在哪一步干預、採用何種機制」拆開,基於實測干預收益增量訓練監控器,並為成功軌跡設定嚴格的誤觸發預算。
從不確定性到行動:步驟級反事實收益表與糾偏價值學習
從置信度校準與自評文獻看,識別錯誤與定位干預價值之間本就存在斷層。Guo 等人(2017)指出,現代神經網絡的置信度常相對於真實準確率存在校準偏差;即便完成校準,對正確率的靜態概率刻畫也不等於序列決策中「此刻介入能否改善結果」的指南[3]。Kadavath 等人(2022)研究了語言模型評估自身答案正確性的概率信號(P(True) 自評)[2]。當這類信號進入多步智能體閉環時,能否指導中途糾偏?
Li 等人(2026)通過構建步驟級結果表(SOT)展開了反事實測量[1]。作者在三個基準(應用接口、家庭文本與購物模擬)上,針對兩個開源權重智能體與四種糾偏機制——自我反思、審查器反饋、更強模型協助及基於記憶的引導——收集了 1,864 條基礎軌跡,在每個非終止步驟發起反事實糾偏並運行至結束,記錄了約 82,000 條反事實續寫軌跡的任務得分增量(Δ)[1]。實驗將運行期糾偏拆為三個問題,揭示了顯著的機制錯位:
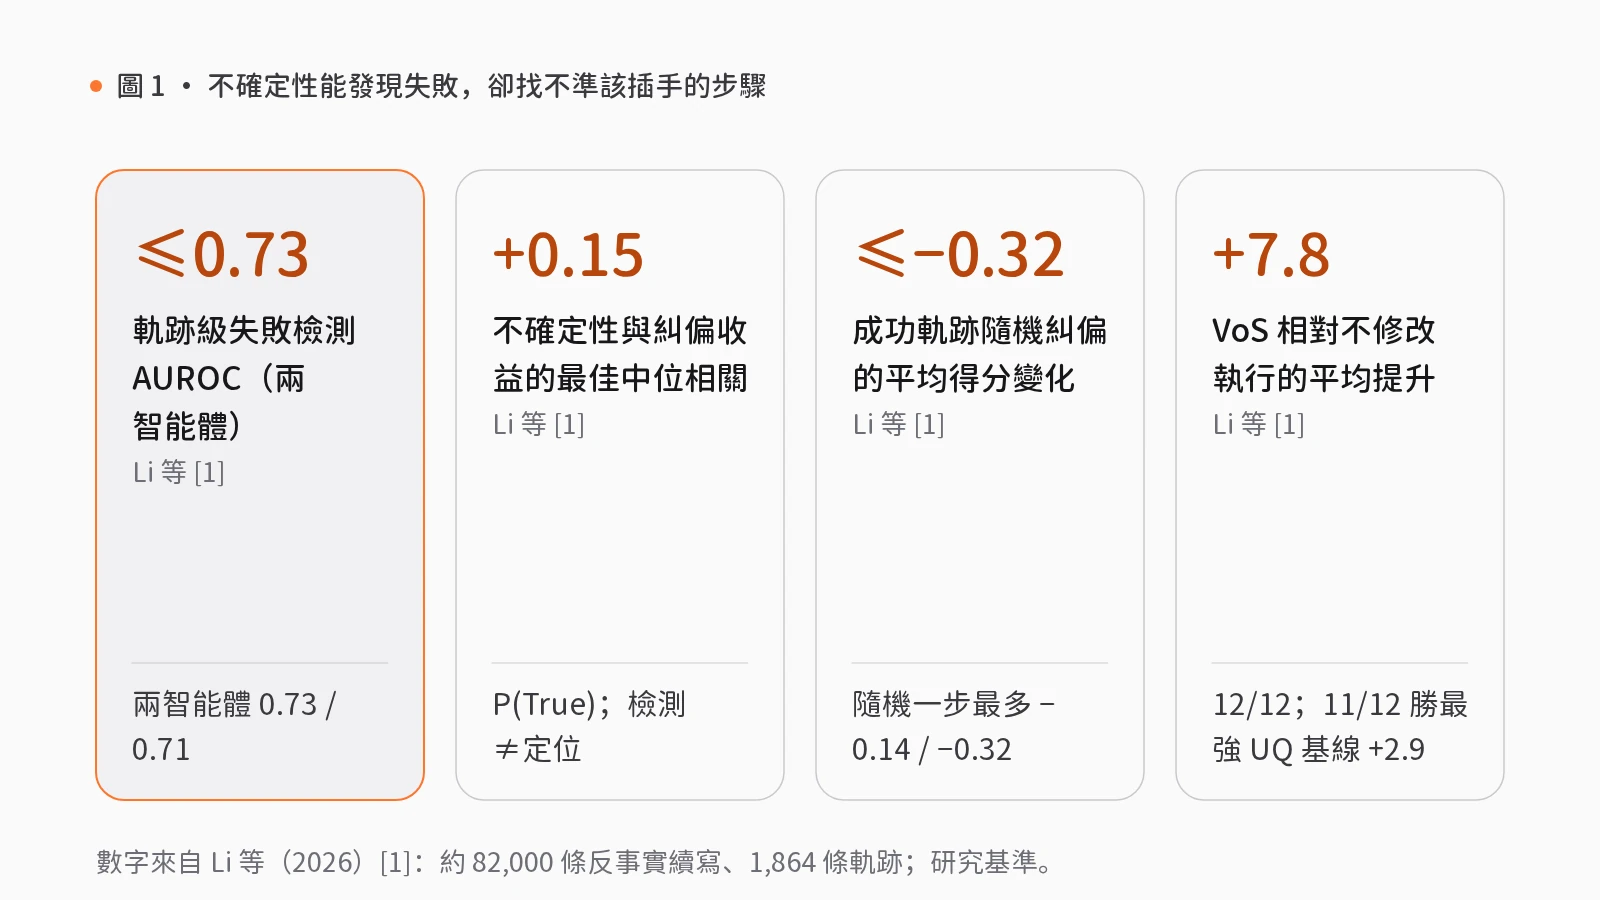
- 是否干預與誤干預傷害:在軌跡層面,不確定性能有效提示失敗,例如在應用接口基準上,兩個智能體的軌跡級失敗檢測 AUROC 最高達 0.73 與 0.71[1]。但干預並非無害:在原本能夠成功的軌跡上隨機挑一步糾偏,兩個智能體的平均任務得分反而分別下降最多 0.14 與 0.32[1]。若不加甄別地全程強行糾偏,甚至造成淨損失——其中一個智能體在應用接口基準上全程糾偏反而比原生執行倒扣 9.9 分[1]。
- 在哪一步干預的排序背離:最擅長檢測軌跡失敗的信號,並非最擅長定位最佳干預步驟的信號。各估計器在「失敗檢測」與「步驟定位」上的排名互不相關甚至相反,兩個智能體上的斯皮爾曼秩相關係數分別為 −0.12 與 −0.41[1]。在單條軌跡內部,不確定性與實測糾偏收益的相關性極弱:最佳中位數斯皮爾曼相關僅約 +0.15(來自 P(True) 自評——它在失敗檢測中屬較弱指標,卻與「哪一步干預真正有效」保持了最一致的對齊),且每種估計器在至少四分之一的軌跡上呈負相關[1, 2]。
- 何種機制的步間分歧:四種機制在「哪些軌跡可挽救」上中等一致(最佳結果相關係數 0.17–0.66),但在「同一軌跡內該在哪一步出手」上幾乎無共識(軌跡內步驟排序相關係數僅 0.02–0.19)[1]。
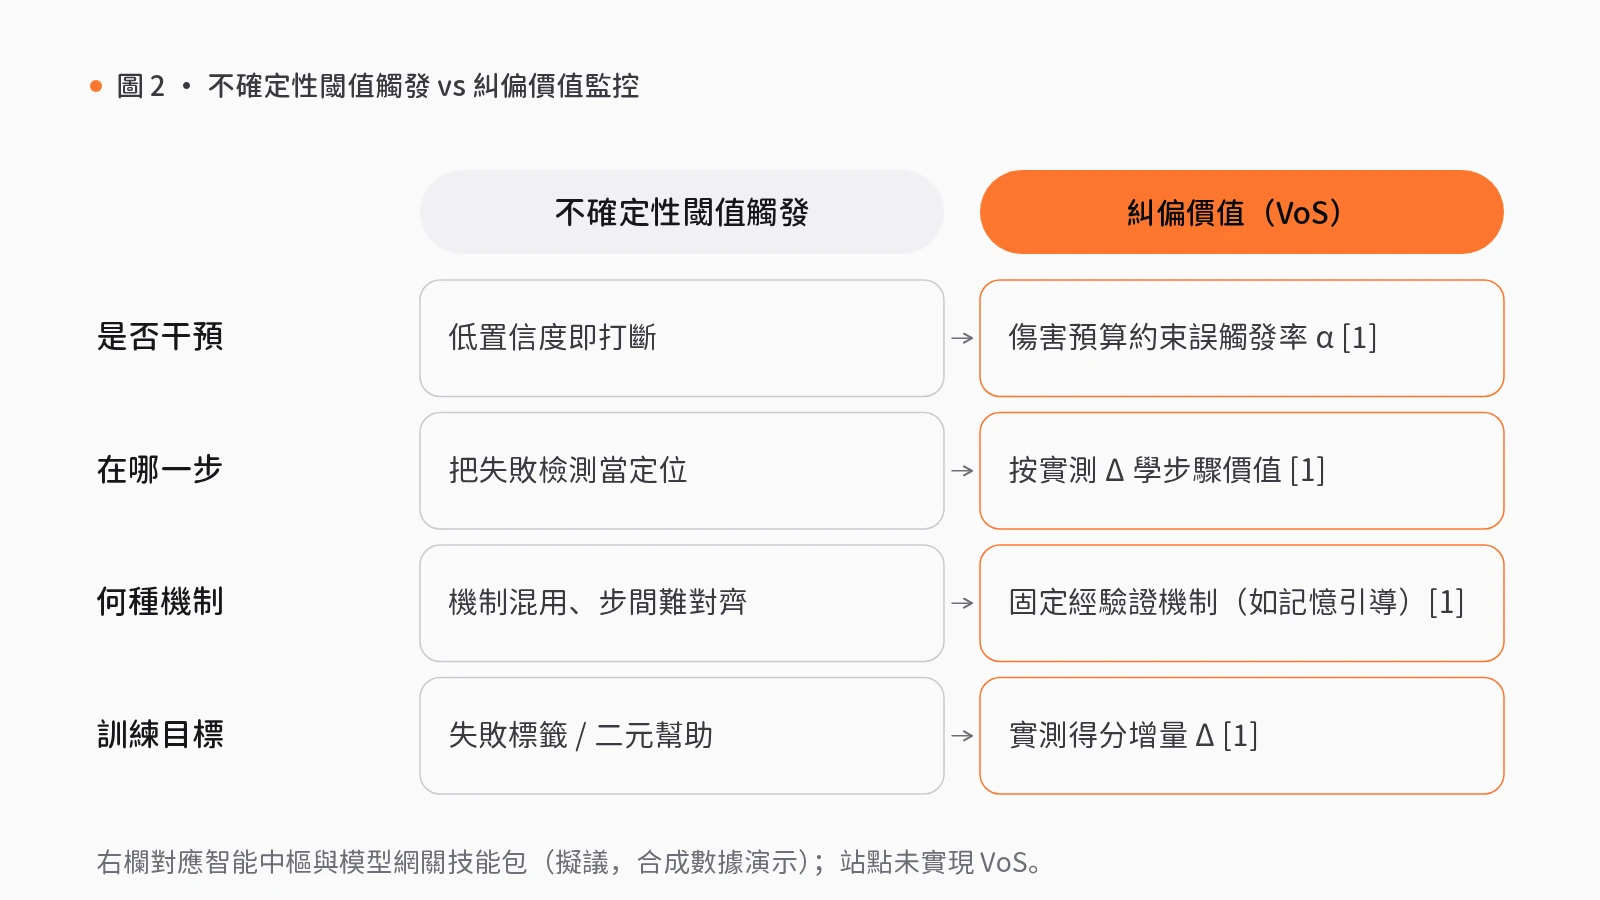
為此,Li 等人(2026)提出糾偏價值(VoS)框架:直接從實測得分增量(Δ)學習價值函數,配合受傷害預算約束的「是否干預」閾值——將成功軌跡上的誤觸發率 α 限制在訓練集選定的 5%–30% 區間內[1]。VoS 以基於記憶的引導作為固定機制(跨機制動態路由並未穩定跑贏該機制),在全部 12 個配置(3 基準 × 2 智能體 × 離線/在線)中均優於不修改執行,平均提升 7.8 分;並在 12 個配置中的 11 個上擊敗先前五種不確定性閾值觸發方法中最強的基線,平均高出 2.9 分[1]。消融證實:用實測增量訓練優於用失敗標籤、二元幫助標籤或過程獎勵目標;緊縮誤觸發預算優於幾乎每條軌跡都干預;且單一估計器家族無法通吃全部 12 個配置,融合全部信號更穩健[1]。作者也註明邊界:實驗依賴可獲取詞元級不確定性的開源權重智能體,構建 SOT 重放成本高昂,且評測環境為研究基準而非生產認證[1]。
工程落地與 rlab.works 能力映射:拆分三項決策、影子增量評測與人工關口
我們的工程判斷是,上述結論要求在生產架構中落實五項原則:將「是否干預、在哪一步干預、採用何種機制」拆成獨立決策;在信任任何不確定性閾值前先收集反事實或影子結果;用得分增量(Δ)而非單純的成敗標籤訓練監控器;為原本會成功的運行設定顯式誤觸發預算;當智能體、工具或評分定義變更時重新校準。
在 rlab.works 的智能中樞與模型網關模組中,可用三項組合技能包與三項組件對照這一設計,並劃定適配邊界:
- 動作執行前的介入裁決與步驟級確認:智能中樞的經審批的電腦操作(S03)按「準備帳戶與登入 → 審批操作清單(人工關口) → 執行並截圖 → 檢查改動(人工關口)」運行,對應「先決定是否及在何處介入、再產生外部動作」的邏輯。底層依託可審計工作流、人工確認與決策復盤(按步驟暫停等待人工決定並記錄複核結果)與持久化受控智能體執行(提供受控執行循環)。它在法律行業標為可遷移應用,要求逐項限制讀寫目錄並將對外提交排除在預設權限外,把高風險步驟固定為受控關口。
- 跨模型升級與離線影子評估:當糾偏涉及調用更強模型或對比干預策略時,模型網關的模型對比與切換(S12)按「檢查可選模型 → 樣例對比 → 審閲切換建議(人工關口) → 設定主備模型 → 切換後抽查(人工關口)」運行,並由模型對比與影子評估在不打擾線上主流程下完成候選策略的離線與影子比對。該包在企業服務中為可遷移應用,適合在切流前實測干預策略帶來的淨增量與誤傷率。
- 多步計劃中的階段複核關口:智能中樞的複雜任務拆解與執行(S01)按「拆解任務清單 → 確認執行範圍(人工關口) → 逐項執行 → 驗收交付(人工關口)」組織任務。在製造業中它屬可遷移應用,可將檢修目標拆為檢查、備料與複核步驟並留存交班證據,把干預收斂在預定義關口;軟件僅編排數字任務與記錄,物理維修仍由人員按作業許可執行。
必須誠實聲明站點能力邊界:三項技能包均為基於合成數據的「擬議未集成」方案,落地前須重做領域契約與權限接線;組件成熟度僅基於靜態源碼檢查,「可審計工作流、人工確認與決策復盤」為原型,其餘兩項雖標為可用,但站點技能包與組件均未實現 VoS 訓練管線,也不能自動消除錯誤干預的損耗。
上線智能體中途糾偏機制前的三項工程核查清單
架構與風控負責人在上線多步智能體糾偏回路前,可執行三項核查:
- 拆分「是否干預、在哪一步干預、用什麼機制」:不把單一不確定性閾值硬編碼為全局開關;將軌跡預警、步驟定位與機制選擇解耦,優先固定經驗證的單一引導機制(如記憶引導或既定關口)。
- 用影子或反事實增量(Δ)替代失敗標籤校準監控器:上線前通過離線重放或影子評估測量干預前後的真實得分差值,融合包括自評信號在內的多類特徵定位產生正增量的步驟。
- 為成功軌跡設定剛性誤觸發預算並隨變更重標定:統計對正常成功軌跡的打擾比例與得分損耗,將誤觸發率約束在明確預算內(如 5%–30%),並在模型、工具或評分口徑變化後立即重跑校準。
覺得有用?分享給需要的人。
參考文獻
- [1]
Li, H., Duan, J., Zhu, G., Lu, J., Shen, B., Yuan, C., & Xu, K. (2026). From uncertainty to action: Learning to steer LLM agents (arXiv:2610.09115). arxiv.org ↗
- [2]
Kadavath, S., et al. (2022). Language models (mostly) know what they know (arXiv:2207.05221). arxiv.org ↗
- [3]
Guo, C., Pleiss, G., Sun, Y., & Weinberger, K. Q. (2017). On calibration of modern neural networks. In *ICML 2017*. arxiv.org ↗
相關能力
技能包

S03 · 智能中樞
經審批的電腦操作
後台錄入、填表、修改文件等重複操作希望交由 AI 執行,又擔心誤操作。
AI 先列出操作位置與修改內容,經批准後執行;每一步均保留截圖與改動記錄。
- 準備帳戶與登入
- 審批操作清單人工複核
- 執行並截圖
- 檢查改動人工複核
4 步2 處人工複核8 個組件
S12 · 模型網關
模型對比與切換
新模型不斷推出,更換擔心效果下降,不換又擔心落後。
用同一批樣例對比新舊模型的質素、錯誤與費用差異,再確定主用與備用模型。
- 檢查可選模型
- 樣例對比
- 審閲切換建議人工複核
- 設定主備模型
- 切換後抽查人工複核
5 步2 處人工複核7 個組件

S01 · 智能中樞
複雜任務拆解與執行
交由 AI 處理的複雜任務常中途停止或偏離目標,進度也無從查看。
先將目標拆解為有序的任務清單,經人工確認範圍後執行,交付前再次驗收。
- 拆解任務清單
- 確認執行範圍人工複核
- 逐項執行
- 驗收交付人工複核
4 步2 處人工複核7 個組件