不确定性能发现失败,却找不到该插手的那一步
在多步智能体运行中,高不确定性虽能在轨迹层面提示失败风险,却难以定位真正值得干预的步骤;对原本能成功的轨迹随意纠偏反而会拉低任务得分。工程上需将“是否干预、在哪一步干预、采用何种机制”拆分为独立决策,用实测干预收益增量替代单纯的失败标签训练监控器,并为成功轨迹设定严格的误触发预算。

当不确定性触发器变成多步运行里的干扰源
部署多步工具调用智能体时,工程团队常依赖一条直觉设计运行期监控:实时追踪模型的不确定性或低置信度信号;一旦指标越过阈值,便立即触发自我反思、审查器反馈、调用更强模型或注入记忆等纠偏机制。
但在生产流程中,把不确定性阈值直接当成干预开关往往事与愿违。系统频繁打断智能体,不仅推高延迟与成本,还常改坏原本能走通的路径;而在真正需要干预的关键分叉步上,不确定性却未必最高。这一悖论源于混淆了两个问题:不确定性信号可以提示哪条轨迹正在走向失败,却无法可靠定位在哪一步插手才能带来正收益。工程上须将“是否干预、在哪一步干预、采用何种机制”拆开,基于实测干预收益增量训练监控器,并为成功轨迹设定严格的误触发预算。
从不确定性到行动:步骤级反事实收益表与纠偏价值学习
从置信度校准与自评文献看,识别错误与定位干预价值之间本就存在断层。Guo 等人(2017)指出,现代神经网络的置信度常相对于真实准确率存在校准偏差;即便完成校准,对正确率的静态概率刻画也不等于序列决策中“此刻介入能否改善结果”的指南[3]。Kadavath 等人(2022)研究了语言模型评估自身答案正确性的概率信号(P(True) 自评)[2]。当这类信号进入多步智能体闭环时,能否指导中途纠偏?
Li 等人(2026)通过构建步骤级结果表(SOT)展开了反事实测量[1]。作者在三个基准(应用接口、家庭文本与购物模拟)上,针对两个开源权重智能体与四种纠偏机制——自我反思、审查器反馈、更强模型协助及基于记忆的引导——收集了 1,864 条基础轨迹,在每个非终止步骤发起反事实纠偏并运行至结束,记录了约 82,000 条反事实续写轨迹的任务得分增量(Δ)[1]。实验将运行期纠偏拆为三个问题,揭示了显著的机制错位:
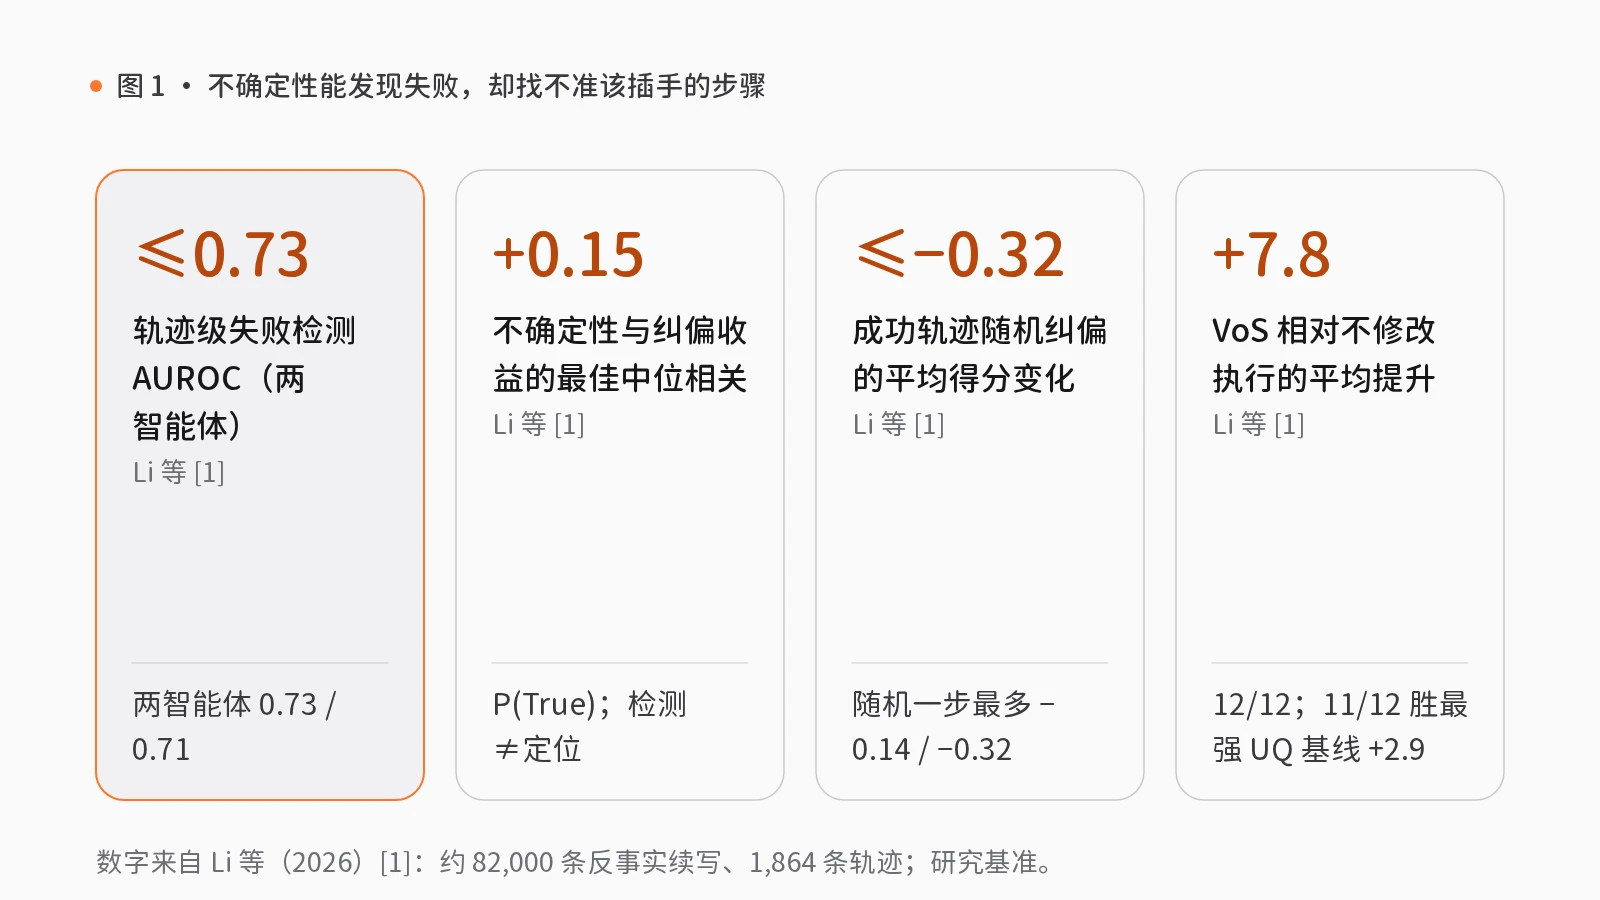
- 是否干预与误干预伤害:在轨迹层面,不确定性能有效提示失败,例如在应用接口基准上,两个智能体的轨迹级失败检测 AUROC 最高达 0.73 与 0.71[1]。但干预并非无害:在原本能够成功的轨迹上随机挑一步纠偏,两个智能体的平均任务得分反而分别下降最多 0.14 与 0.32[1]。若不加甄别地全程强行纠偏,甚至造成净损失——其中一个智能体在应用接口基准上全程纠偏反而比原生执行倒扣 9.9 分[1]。
- 在哪一步干预的排序背离:最擅长检测轨迹失败的信号,并非最擅长定位最佳干预步骤的信号。各估计器在“失败检测”与“步骤定位”上的排名互不相关甚至相反,两个智能体上的斯皮尔曼秩相关系数分别为 −0.12 与 −0.41[1]。在单条轨迹内部,不确定性与实测纠偏收益的相关性极弱:最佳中位数斯皮尔曼相关仅约 +0.15(来自 P(True) 自评——它在失败检测中属较弱指标,却与“哪一步干预真正有效”保持了最一致的对齐),且每种估计器在至少四分之一的轨迹上呈负相关[1, 2]。
- 何种机制的步间分歧:四种机制在“哪些轨迹可挽救”上中等一致(最佳结果相关系数 0.17–0.66),但在“同一轨迹内该在哪一步出手”上几乎无共识(轨迹内步骤排序相关系数仅 0.02–0.19)[1]。
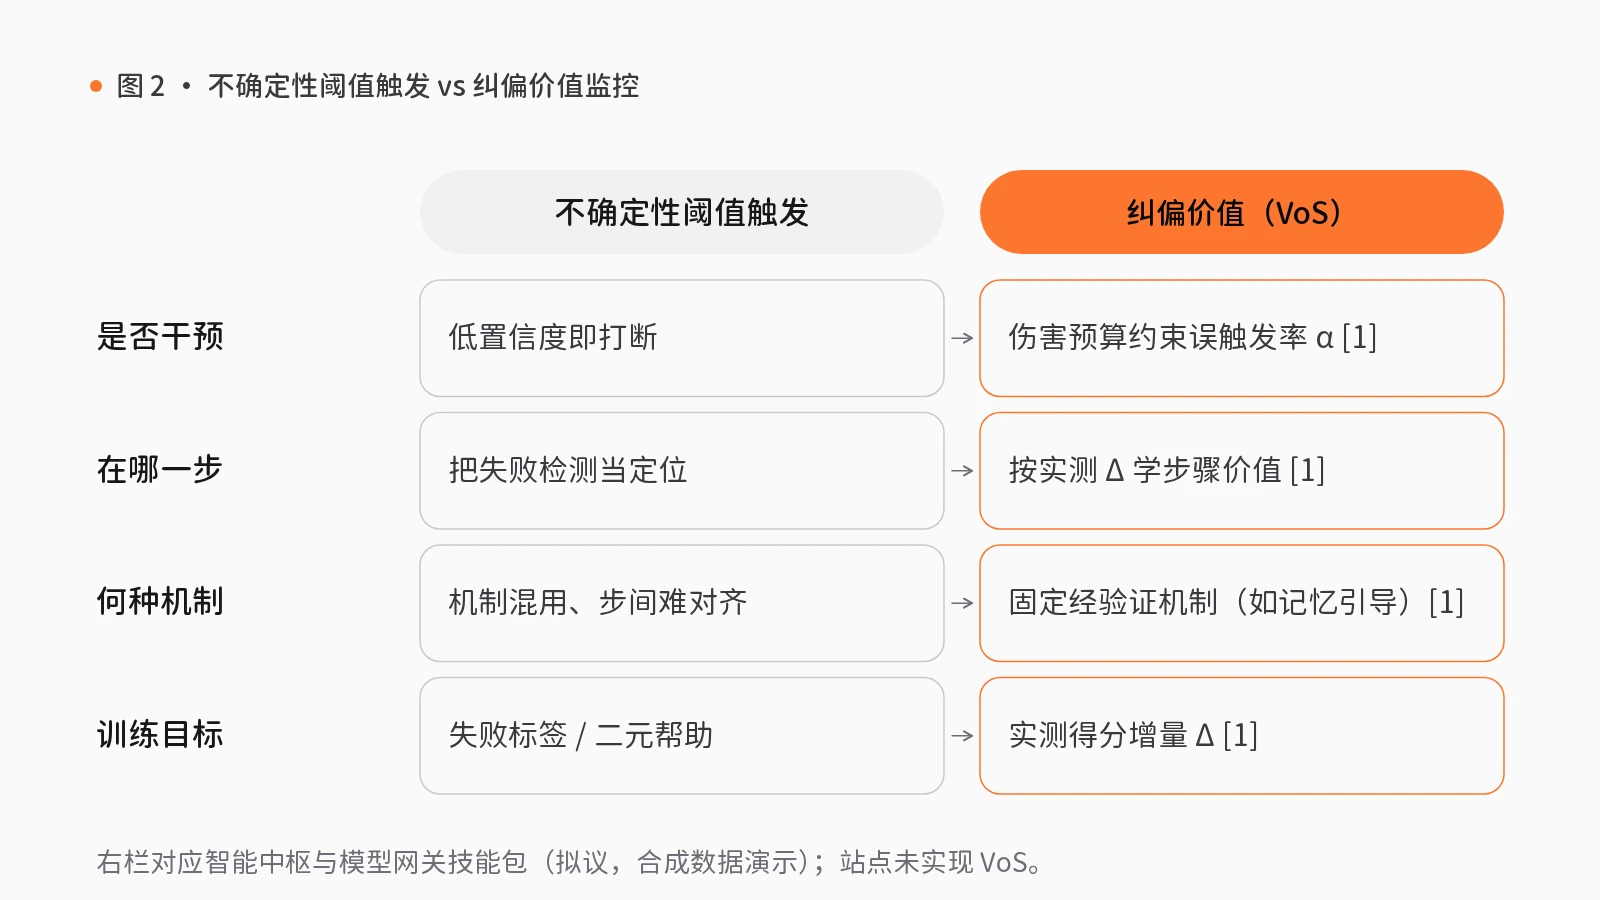
为此,Li 等人(2026)提出纠偏价值(VoS)框架:直接从实测得分增量(Δ)学习价值函数,配合受伤害预算约束的“是否干预”阈值——将成功轨迹上的误触发率 α 限制在训练集选定的 5%–30% 区间内[1]。VoS 以基于记忆的引导作为固定机制(跨机制动态路由并未稳定跑赢该机制),在全部 12 个配置(3 基准 × 2 智能体 × 离线/在线)中均优于不修改执行,平均提升 7.8 分;并在 12 个配置中的 11 个上击败先前五种不确定性阈值触发方法中最强的基线,平均高出 2.9 分[1]。消融证实:用实测增量训练优于用失败标签、二元帮助标签或过程奖励目标;紧缩误触发预算优于几乎每条轨迹都干预;且单一估计器家族无法通吃全部 12 个配置,融合全部信号更稳健[1]。作者也注明边界:实验依赖可获取词元级不确定性的开源权重智能体,构建 SOT 重放成本高昂,且评测环境为研究基准而非生产认证[1]。
工程落地与 rlab.works 能力映射:拆分三项决策、影子增量评测与人工关口
我们的工程判断是,上述结论要求在生产架构中落实五项原则:将“是否干预、在哪一步干预、采用何种机制”拆成独立决策;在信任任何不确定性阈值前先收集反事实或影子结果;用得分增量(Δ)而非单纯的成败标签训练监控器;为原本会成功的运行设定显式误触发预算;当智能体、工具或评分定义变更时重新校准。
在 rlab.works 的智能中枢与模型网关模块中,可用三项组合技能包与三项组件对照这一设计,并划定适配边界:
- 动作执行前的介入裁决与步骤级确认:智能中枢的经审批的电脑操作(S03)按“准备账号与登录 → 审批操作清单(人工关口) → 执行并截图 → 检查改动(人工关口)”运行,对应“先决定是否及在何处介入、再产生外部动作”的逻辑。底层依托可审计工作流、人工确认与决策复盘(按步骤暂停等待人工决定并记录复核结果)与持久化受控智能体执行(提供受控执行循环)。它在法律行业标为可迁移应用,要求逐项限制读写目录并将对外提交排除在默认权限外,把高风险步骤固定为受控关口。
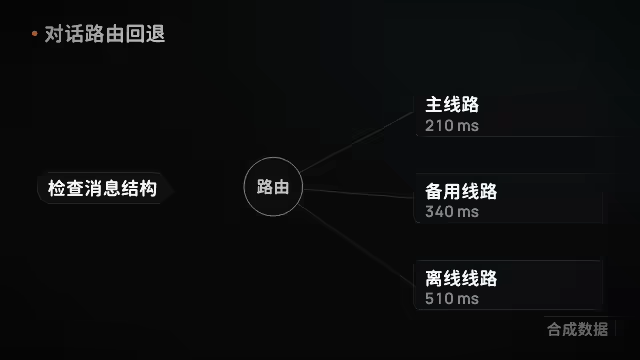
- 跨模型升级与离线影子评估:当纠偏涉及调用更强模型或对比干预策略时,模型网关的模型对比与切换(S12)按“检查可选模型 → 样例对比 → 审阅切换建议(人工关口) → 设定主备模型 → 切换后抽查(人工关口)”运行,并由模型对比与影子评估在不打扰线上主流程下完成候选策略的离线与影子比对。该包在企业服务中为可迁移应用,适合在切流前实测干预策略带来的净增量与误伤率。
- 多步计划中的阶段复核关口:智能中枢的复杂任务拆解与执行(S01)按“拆解任务清单 → 确认执行范围(人工关口) → 逐项执行 → 验收交付(人工关口)”组织任务。在制造业中它属可迁移应用,可将检修目标拆为检查、备料与复核步骤并留存交班证据,把干预收敛在预定义关口;软件仅编排数字任务与记录,物理维修仍由人员按作业许可执行。
必须诚实声明站点能力边界:三项技能包均为基于合成数据的“拟议未集成”方案,落地前须重做领域契约与权限接线;组件成熟度仅基于静态源码检查,「可审计工作流、人工确认与决策复盘」为原型,其余两项虽标为可用,但站点技能包与组件均未实现 VoS 训练管线,也不能自动消除错误干预的损耗。
上线智能体中途纠偏机制前的三项工程核查清单
架构与风控负责人在上线多步智能体纠偏回路前,可执行三项核查:
- 拆分「是否干预、在哪一步干预、用什么机制」:不把单一不确定性阈值硬编码为全局开关;将轨迹预警、步骤定位与机制选择解耦,优先固定经验证的单一引导机制(如记忆引导或既定关口)。
- 用影子或反事实增量(Δ)替代失败标签校准监控器:上线前通过离线重放或影子评估测量干预前后的真实得分差值,融合包括自评信号在内的多类特征定位产生正增量的步骤。
- 为成功轨迹设定刚性误触发预算并随变更重标定:统计对正常成功轨迹的打扰比例与得分损耗,将误触发率约束在明确预算内(如 5%–30%),并在模型、工具或评分口径变化后立即重跑校准。
觉得有用?分享给需要的人。
参考文献
- [1]
Li, H., Duan, J., Zhu, G., Lu, J., Shen, B., Yuan, C., & Xu, K. (2026). From uncertainty to action: Learning to steer LLM agents (arXiv:2610.09115). arxiv.org ↗
- [2]
Kadavath, S., et al. (2022). Language models (mostly) know what they know (arXiv:2207.05221). arxiv.org ↗
- [3]
Guo, C., Pleiss, G., Sun, Y., & Weinberger, K. Q. (2017). On calibration of modern neural networks. In *ICML 2017*. arxiv.org ↗
相关能力
技能包

S03 · 智能中枢
经审批的电脑操作
后台录入、填表、修改文件等重复操作希望交由 AI 执行,又担心误操作。
AI 先列出操作位置与修改内容,经批准后执行;每一步均保留截图与改动记录。
- 准备账号与登录
- 审批操作清单人工复核
- 执行并截图
- 检查改动人工复核
4 步2 处人工复核8 个组件
S12 · 模型网关
模型对比与切换
新模型不断推出,更换担心效果下降,不换又担心落后。
用同一批样例对比新旧模型的质量、错误与费用差异,再确定主用与备用模型。
- 检查可选模型
- 样例对比
- 审阅切换建议人工复核
- 设定主备模型
- 切换后抽查人工复核
5 步2 处人工复核7 个组件

S01 · 智能中枢
复杂任务拆解与执行
交由 AI 处理的复杂任务常中途停止或偏离目标,进度也无从查看。
先将目标拆解为有序的任务清单,经人工确认范围后执行,交付前再次验收。
- 拆解任务清单
- 确认执行范围人工复核
- 逐项执行
- 验收交付人工复核
4 步2 处人工复核7 个组件