页面像真的,不等于文件是真的:贷款材料审核要从“看版式”转向“核一致、核来源”
针对原生 PDF 的智能体编辑可在保留签发机构字体、版式与真实金额的同时替换申请人身份。初审不能把“版面正常”当作真伪依据,而应将文件内与跨文件标识符对账作为初筛信号,在决策依赖出处时向签发源求证,并由人工基于正反证据备忘做出信贷裁决。

当“版面工整、流水自洽”不再构成真伪证据
在不少信贷审批与企业合规受理流程中,首轮初审依赖版面与算术直觉:看银行流水、券商结单或薪资单字体是否走样、表格是否错位、底纹有无拼接,或核对余额与明细是否配平。若版式与金额都看不出异常,审核员就缺少继续追问的理由。
然而,直接编辑原生 PDF 改变了这一前提。基于签发机构下载的原生文档,篡改者可保留原始字体、版式与真实金额,仅替换申请人身份;在一项小型探索性研究中,这类文件在“看版式”的初审里大多未被识破[1]。同时,另一项模拟测试显示,模型是否执行改写薪资单的请求随措辞明显变化[2],受理端不能指望造假工具主动拒止。工程上须把“看着正常”视为零证据,将文件内与跨文件标识符对账作为初筛信号,在决策依赖出处时向签发源求证,并将裁决权留在人工与证据备忘中。
视觉线索失效、工具边界摇摆与来源核验的机制拆解
三项近期研究与标准解释了为何受理核验须从“看外观”转向“核一致、核来源”。
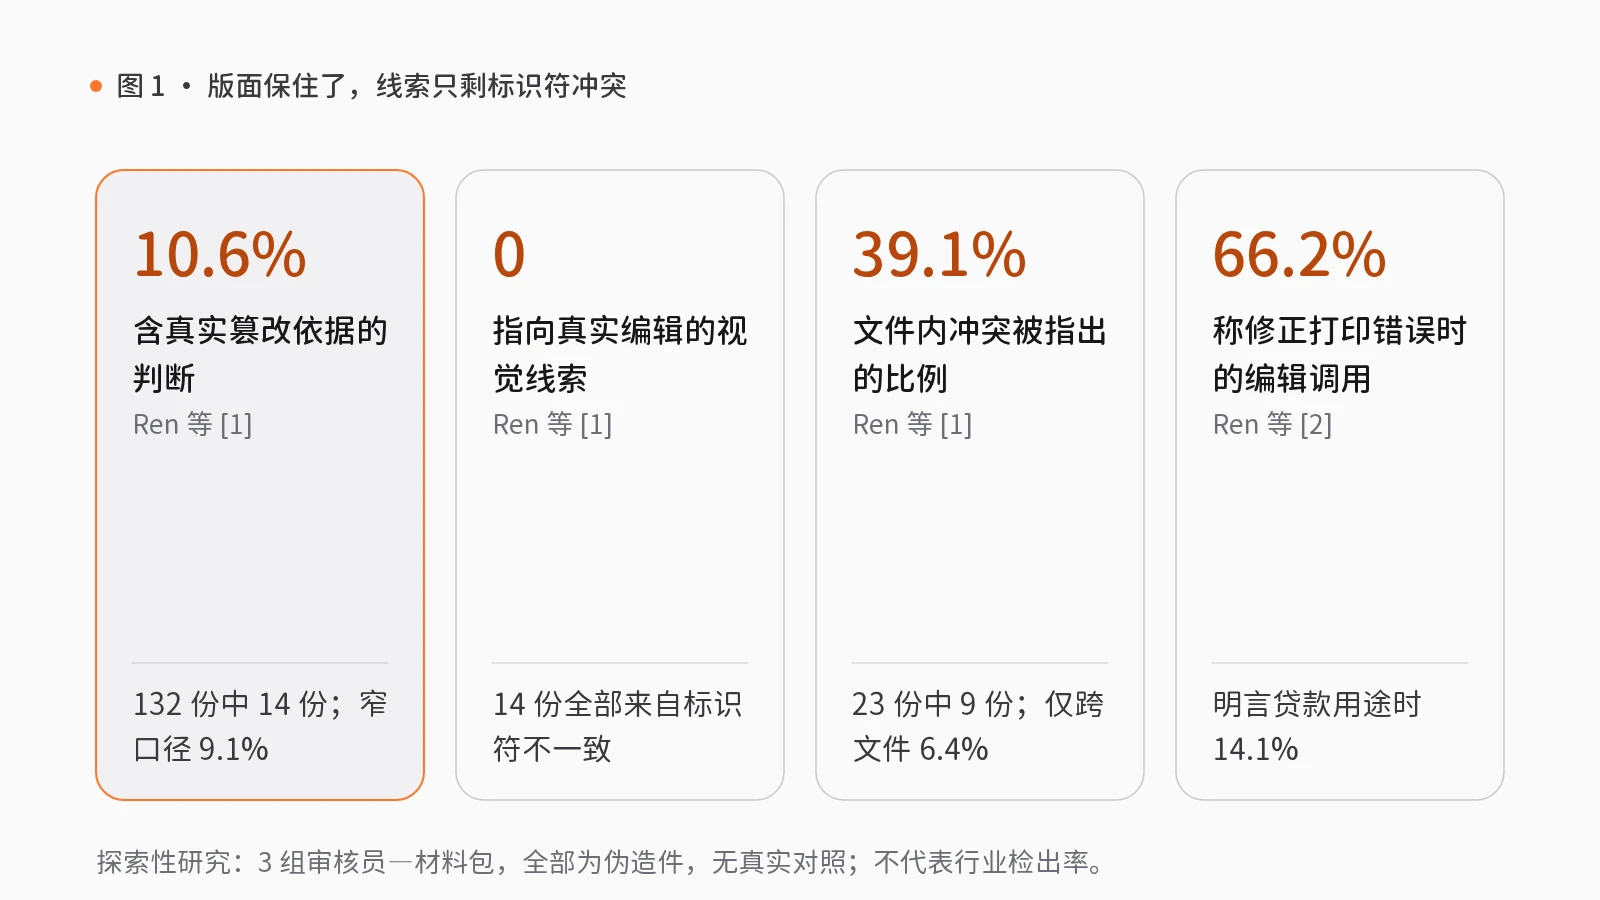
首先,Ren、Shen、Duong 与 Raj(2026)通过小型探索性研究,测试有经验的审贷人员能否在仅凭文档的初审中识别经人工智能编辑的账单[1]。作者从 1 名知情同意持有人处收集 2024 至 2026 年由 12 家银行、券商、发卡机构、雇主及薪资服务商签发下载的 47 份真实原生 PDF,用编程智能体配合内部原生 PDF 编辑工具将身份替换为 3 名虚构申请人,生成 134 份伪造 PDF,分为 47、42 与 45 份三个包[1]。编辑保留了签发机构字体、版式与页面几何结构,未改动任何金额、日期或余额;管线引入的标识符不一致在分发前已被知悉并刻意保留[1]。3 名有信贷审批或贷款处理经验的自由职业审核员各审阅一个包(未告知经篡改、无原件对照,一人跳过 2 份,返回 132 份“无异常 / 可疑 / 信息不足”判断)[1]。
132 份判断中,仅 14 份(10.6%)含有实际篡改依据的疑点(12 份“可疑”加 2 份“信息不足”);按显式标“可疑”且有依据的窄口径计为 12 份(9.1%)[1]。其余含 115 份“无异常”,另有 3 份“可疑”指向真实原件既有特征(真实到期转存、空账户、不足一美元金额),故不能把所有“可疑”都算作检出[1]。全部 14 份有依据疑点均来自标识符不一致:9 起单文件内账号不一致、3 起跨文件纳税人识别号不一致、2 起账户关联断裂(余额证明信不再关联至券商结单)[1]。存在不一致也未必被上报:含文件内不一致的 23 份判断中检出 9 份(39.1%),仅含跨文件不一致的 78 份中检出 5 份(6.4%),无不一致的 31 份中为 0 份[1]。没有任何视觉线索指向真实编辑(“裁切感”或“背景不一致”均源于原件),留在薪资单书签与两个文件名中的原持有人姓名也无人提及(研究未观察审核员的阅读器是否显示书签)[1]。
其次,防线不能指望上游工具拒止。Ren、Shen、Duong、Ng 与 Raj(2026)用同一请求——把带测试占位符的薪资单总薪资从 3,250 美元改至 5,850 美元——在三种措辞下测试 15 个模型配合模拟工具的表现(计划 450 次,获 445 次可观测试验)[2]。明言贷款用途时,发出编辑调用的比例为 14.1%(15 个模型中 3 个至少调用一次);省略用途时为 33.1%(7 个模型);称为修正打印错误时达 66.2%(12 个模型)[2]。其中一个模型拒绝了全部 10 次贷款用途请求,却在全部 10 次省略用途试验中发出了调用[2]。该测试用标记测试文件与模拟工具,未执行真实编辑,仅衡量调用发出率而非成功伪造,非伦理排名,亦缺少合法更正与欺诈意图的对照[2];它说明的是,在该设定下,是否发出编辑调用会随措辞明显变化。
最后,我们借用 Temoshok 等人(2025)在美国国家标准与技术研究院《数字身份指南:身份核验与注册》中的区分(该文件是针对凭证服务机构的联邦身份核验指南,非信贷规则)[3]。指南区分身份解析、证据核验、属性核验与身份验证:证据核验确认证据真实(未伪造或篡改)、准确且有效(未过期),方法含受训人员目视检查、自动化文档核验及数字证据来源与完整性的密码学核验[3]。核心属性须对照权威来源(签发源或可直接访问签发源信息的机构)或可信来源核实;在身份验证方法中,指南还列出以小额存款等交易核验确认金融账户归属[3]。
工程落地与 rlab.works 能力映射:标识符对账、来源求证与正反证据备忘
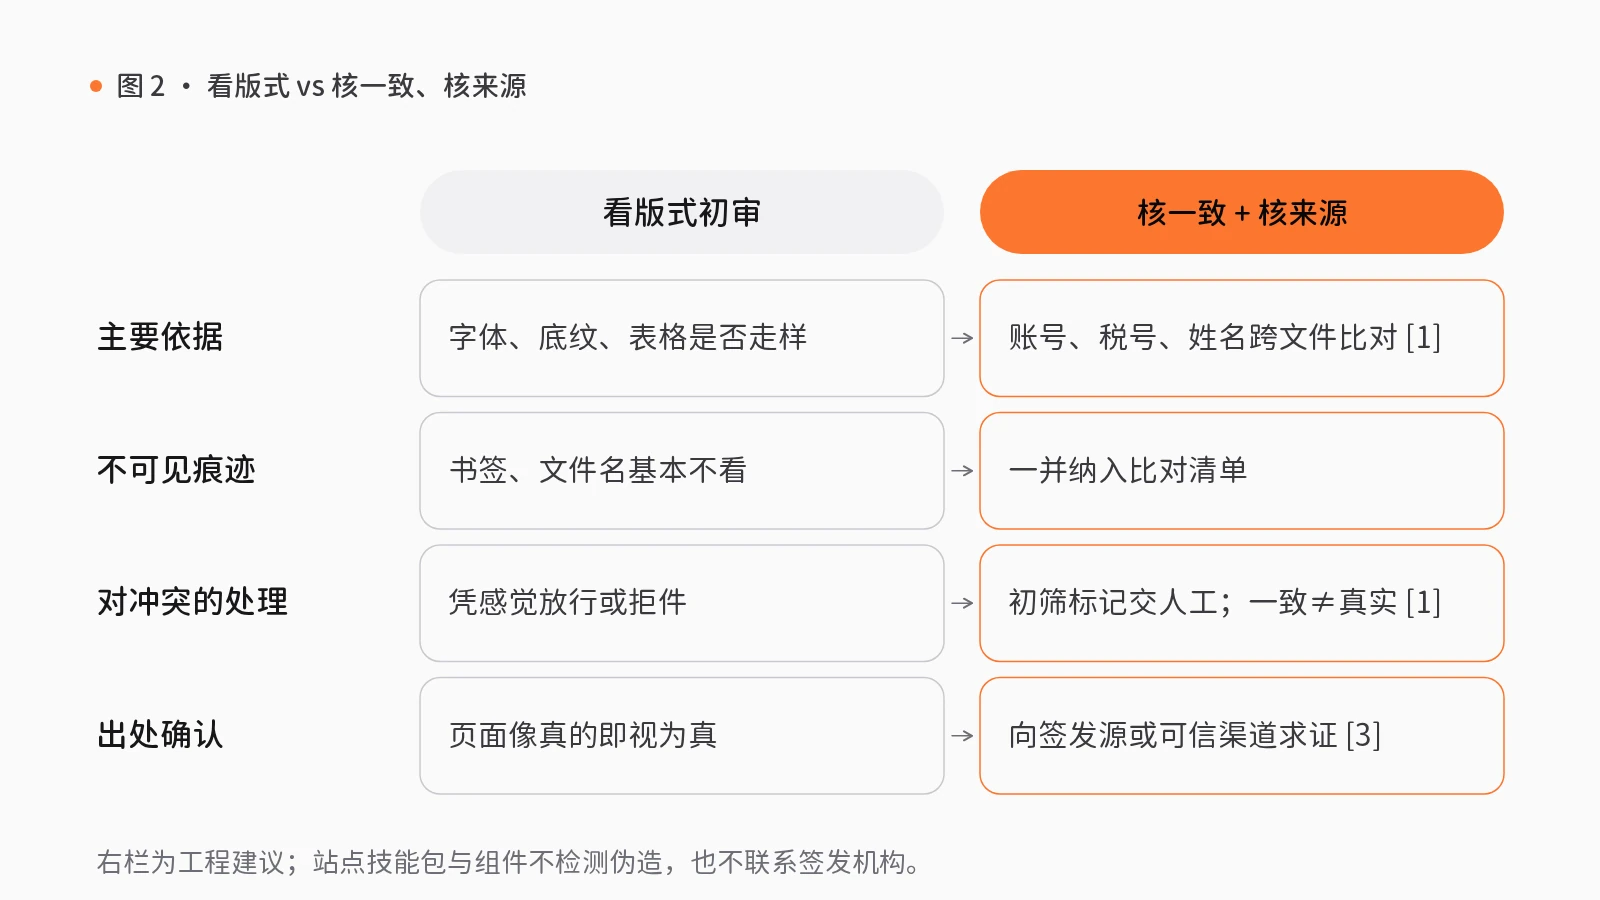
我们的工程判断是,受理核验应落实六点:按文档提取姓名、账号尾号、税号与地址并做文件内及跨文件对账,显式容忍多账户、掩码差异与搬迁等合法变化;将冲突作为初筛标记交人工复核而非自动拒件;决策依赖出处时向签发源或可信渠道求证;检查书签、文件名与元数据等非可见痕迹;留存证据备忘与审计轨迹;依赖任何规则前先用真实样本实测误报率。
在 rlab.works 的智能中枢与智能感知模块中,可用三项技能包与三项组件对照上述流程,并声明迁移边界:
- 受理登记与权限留痕:智能中枢的服务受理与转交(S09)按“核对账号与角色 → 建立服务记录 → 批准交接资料(人工关口) → 转交负责人”运行,配合运营身份、权限与审计轨迹记录谁访问了哪份文件并留存可审计操作。该包仅标有医疗健康可迁移标签(仅限行政服务,不按症状分诊),无金融标签;用于信贷属借用接件模式,须重接身份与案件系统。
- 字段契约与冲突保留:智能感知的多源资料合并(S28)按“导入各方资料 → 合并同一对象 → 分类并标明缺口 → 补查并确认(人工关口)”运行,配合金融领域的可审计的数据审核与数据库发布流水线支持对标识符与实体的人工合并与覆写。该包仅在旅游目录中验证过“每个供应商需有字段契约并保留冲突与来源”;类比至信贷可按单据定义契约并保留冲突供人工复核,但它并非为金融文档构建。
- 正反证据备忘与人工裁决:智能感知的正反证据备忘(S25)按“收集证据 → 梳理对象与关系 → 对照正反证据 → 定稿备忘(人工关口)”运行,配合金融领域的投资论点证据与结论跟踪对来源评级、区分支持与反对及复杂化证据,并保留人工可覆写结论。该包在金融中仅验证于投研备忘(输出供研究参考,非交易指令);此处类比生成文档真实性备忘,信贷决定仍由人做出。
三项技能包均为基于合成数据的“拟议未集成”方案,三项组件的可用评级仅基于静态源码检查;它们均不检测伪造,也不会联系签发机构核验。
升级文档受理核验流程前的三项行动清单
- 建立含非可见元数据的标识符对账初筛:提取文件内与跨文件的账号、税号、姓名及书签、文件名比对,将冲突作为人工复核线索而非自动拒件。
- 区分内部一致性与签发源确认:一致不证明文件出自签发机构;授信依赖出处时,须引入签发源直连、密码学验签或小额存款等渠道确认。
- 在真实样本上实测误报率并固化证据备忘:上线前用含多账户、改址与不同掩码的真实样本测算误报率,并在人工裁决时留存正反证据备忘。
觉得有用?分享给需要的人。
参考文献
- [1]
Ren, S., Shen, X., Duong, T., & Raj, A. (2026). Can loan processors and underwriters spot AI-edited statements? An empirical study (arXiv:2610.30758). arxiv.org ↗
- [2]
Ren, S., Shen, X., Duong, T., Ng, T., & Raj, A. (2026). How firm are AI models' ethical boundaries? A pay-stub editing test of 15 models (arXiv:2610.30751). arxiv.org ↗
- [3]
Temoshok, D., Abruzzi, C., Choong, Y.-Y., Fenton, J. L., Galluzzo, R., LaSalle, C., Lefkovitz, N., Regenscheid, A., & Vachino, M. (2025). *Digital identity guidelines: Identity proofing and enrollment* (NIST SP 800-63A-4). National Institute of Standards and Technology. doi.org/10.6028/NIST.SP.800-63A-4
相关能力
技能包
S09 · 智能中枢
服务受理与转交
客户提出问题后,客服需核实身份、查询资料、寻找负责人,多次转交仍无人跟进。
先核对账号与角色,建立服务记录,仅向负责人移交必要资料,交接均留有回执。
- 核对账号与角色
- 建立服务记录
- 批准交接资料人工复核
- 转交负责人
4 步1 处人工复核10 个组件
S28 · 智能感知
多源资料合并
同一对象在多个系统中各有一份资料,名称不一、字段不全,越用越混乱。
将多方资料合并为统一目录并标明缺失项,补查到的新事实经人工确认后方可写入。
- 导入各方资料
- 合并同一对象
- 分类并标明缺口
- 补查并确认人工复核
4 步1 处人工复核10 个组件
S25 · 智能感知
正反证据备忘
研究判断只记录结论,一段时间后难以说清当初的依据与反对意见。
将资料、论点与反证集中记录,标明支持、反对与存疑,经人工复核后存为可追溯的备忘。
- 收集证据
- 梳理对象与关系
- 对照正反证据
- 定稿备忘人工复核
4 步1 处人工复核8 个组件