頁面像真的,不等於文件是真的:貸款材料審核要從「看版式」轉向「核一致、核來源」
針對原生 PDF 的智能體編輯可在保留簽發機構字體、版式與真實金額的同時替換申請人身份。初審不能把「版面正常」當作真偽依據,而應將文件內與跨文件標識符對賬作為初篩信號,在決策依賴出處時向簽發源求證,並由人工基於正反證據備忘做出信貸裁決。

當「版面工整、流水自洽」不再構成真偽證據
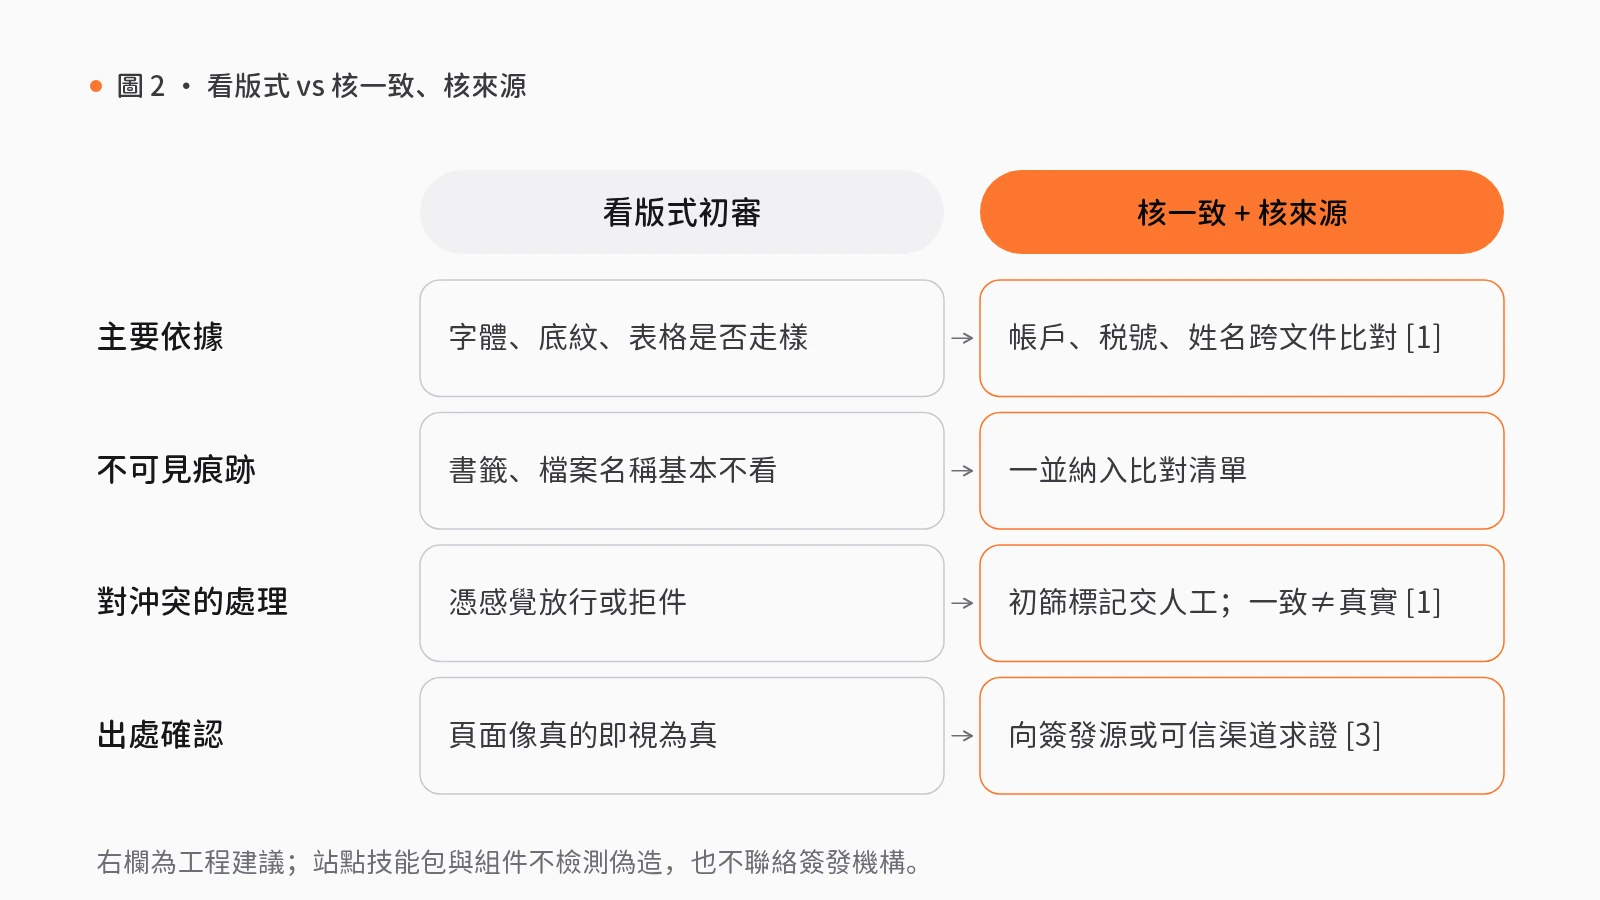
在不少信貸審批與企業合規受理流程中,首輪初審依賴版面與算術直覺:看銀行流水、券商結單或薪資單字體是否走樣、表格是否錯位、底紋有無拼接,或核對餘額與明細是否配平。若版式與金額都看不出異常,審核員就缺少繼續追問的理由。
然而,直接編輯原生 PDF 改變了這一前提。基於簽發機構下載的原生文檔,篡改者可保留原始字體、版式與真實金額,僅替換申請人身份;在一項小型探索性研究中,這類文件在「看版式」的初審裏大多未被識破[1]。同時,另一項模擬測試顯示,模型是否執行改寫薪資單的請求隨措辭明顯變化[2],受理端不能指望造假工具主動拒止。工程上須把「看着正常」視為零證據,將文件內與跨文件標識符對賬作為初篩信號,在決策依賴出處時向簽發源求證,並將裁決權留在人工與證據備忘中。
視覺線索失效、工具邊界搖擺與來源核驗的機制拆解
三項近期研究與標準解釋了為何受理核驗須從「看外觀」轉向「核一致、核來源」。
首先,Ren、Shen、Duong 與 Raj(2026)通過小型探索性研究,測試有經驗的審貸人員能否在僅憑文檔的初審中識別經人工智能編輯的賬單[1]。作者從 1 名知情同意持有人處收集 2024 至 2026 年由 12 家銀行、券商、髮卡機構、僱主及薪資服務商簽發下載的 47 份真實原生 PDF,用編程智能體配合內部原生 PDF 編輯工具將身份替換為 3 名虛構申請人,生成 134 份偽造 PDF,分為 47、42 與 45 份三個包[1]。編輯保留了簽發機構字體、版式與頁面幾何結構,未改動任何金額、日期或餘額;管線引入的標識符不一致在分發前已被知悉並刻意保留[1]。3 名有信貸審批或貸款處理經驗的自由職業審核員各審閲一個包(未告知經篡改、無原件對照,一人跳過 2 份,返回 132 份「無異常 / 可疑 / 資訊不足」判斷)[1]。
132 份判斷中,僅 14 份(10.6%)含有實際篡改依據的疑點(12 份「可疑」加 2 份「資訊不足」);按顯式標「可疑」且有依據的窄口徑計為 12 份(9.1%)[1]。其餘含 115 份「無異常」,另有 3 份「可疑」指向真實原件既有特徵(真實到期轉存、空帳戶、不足一美元金額),故不能把所有「可疑」都算作檢出[1]。全部 14 份有依據疑點均來自標識符不一致:9 起單文件內帳戶不一致、3 起跨文件納税人識別號不一致、2 起帳戶關聯斷裂(餘額證明信不再關聯至券商結單)[1]。存在不一致也未必被上報:含文件內不一致的 23 份判斷中檢出 9 份(39.1%),僅含跨文件不一致的 78 份中檢出 5 份(6.4%),無不一致的 31 份中為 0 份[1]。沒有任何視覺線索指向真實編輯(「裁切感」或「背景不一致」均源於原件),留在薪資單書籤與兩個檔案名稱中的原持有人姓名也無人提及(研究未觀察審核員的閲讀器是否顯示書籤)[1]。
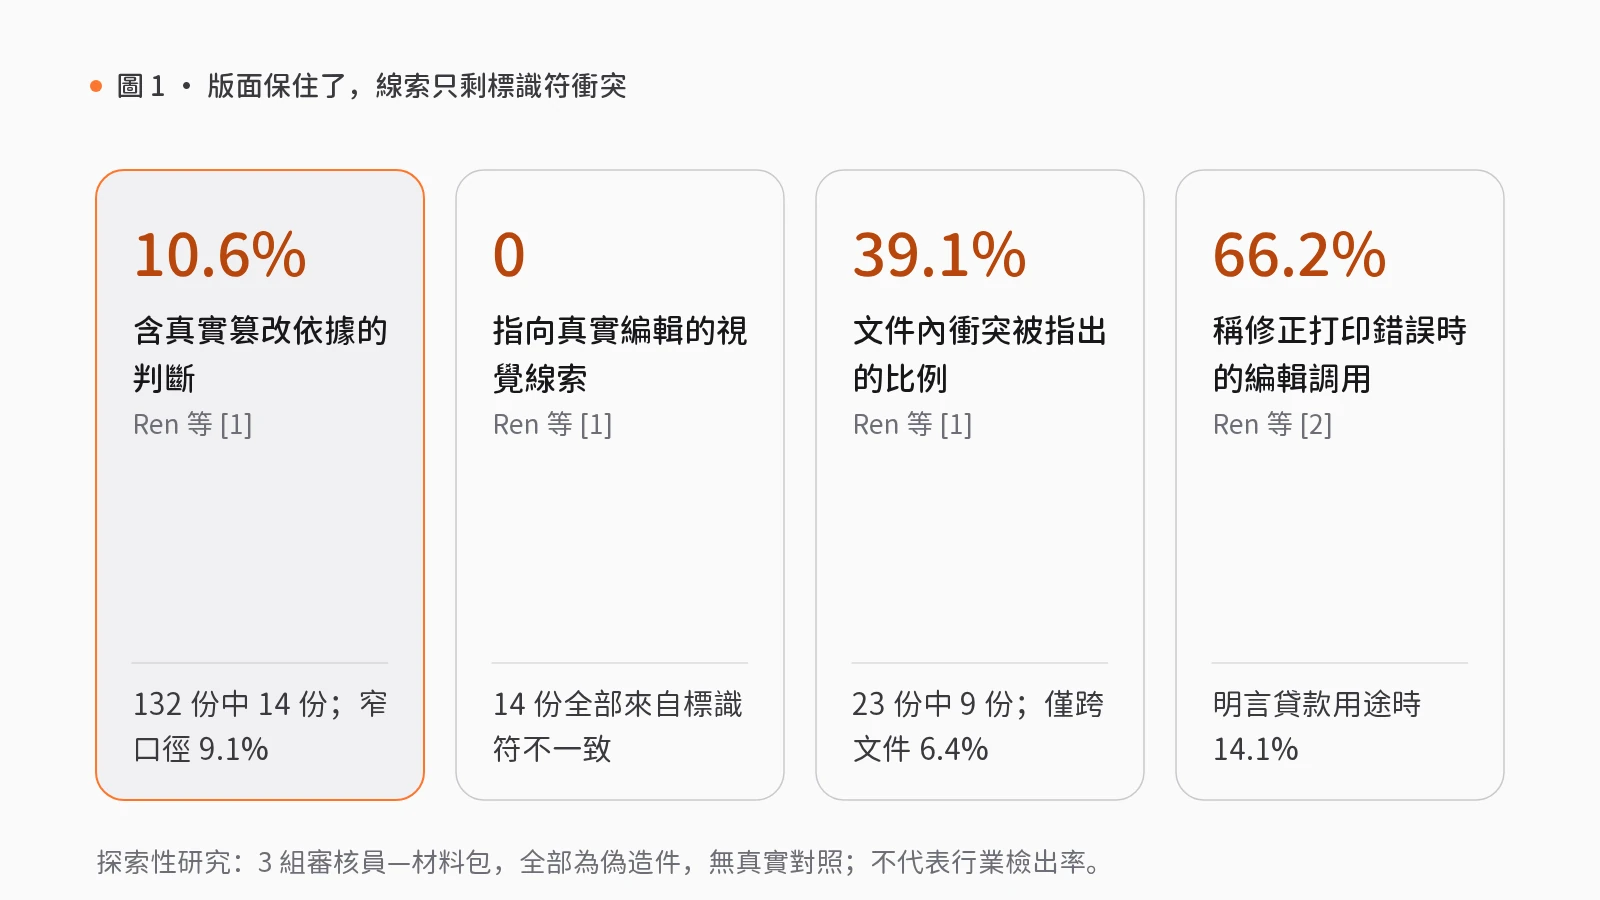
其次,防線不能指望上游工具拒止。Ren、Shen、Duong、Ng 與 Raj(2026)用同一請求——把帶測試佔位符的薪資單總薪資從 3,250 美元改至 5,850 美元——在三種措辭下測試 15 個模型配合模擬工具的表現(計劃 450 次,獲 445 次可觀測試驗)[2]。明言貸款用途時,發出編輯調用的比例為 14.1%(15 個模型中 3 個至少調用一次);省略用途時為 33.1%(7 個模型);稱為修正打印錯誤時達 66.2%(12 個模型)[2]。其中一個模型拒絕了全部 10 次貸款用途請求,卻在全部 10 次省略用途試驗中發出了調用[2]。該測試用標記測試文件與模擬工具,未執行真實編輯,僅衡量調用發出率而非成功偽造,非倫理排名,亦缺少合法更正與欺詐意圖的對照[2];它説明的是,在該設定下,是否發出編輯調用會隨措辭明顯變化。
最後,我們借用 Temoshok 等人(2025)在美國國家標準與技術研究院《數字身份指南:身份核驗與註冊》中的區分(該文件是針對憑證服務機構的聯邦身份核驗指南,非信貸規則)[3]。指南區分身份解析、證據核驗、屬性核驗與身份驗證:證據核驗確認證據真實(未偽造或篡改)、準確且有效(未過期),方法含受訓人員目視檢查、自動化文檔核驗及數字證據來源與完整性的密碼學核驗[3]。核心屬性須對照權威來源(簽發源或可直接訪問簽發源資訊的機構)或可信來源核實;在身份驗證方法中,指南還列出以小額存款等交易核驗確認金融帳戶歸屬[3]。
工程落地與 rlab.works 能力映射:標識符對賬、來源求證與正反證據備忘
我們的工程判斷是,受理核驗應落實六點:按文檔提取姓名、帳戶尾號、税號與地址並做文件內及跨文件對賬,顯式容忍多帳戶、掩碼差異與搬遷等合法變化;將衝突作為初篩標記交人工複核而非自動拒件;決策依賴出處時向簽發源或可信渠道求證;檢查書籤、檔案名稱與元數據等非可見痕跡;留存證據備忘與審計軌跡;依賴任何規則前先用真實樣本實測誤報率。
在 rlab.works 的智能中樞與智能感知模組中,可用三項技能包與三項組件對照上述流程,並聲明遷移邊界:
- 受理登記與權限留痕:智能中樞的服務受理與轉交(S09)按「核對帳戶與角色 → 建立服務記錄 → 批准交接資料(人工關口) → 轉交負責人」運行,配合運營身份、權限與審計軌跡記錄誰訪問了哪份文件並留存可審計操作。該包僅標有醫療健康可遷移標籤(僅限行政服務,不按症狀分診),無金融標籤;用於信貸屬借用接件模式,須重接身份與案件系統。
- 欄位契約與衝突保留:智能感知的多源資料合併(S28)按「匯入各方資料 → 合併同一對象 → 分類並標明缺口 → 補查並確認(人工關口)」運行,配合金融領域的可審計的數據審核與數據庫發佈流水線支援對標識符與實體的人工合併與覆寫。該包僅在旅遊目錄中驗證過「每個供應商需有欄位契約並保留衝突與來源」;類比至信貸可按單據定義契約並保留衝突供人工複核,但它並非為金融文檔構建。
- 正反證據備忘與人工裁決:智能感知的正反證據備忘(S25)按「收集證據 → 梳理對象與關係 → 對照正反證據 → 定稿備忘(人工關口)」運行,配合金融領域的投資論點證據與結論跟蹤對來源評級、區分支援與反對及複雜化證據,並保留人工可覆寫結論。該包在金融中僅驗證於投研備忘(輸出供研究參考,非交易指令);此處類比生成文檔真實性備忘,信貸決定仍由人做出。
三項技能包均為基於合成數據的「擬議未集成」方案,三項組件的可用評級僅基於靜態源碼檢查;它們均不檢測偽造,也不會聯絡簽發機構核驗。
升級文檔受理核驗流程前的三項行動清單
- 建立含非可見元數據的標識符對賬初篩:提取文件內與跨文件的帳戶、税號、姓名及書籤、檔案名稱比對,將衝突作為人工複核線索而非自動拒件。
- 區分內部一致性與簽發源確認:一致不證明文件出自簽發機構;授信依賴出處時,須引入簽發源直連、密碼學驗籤或小額存款等渠道確認。
- 在真實樣本上實測誤報率並固化證據備忘:上線前用含多帳戶、改址與不同掩碼的真實樣本測算誤報率,並在人工裁決時留存正反證據備忘。
覺得有用?分享給需要的人。
參考文獻
- [1]
Ren, S., Shen, X., Duong, T., & Raj, A. (2026). Can loan processors and underwriters spot AI-edited statements? An empirical study (arXiv:2610.30758). arxiv.org ↗
- [2]
Ren, S., Shen, X., Duong, T., Ng, T., & Raj, A. (2026). How firm are AI models' ethical boundaries? A pay-stub editing test of 15 models (arXiv:2610.30751). arxiv.org ↗
- [3]
Temoshok, D., Abruzzi, C., Choong, Y.-Y., Fenton, J. L., Galluzzo, R., LaSalle, C., Lefkovitz, N., Regenscheid, A., & Vachino, M. (2025). *Digital identity guidelines: Identity proofing and enrollment* (NIST SP 800-63A-4). National Institute of Standards and Technology. doi.org/10.6028/NIST.SP.800-63A-4
相關能力
技能包
S09 · 智能中樞
服務受理與轉交
客戶提出問題後,客服需核實身份、查詢資料、尋找負責人,多次轉交仍無人跟進。
先核對帳戶與角色,建立服務記錄,僅向負責人移交必要資料,交接均留有回執。
- 核對帳戶與角色
- 建立服務記錄
- 批准交接資料人工複核
- 轉交負責人
4 步1 處人工複核10 個組件
S28 · 智能感知
多源資料合併
同一對象在多個系統中各有一份資料,名稱不一、欄位不全,越用越混亂。
將多方資料合併為統一目錄並標明缺失項,補查到的新事實經人工確認後方可寫入。
- 匯入各方資料
- 合併同一對象
- 分類並標明缺口
- 補查並確認人工複核
4 步1 處人工複核10 個組件
S25 · 智能感知
正反證據備忘
研究判斷只記錄結論,一段時間後難以説清當初的依據與反對意見。
將資料、論點與反證集中記錄,標明支援、反對與存疑,經人工複核後存為可追溯的備忘。
- 收集證據
- 梳理對象與關係
- 對照正反證據
- 定稿備忘人工複核
4 步1 處人工複核8 個組件