当“塞满上下文窗口”失效:长文本迷失中间(Lost in the Middle)与智能体分层记忆生命周期
长上下文中段信息的召回会退化,全量塞入历史还会推高延迟与费用;企业记忆应分层蒸馏,带时效权重,并支持过期清理与人工纠偏。

把全部历史塞进提示词,为何反而丢掉关键契约
设想这样一种情形:某团队在搭建跨周投研助手或合同审查台时,看到底层大模型支持极长的上下文窗口,便省去检索与状态管理,直接将过往多周的纪要、对话记录与整本合同附件一次性拼接到提示词中。上线后很快暴露出主要问题:当关键限制条款或客户近期修正的偏好夹在长文本中段时,模型可能漏读并沿用旧假设;同时,随着历史累积,按词元(token)线性计费的调用账单随输入长度攀升,而底层自注意力计算量随序列长度呈二次方增长,显著拉长了响应延迟。
这一困境揭示了长窗口不等于可靠记忆。长上下文中段信息的召回会退化,全量塞入历史还会推高延迟与费用;企业记忆应分层蒸馏,带时效权重,并支持过期清理与人工纠偏。
从“迷失中间”到虚拟上下文管理:长文本与外部记忆的机制拆解
为何扩大上下文窗口无法直接解决企业级知识与状态留存?多项研究从位置敏感性、非参数化检索与分层存储解释了其机制。
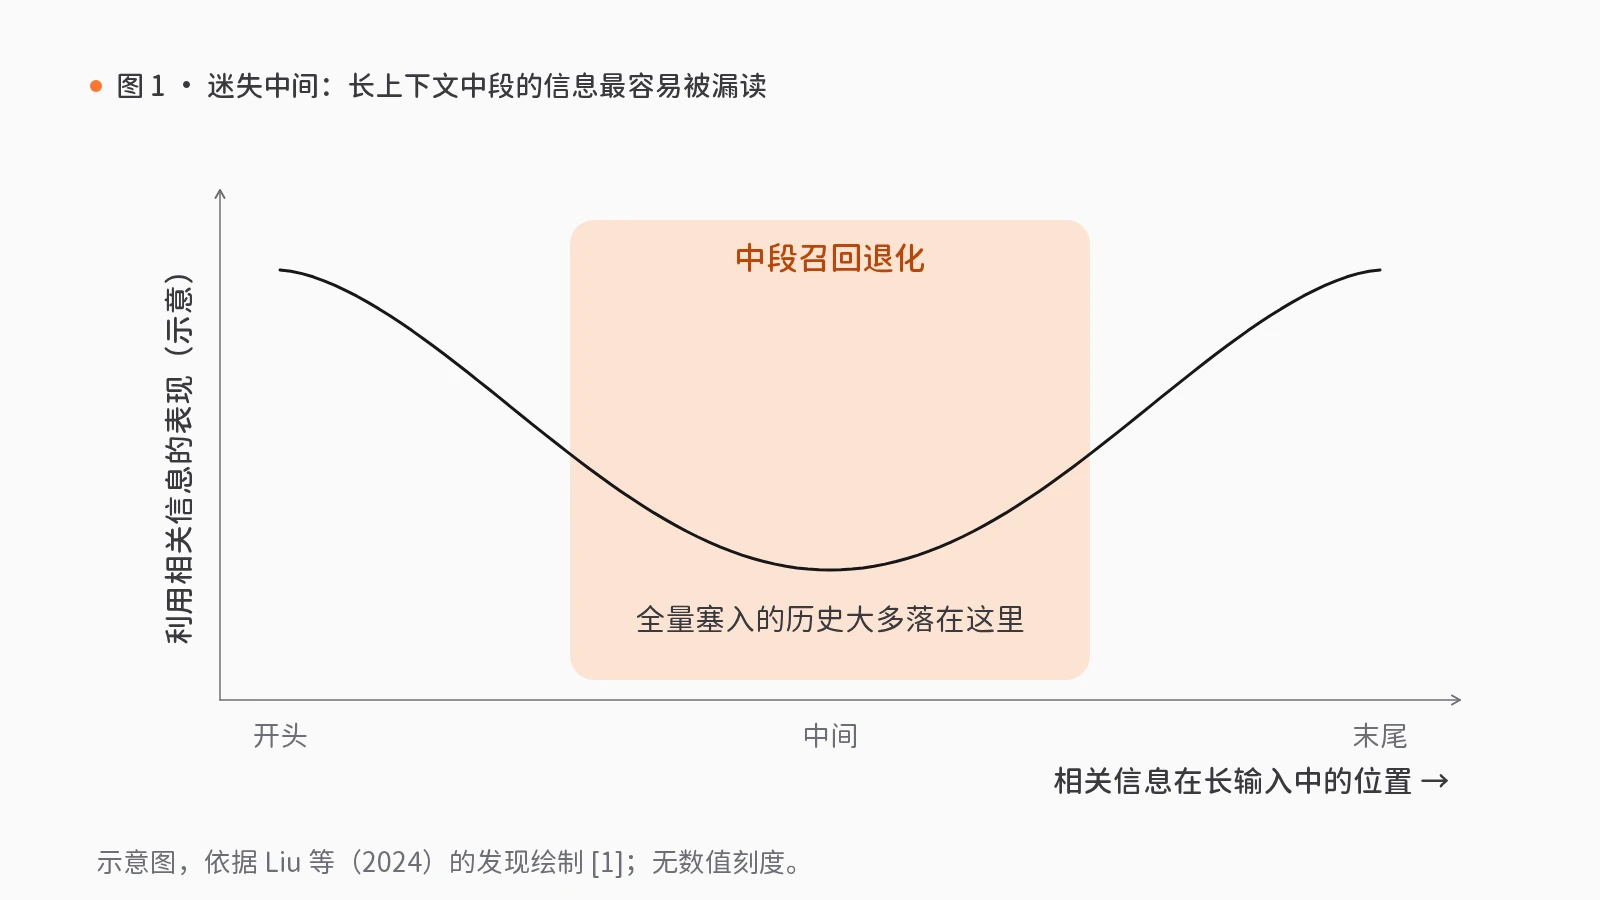
首先,模型对长输入上下文的使用并不均衡。Liu 等人(2024)针对需要在输入上下文中识别相关信息的两类任务——多文档问答与键值对检索——分析了语言模型的表现[1]。研究发现,改变相关信息在输入中的位置会导致模型表现显著退化,表明当前语言模型尚不能稳健地利用长输入上下文中的信息[1]。具体而言,当相关信息出现在输入上下文的开头或末尾时,模型表现通常最高;而当模型必须访问长上下文中间位置的相关信息时,即便对于专门设计的长上下文模型,其表现也会显著退化[1]。将全量历史原封不动塞入窗口,恰恰会把大量关键过程事实推入易被忽略的中段区域。
再次,面对长周期交互与大型文档,上下文窗口本质上是稀缺的快速缓存。Packer 等人(2023)指出,受限的上下文窗口阻碍了大语言模型在长对话与文档分析中的效用[3]。受传统操作系统通过快慢存储间的数据移动来提供大容量内存表象的分层内存系统启发,他们提出了虚拟上下文管理技术并构建了 MemGPT:通过管理不同内存层级,在有限窗口内提供扩展上下文,并利用中断机制管理自身与用户间的控制流[3]。在文档分析(分析远超底层模型窗口的大型文档)与多会话聊天(创建在长期交互中记忆、反思并动态演进的对话智能体)两个领域的评估显示,这种分层调度可以在固定窗口之外处理更多上下文[3]。
把记忆做成受控生命周期:分层蒸馏、时效淘汰与人工复核
将上述机制转化为企业工程,核心是放弃“无限追加日志”,将记忆拆解为短期会话缓冲、结构化工作区记忆与受控检索索引,并在写入和引用处设置人工复核与退役机制。
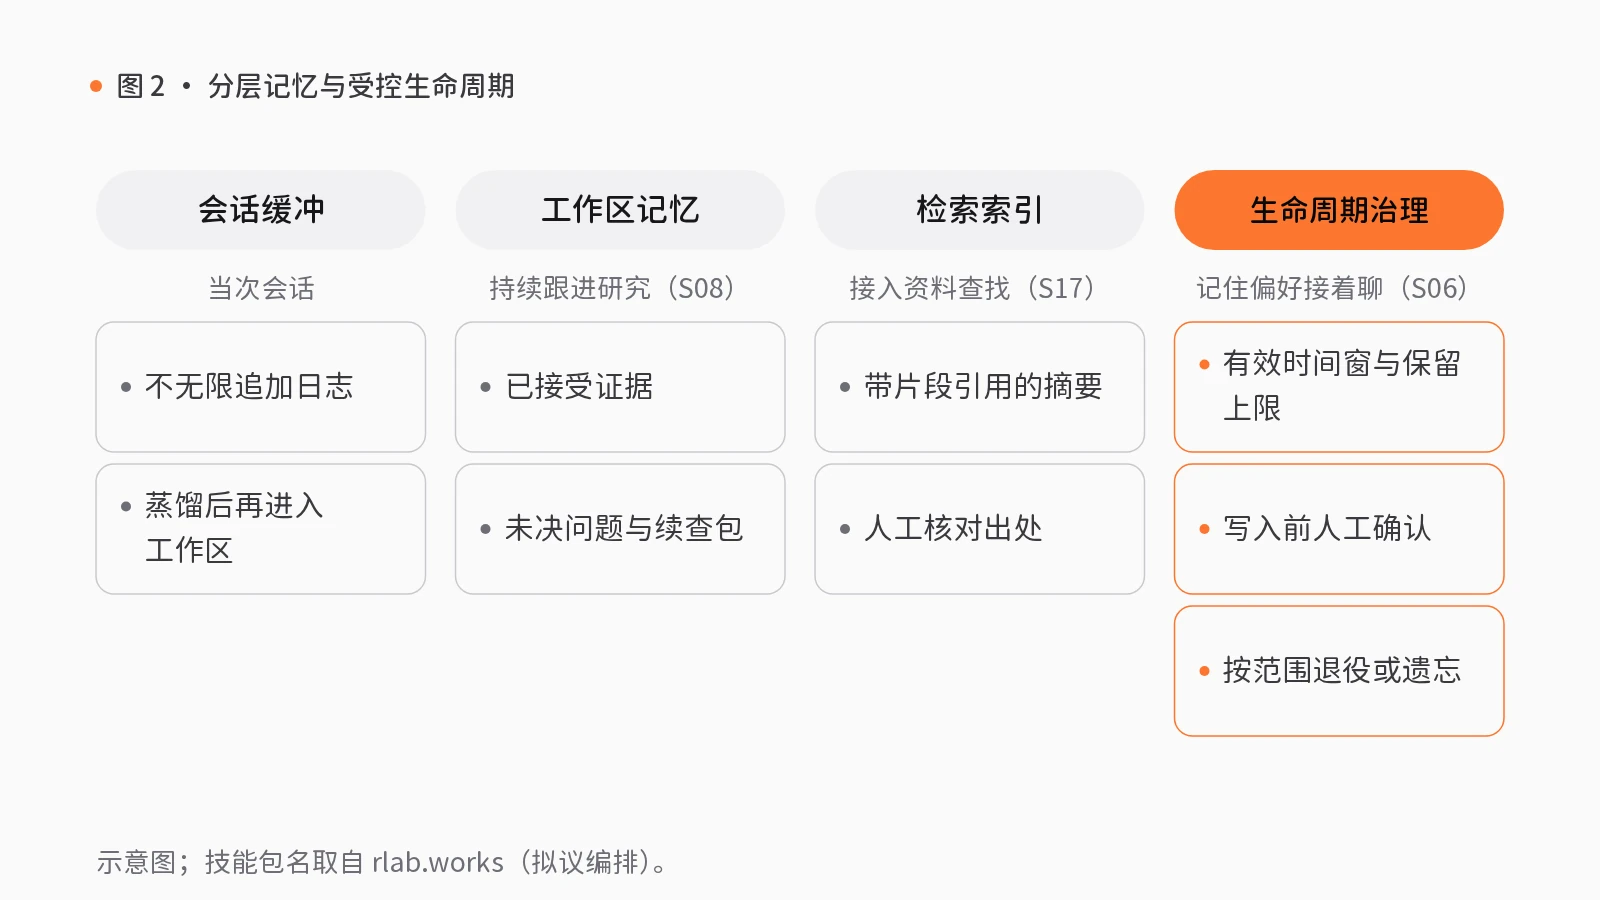
其一,在个体偏好与跟进场景中,技能包用户偏好记忆与回访(S06)以“用户同意、偏好与对话记录”为输入,按“收集自愿提供的偏好 → 整理待记录内容(去重脱敏) → 用户确认记录项(人工复核,被拒绝的输出退回修订且不进入下一步) → 继续对话或转介 → 按约回访”运行,产出用户可改可删的已接受记忆。其底层的个人记忆检索与生命周期组件(经静态源码检查为可运行代码)从对话和签到中提取记忆候选,去重排序,应用有效时间窗与保留上限,并支持手动增删改。该包在消费应用领域属于源数据有行业依据(仅代表源数据有显式行业关联,不代表客户部署或效果),但危机提示不是专业支持,求助草稿仍由用户决定是否发送;在教育领域为可迁移应用,可经成年学习者同意记住练习偏好用于下次练习和可关闭提醒,但须替换原陪伴主题和固定资料,不判断学习能力或心理状况,也不自动发送求助草稿;在金融与法律领域无行业标签,仅作通用模式。
其二,在跨周期任务中,技能包研究续查与归档(S08)以“研究问题、已有材料与可用时间”为输入,经过“调取已有研究 → 制定补查计划 → 批准后执行(人工复核) → 确认新发现(人工复核)”,仅把已接受证据、未决问题与续查包带入下一轮。底层的持久化研究工作区与记忆组件(可运行代码)保存标的池、会话、观察与决策及可复用记忆;而版本化的智能体记忆与知识生命周期组件(可运行代码)则负责导入、评估、版本化、检索并退役或遗忘限定范围内的记忆与知识,同步更新索引和审计历史。该包在金融领域为可迁移应用,可让跨周研究带着上次证据继续,但研究执行与通用搜索、补全队列仍需接线,未标为原生金融流程;在消费、教育与法律领域无行业标签。
其三,针对外部资料,模型网关下的技能包带出处的资料检索(S17)以“问题、授权资料入口与搜索范围”为输入,经收集可查资料、建立相关性排序的检索候选、整理带片段引用的摘要草稿,最终在“核对出处”人工复核关口确认摘要与证据包。它在法律领域为可迁移应用,可把授权合同库接到条款检索并保留原文位置供法务逐条核对,但须接入文档权限与条款位置,且摘要不可自行充当法律意见;在消费、教育与金融领域无行业标签。
需如实说明边界:上述各技能包均为拟议编排,仅通过合成数据走查演示,尚未接入真实服务;组件成熟度均基于静态代码检查而非生产部署。
上线长周期智能体前的管理检验
在批准长文本分析或跨会话智能体试点前,管理层可通过以下检验排查“上下文堆砌”隐患:
- 检验记忆是否分层并配置时效权重:拒绝将全量历史直接拼接进提示词的设计,检查是否区分了当次会话缓冲、蒸馏后的工作区状态与外部检索索引,并设定了有效时间窗与保留上限。
- 检验写入与引用处是否设有人工纠偏关口:确认候选记忆在入库前、以及检索摘要在进入结论前,是否具备可阻断、可删改的人工复核节点,防止中段漏读或过时信息固化为错误前提。
- 检验是否具备按范围退役与遗忘机制:核查当规则更新、合同废止或用户撤回同意时,系统能否按限定范围退役或遗忘对应记忆,并同步更新检索索引与审计记录。
觉得有用?分享给需要的人。
参考文献
- [1]
Liu, N. F., Lin, K., Hewitt, J., Paranjape, A., Bevilacqua, M., Petroni, F., & Liang, P. (2024). Lost in the Middle: How Language Models Use Long Contexts. Transactions of the Association for Computational Linguistics (TACL), 12, 157–173. doi.org/10.1162/tacl_a_00638
- [2]
Lewis, P., Perez, E., Piktus, A., Petroni, F., Karpukhin, V., Goyal, N., Küttler, H., Lewis, M., Yih, W.-t., Rocktäschel, T., Riedel, S., & Kiela, D. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. Advances in Neural Information Processing Systems (NeurIPS), 33, 9459–9474. arxiv.org ↗
- [3]
Packer, C., Wooders, S., Lin, K., Fang, V., Patil, S. G., Stoica, I., & Gonzalez, J. E. (2023). MemGPT: Towards LLMs as Operating Systems. arXiv preprint arXiv:2310.08560. arxiv.org ↗
相关能力
技能包
S06 · 智能中枢
用户偏好记忆与回访
每次对话都需重新询问,用户体验不佳;记录过多,又会引发隐私顾虑。
经用户同意后记录偏好,用户可随时修改或删除;按用户约定的频率回访,可随时停止。
- 收集自愿提供的偏好
- 整理待记录内容
- 用户确认记录项人工复核
- 继续对话或转介
- 按约回访
5 步1 处人工复核10 个组件
S08 · 智能中枢
研究续查与归档
研究中途换人或间隔数周再接手,已查内容与结论依据难以找回。
研究范围与证据全部存档;补查前先报步骤与预算,经批准后执行,新发现经确认后归档。
- 调取已有研究
- 制定补查计划
- 批准后执行人工复核
- 确认新发现人工复核
4 步2 处人工复核6 个组件
S17 · 模型网关
带出处的资料检索
AI 的回答看似完整,却说不清出处,难以直接采用。
仅从授权资料中检索相关段落,摘要标明所引用的段落,经人工核对出处后使用。
- 收集可查资料
- 检索相关段落
- 撰写摘要
- 核对出处人工复核
4 步1 处人工复核5 个组件