當「塞滿上下文窗口」失效:長文本迷失中間(Lost in the Middle)與智能體分層記憶生命週期
長上下文中段資訊的召回會退化,全量塞入歷史還會推高延遲與費用;企業記憶應分層蒸餾,帶時效權重,並支援過期清理與人工糾偏。

把全部歷史塞進提示詞,為何反而丟掉關鍵契約
設想這樣一種情形:某團隊在搭建跨週投研助手或合同審查台時,看到底層大模型支援極長的上下文窗口,便省去檢索與狀態管理,直接將過往多週的紀要、對話記錄與整本合同附件一次性拼接到提示詞中。上線後很快暴露出主要問題:當關鍵限制條款或客戶近期修正的偏好夾在長文本中段時,模型可能漏讀並沿用舊假設;同時,隨着歷史累積,按詞元(token)線性計費的調用賬單隨輸入長度攀升,而底層自注意力計算量隨序列長度呈二次方增長,顯著拉長了響應延遲。
這一困境揭示了長窗口不等於可靠記憶。長上下文中段資訊的召回會退化,全量塞入歷史還會推高延遲與費用;企業記憶應分層蒸餾,帶時效權重,並支援過期清理與人工糾偏。
從「迷失中間」到虛擬上下文管理:長文本與外部記憶的機制拆解
為何擴大上下文窗口無法直接解決企業級知識與狀態留存?多項研究從位置敏感性、非參數化檢索與分層存儲解釋了其機制。
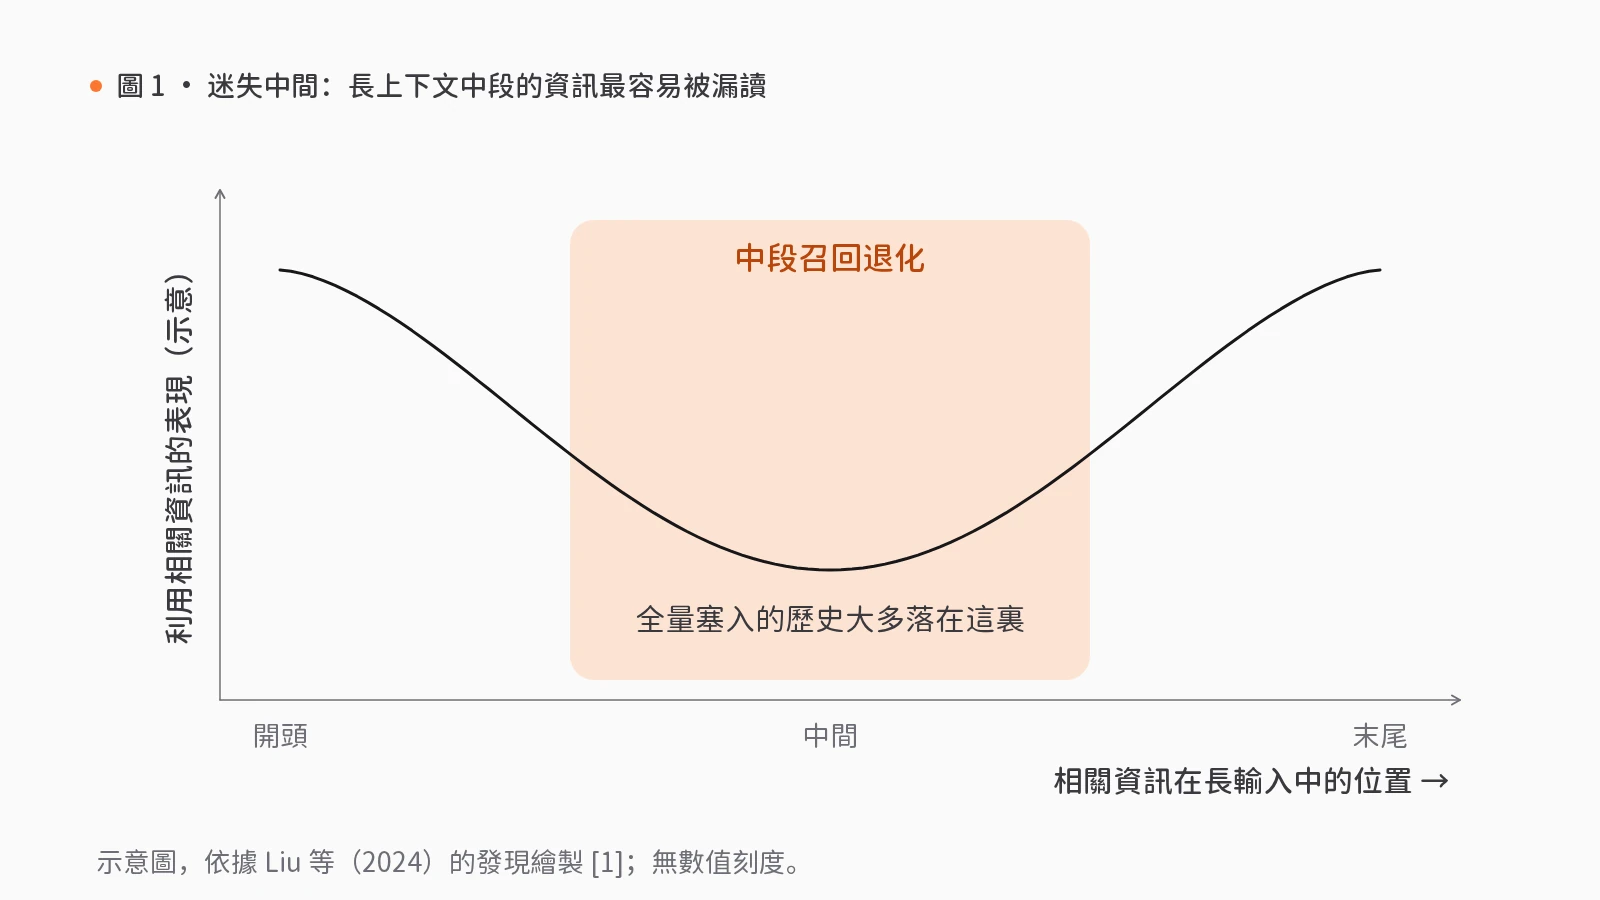
首先,模型對長輸入上下文的使用並不均衡。Liu 等人(2024)針對需要在輸入上下文中識別相關資訊的兩類任務——多文檔問答與鍵值對檢索——分析了語言模型的表現[1]。研究發現,改變相關資訊在輸入中的位置會導致模型表現顯著退化,表明當前語言模型尚不能穩健地利用長輸入上下文中的資訊[1]。具體而言,當相關資訊出現在輸入上下文的開頭或末尾時,模型表現通常最高;而當模型必須訪問長上下文中間位置的相關資訊時,即便對於專門設計的長上下文模型,其表現也會顯著退化[1]。將全量歷史原封不動塞入窗口,恰恰會把大量關鍵過程事實推入易被忽略的中段區域。
再次,面對長週期交互與大型文檔,上下文窗口本質上是稀缺的快速緩存。Packer 等人(2023)指出,受限的上下文窗口阻礙了大語言模型在長對話與文檔分析中的效用[3]。受傳統作業系統通過快慢存儲間的數據移動來提供大容量記憶體表象的分層記憶體系統啓發,他們提出了虛擬上下文管理技術並構建了 MemGPT:通過管理不同記憶體層級,在有限窗口內提供擴展上下文,並利用中斷機制管理自身與用戶間的控制流[3]。在文檔分析(分析遠超底層模型窗口的大型文檔)與多會話聊天(創建在長期交互中記憶、反思並動態演進的對話智能體)兩個領域的評估顯示,這種分層調度可以在固定窗口之外處理更多上下文[3]。
把記憶做成受控生命週期:分層蒸餾、時效淘汰與人工複核
將上述機制轉化為企業工程,核心是放棄「無限追加日誌」,將記憶拆解為短期會話緩衝、結構化工作區記憶與受控檢索索引,並在寫入和引用處設定人工複核與退役機制。
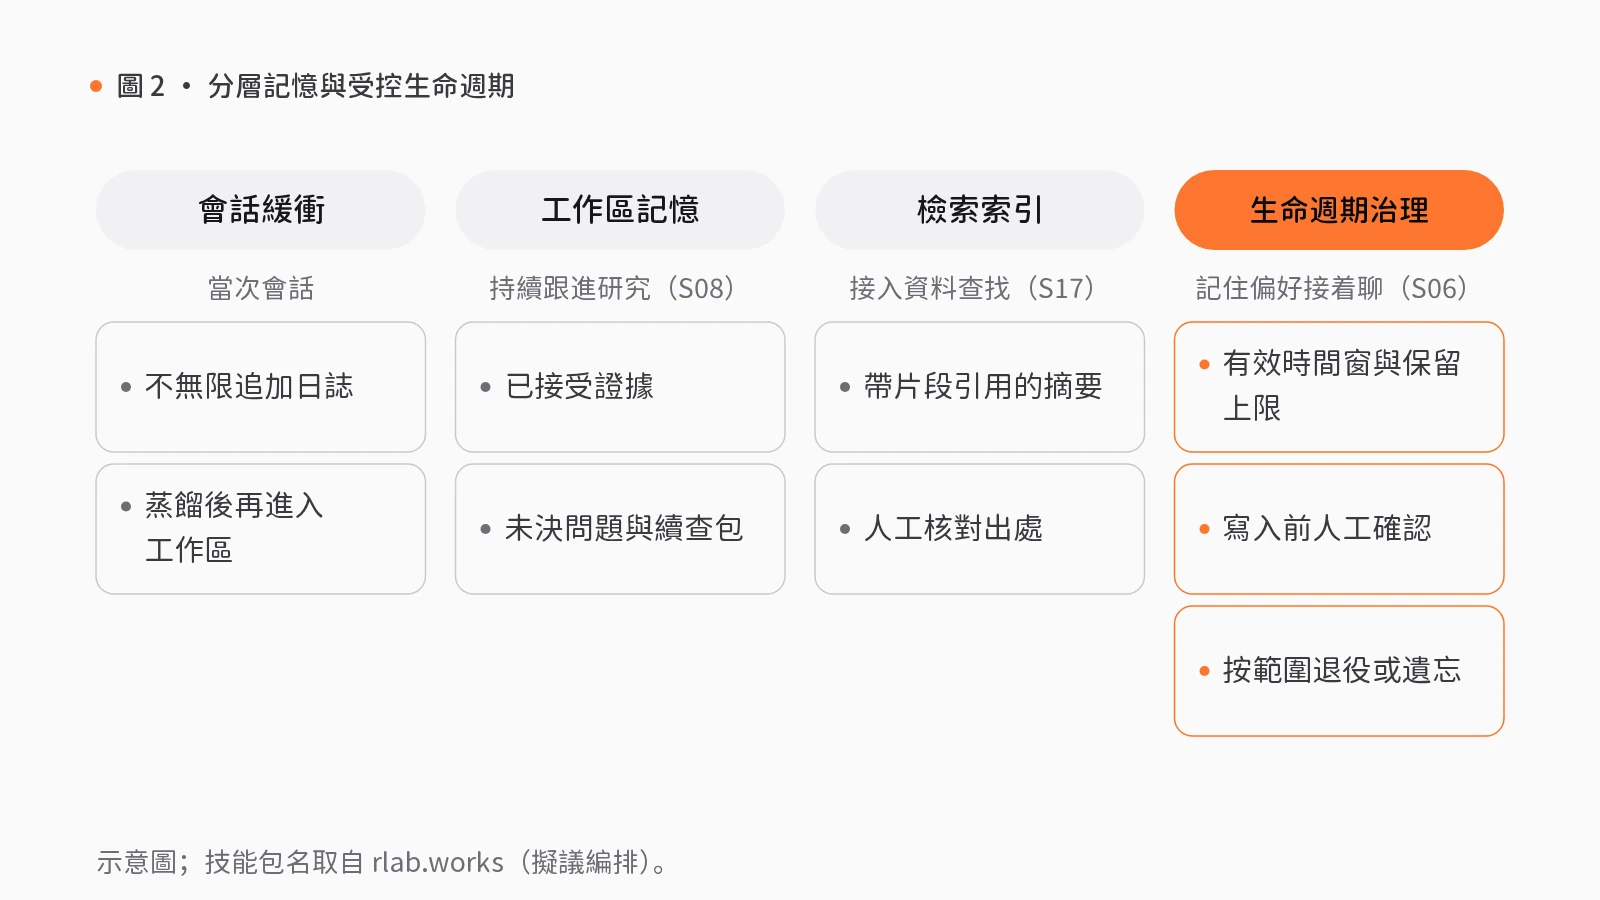
其一,在個體偏好與跟進場景中,技能包用戶偏好記憶與回訪(S06)以「用戶同意、偏好與對話記錄」為輸入,按「收集自願提供的偏好 → 整理待記錄內容(去重脱敏) → 用戶確認記錄項(人工複核,被拒絕的輸出退回修訂且不進入下一步) → 繼續對話或轉介 → 按約回訪」運行,產出用戶可改可刪的已接受記憶。其底層的個人記憶檢索與生命週期組件(經靜態源碼檢查為可運行代碼)從對話和簽到中提取記憶候選,去重排序,應用有效時間窗與保留上限,並支援手動增刪改。該包在消費應用領域屬於源數據有行業依據(僅代表源數據有顯式行業關聯,不代表客戶部署或效果),但危機提示不是專業支援,求助草稿仍由用戶決定是否發送;在教育領域為可遷移應用,可經成年學習者同意記住練習偏好用於下次練習和可關閉提醒,但須替換原陪伴主題和固定資料,不判斷學習能力或心理狀況,也不自動發送求助草稿;在金融與法律領域無行業標籤,僅作通用模式。
其二,在跨週期任務中,技能包研究續查與歸檔(S08)以「研究問題、已有材料與可用時間」為輸入,經過「調取已有研究 → 制定補查計劃 → 批准後執行(人工複核) → 確認新發現(人工複核)」,僅把已接受證據、未決問題與續查包帶入下一輪。底層的持久化研究工作區與記憶組件(可運行代碼)保存標的池、會話、觀察與決策及可複用記憶;而版本化的智能體記憶與知識生命週期組件(可運行代碼)則負責匯入、評估、版本化、檢索並退役或遺忘限定範圍內的記憶與知識,同步更新索引和審計歷史。該包在金融領域為可遷移應用,可讓跨週研究帶着上次證據繼續,但研究執行與通用搜索、補全隊列仍需接線,未標為原生金融流程;在消費、教育與法律領域無行業標籤。
其三,針對外部資料,模型網關下的技能包帶出處的資料檢索(S17)以「問題、授權資料入口與搜尋範圍」為輸入,經收集可查資料、建立相關性排序的檢索候選、整理帶片段引用的摘要草稿,最終在「核對出處」人工複核關口確認摘要與證據包。它在法律領域為可遷移應用,可把授權合同庫接到條款檢索並保留原文位置供法務逐條核對,但須接入文檔權限與條款位置,且摘要不可自行充當法律意見;在消費、教育與金融領域無行業標籤。
需如實説明邊界:上述各技能包均為擬議編排,僅通過合成數據走查演示,尚未接入真實服務;組件成熟度均基於靜態代碼檢查而非生產部署。
上線長週期智能體前的管理檢驗
在批准長文本分析或跨會話智能體試點前,管理層可通過以下檢驗排查「上下文堆砌」隱患:
- 檢驗記憶是否分層並配置時效權重:拒絕將全量歷史直接拼接進提示詞的設計,檢查是否區分了當次會話緩衝、蒸餾後的工作區狀態與外部檢索索引,並設定了有效時間窗與保留上限。
- 檢驗寫入與引用處是否設有人工糾偏關口:確認候選記憶在入庫前、以及檢索摘要在進入結論前,是否具備可阻斷、可刪改的人工複核節點,防止中段漏讀或過時資訊固化為錯誤前提。
- 檢驗是否具備按範圍退役與遺忘機制:核查當規則更新、合同廢止或用戶撤回同意時,系統能否按限定範圍退役或遺忘對應記憶,並同步更新檢索索引與審計記錄。
覺得有用?分享給需要的人。
參考文獻
- [1]
Liu, N. F., Lin, K., Hewitt, J., Paranjape, A., Bevilacqua, M., Petroni, F., & Liang, P. (2024). Lost in the Middle: How Language Models Use Long Contexts. Transactions of the Association for Computational Linguistics (TACL), 12, 157–173. doi.org/10.1162/tacl_a_00638
- [2]
Lewis, P., Perez, E., Piktus, A., Petroni, F., Karpukhin, V., Goyal, N., Küttler, H., Lewis, M., Yih, W.-t., Rocktäschel, T., Riedel, S., & Kiela, D. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. Advances in Neural Information Processing Systems (NeurIPS), 33, 9459–9474. arxiv.org ↗
- [3]
Packer, C., Wooders, S., Lin, K., Fang, V., Patil, S. G., Stoica, I., & Gonzalez, J. E. (2023). MemGPT: Towards LLMs as Operating Systems. arXiv preprint arXiv:2310.08560. arxiv.org ↗
相關能力
技能包
S06 · 智能中樞
用戶偏好記憶與回訪
每次對話都需重新詢問,用戶體驗不佳;記錄過多,又會引發隱私顧慮。
經用戶同意後記錄偏好,用戶可隨時修改或刪除;按用戶約定的頻率回訪,可隨時停止。
- 收集自願提供的偏好
- 整理待記錄內容
- 用戶確認記錄項人工複核
- 繼續對話或轉介
- 按約回訪
5 步1 處人工複核10 個組件
S08 · 智能中樞
研究續查與歸檔
研究中途換人或間隔數週再接手,已查內容與結論依據難以找回。
研究範圍與證據全部存檔;補查前先報步驟與預算,經批准後執行,新發現經確認後歸檔。
- 調取已有研究
- 制定補查計劃
- 批准後執行人工複核
- 確認新發現人工複核
4 步2 處人工複核6 個組件
S17 · 模型網關
帶出處的資料檢索
AI 的回答看似完整,卻説不清出處,難以直接採用。
僅從授權資料中檢索相關段落,摘要標明所引用的段落,經人工核對出處後使用。
- 收集可查資料
- 檢索相關段落
- 撰寫摘要
- 核對出處人工複核
4 步1 處人工複核5 個組件