模型網關(AI Gateway)的工程經濟學:多協議路由、尾延遲治理與語義策略灰度發佈
統一模型網關把異構協議歸一,按任務路由到合適的模型,並集中做提示詞灰度、配額熔斷與批處理,用以控制尾延遲與成本。

直連模型接口的隱性工程税:協議碎片化與延遲毛刺
設想這樣一個場景:某機構內多個工程團隊各自開發知識檢索、長文本批處理與工單輔助工具。起初,各團隊將外部或私有大模型的接口硬編碼在業務代碼裏,憑各自保管的密鑰直連調用。進入持續運行階段後,工程摩擦迅速顯現:當上遊某個端點偶發響應變慢,直連客戶端缺乏統一的超時切換機制,導致業務流水線卡死;當需要升級提示詞模板或更換底層模型時,開發團隊不得不逐一修改應用代碼並重新發版;財務對賬時,分散的調用記錄更無法與部門預留預算對齊。
這種失控源於將模型調用視為零散的外部請求,而非集中調度的基礎設施。統一模型網關把異構協議歸一,按任務路由到合適的模型,並集中做提示詞灰度、配額熔斷與批處理,用以控制尾延遲與成本。
尾延遲容忍、模型級聯與顯存分頁:網關背後的系統機制
為什麼大模型接入層必須集中處理延遲波動、路由策略與批處理調度?分佈式系統與推理服務的相關研究揭示了底層機制。
首先是大規模分佈式服務中的尾延遲規律。Dean 與 Barroso(2013)指出,在大規模服務中,當請求扇出到眾多伺服器時,單個組件的罕見延遲毛刺會主導整體響應時間(“tail latency”)[1]。與其試圖消除所有底層波動,系統更應具備尾延遲容忍能力(“tail-tolerant”),通過備份請求(hedged requests,為慢請求發送副本)、綁定請求(tied requests)、微分區、選擇性複製以及將慢節點置於觀察期(putting slow machines on probation)等技術平滑響應時間[1]。映射到模型接入層,當工作流串聯多次模型調用時,單次慢響應就會拖慢整條鏈路,因此須由網關統一跟蹤節點健康狀態並執行回退。
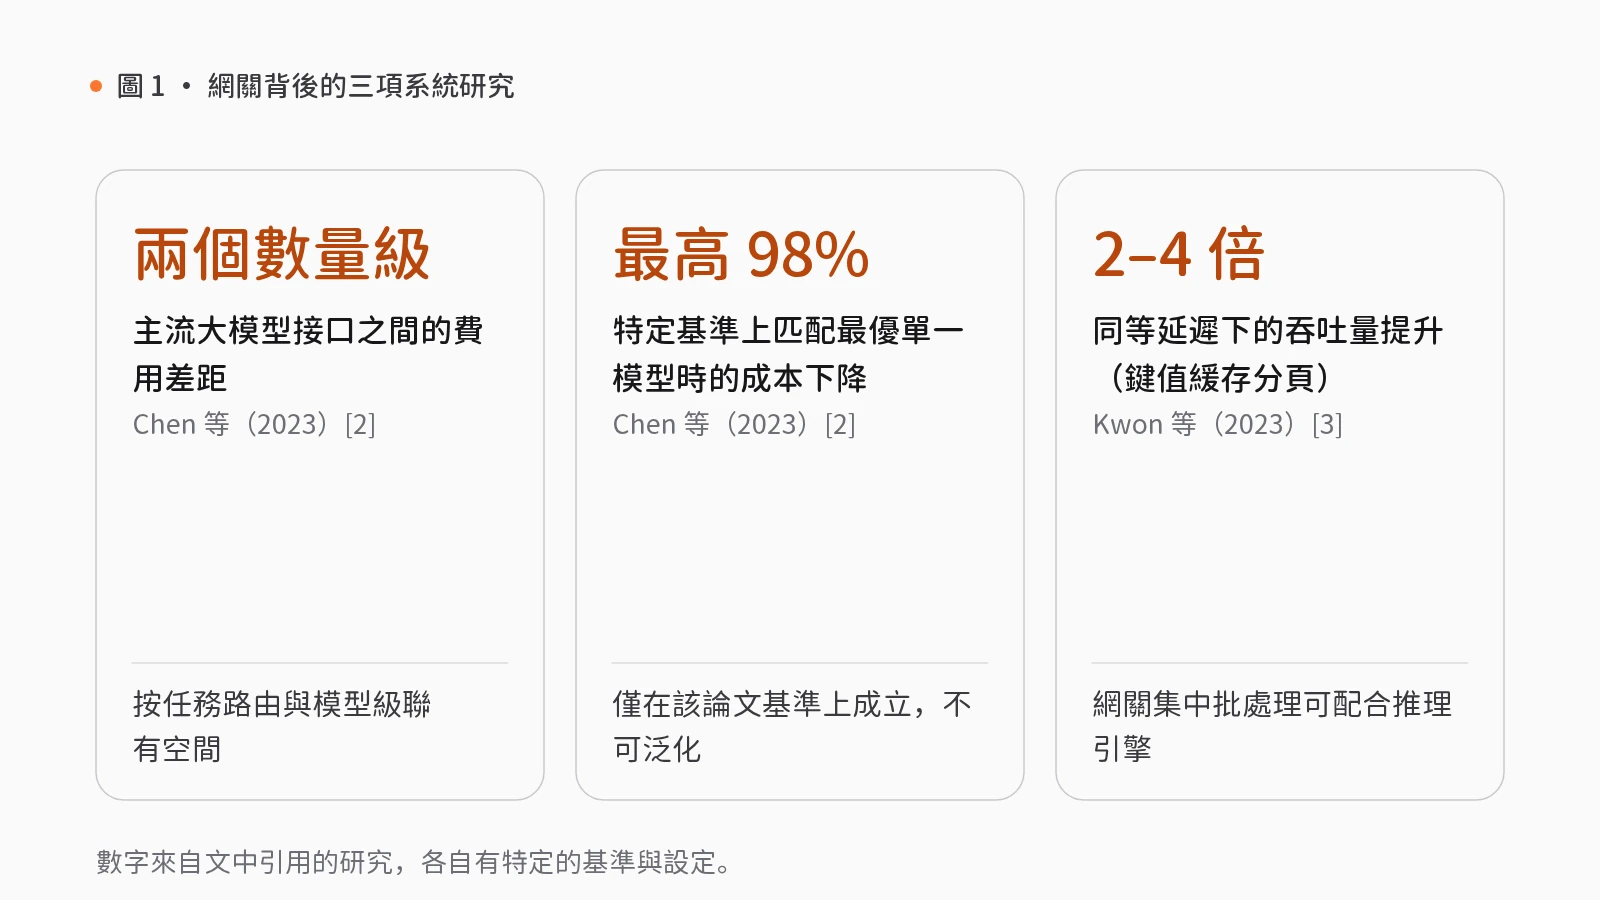
其次是異構模型定價下的級聯路由機制。Chen、Zaharia 與 Zou(2023)審視了主流大模型接口的調用成本,發現不同模型的定價結構呈異構分佈,費用差距可達兩個數量級,在大規模查詢與文本集合上調用模型尤其昂貴[2]。作者歸納了降低推理成本的三類策略:提示詞適配(prompt adaptation)、模型近似(LLM approximation)與模型級聯(LLM cascade)[2]。作為模型級聯的實例,他們提出的框架學習針對不同查詢組合使用哪些模型;在論文特定實驗基準上,該方法在匹配最優單一模型性能的同時實現了最高達 98% 的成本下降,或在同等成本下將準確率提升 4%[2]。需嚴格界定的是,這一幅度僅在該論文所評測的特定基準上成立,不可泛化為一般企業場景的固定收益。
最後是底層推理服務的顯存管理與批處理吞吐。Kwon 等人(2023)指出,大模型的高吞吐服務需要對足夠多的請求進行批處理(batching),但既有系統常受制於鍵值緩存(KV cache):每個請求的鍵值緩存體積龐大且動態伸縮,若管理不當,記憶體碎片與冗餘複製會造成嚴重浪費,限制批處理規模[3]。為此,作者受作業系統經典虛擬記憶體與分頁技術啓發,提出注意力算法 PagedAttention 並構建推理服務系統,實現了鍵值緩存記憶體的近乎零浪費(near-zero waste),以及請求內部與跨請求的靈活鍵值緩存共享;評估顯示,在同等延遲水平下,該系統將主流大模型的吞吐量較既有先進系統提升了 2–4 倍[3],在更長序列、更大模型與更復雜解碼算法下提升更為明顯。我們據此推斷,上游網關若能規範化請求、提升緩存親和性,並將非實時任務集中轉為批量推理,就能配合底層推理引擎釋放吞吐潛力。
網關治理的工程落地:接入驗收、評測切換與配額訪問契約
將上述機制轉化為生產架構,核心是把協議轉換、主備切換、預算對賬與訪問控制沉澱為帶輸入契約與人工複核關口的網關工作流。在 rlab.works 的模型網關模組中,這一過程由組合技能包與底層組件協同承載。
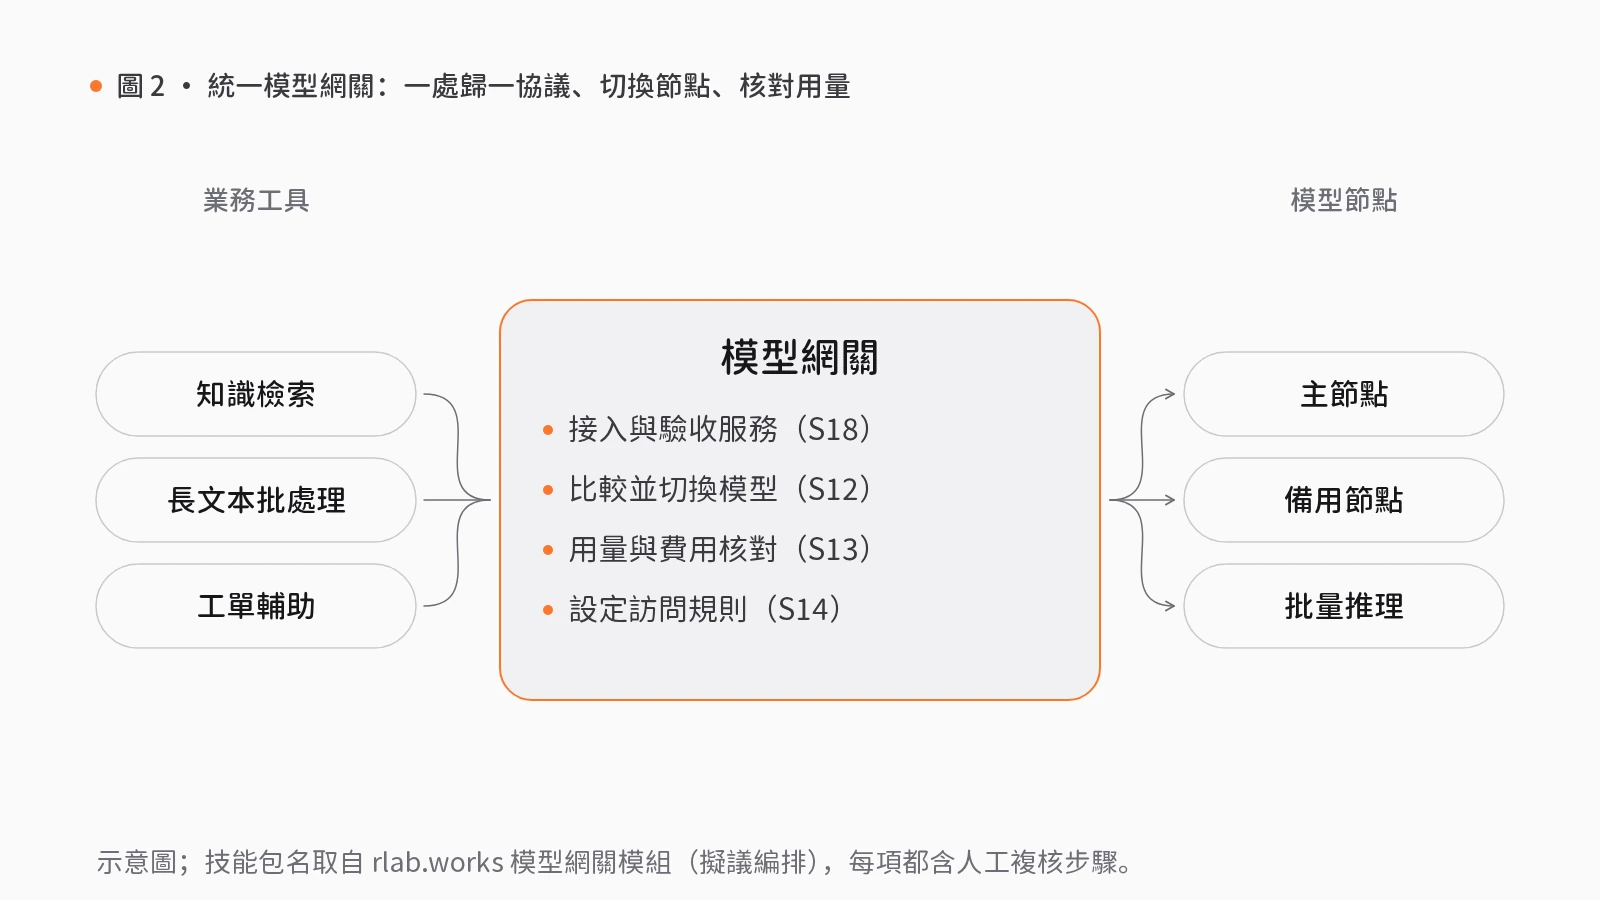
在配額核算與權限控制上,技能包模型用量與費用核算(S13)以「批量任務、計價規則與預算餘額」為輸入,先核對預算並做預留,再結合「供應商批量推理」(通過適配器管理批處理接口請求並持久化批任務元數據)提交任務、收集供應方用量憑據並核算賬本,最後在「人工對賬」人工關口確認賬單或待查差異。技能包團隊模型訪問規則(S14)以「團隊分工、服務目錄與訪問要求」為輸入,經過按角色定規則、人工審閲規則差異、應用規則試查允許與拒絕請求、人工抽查請求記錄等步驟,產出可回退的訪問版本。
需誠實説明適配與成熟度邊界:上述技能包在相關行業均無「源數據有行業依據」標籤,僅作可遷移應用或通用模式。其中,S12 與 S18 僅在企業服務與通用領域為可遷移應用(需用真實樣例核驗兼容性、基於既有記錄審閲建議,不承諾自動找到最優模型;接入需分別檢查心跳、應用響應與部署結果,不假設客戶端工具包支援流式消費或自動重試),在金融與政務領域無標籤。S13 在金融與政務領域為可遷移應用(金融中用於研究工具運營費用對賬,需指定計費責任方並統一單位,不涉及金融交易結算;政務中按部門預算記賬,充值與結算須映射財政流程,不聲稱符合特定製度),在企業服務無標籤。S14 僅在政務與公共領域為可遷移應用(需接入組織身份與實際文檔權限,不能只靠提示詞限制訪問),在企業服務與金融無標籤。此外,站點所有技能包均為擬議編排、尚未接入真實服務,僅以合成數據演示;組件成熟度來自靜態源碼檢查而非生產部署。
上線模型網關前的架構與管理檢驗
技術負責人在立項或採購模型網關前,可用以下檢驗標準審視工程完備性:
- 檢驗健康探測與回退契約是否獨立於業務代碼:上游節點出現尾延遲毛刺時,網關能否在不改業務代碼的前提下,按健康狀態與規則切換備用節點並保持緩存親和性?
- 檢驗模型切換與策略變更是否具備樣例評測與回滾機制:修改路由或提示詞策略時,是否要求在固定樣例集上比對質素與費用差異,並經有阻斷權的人工關口複核後才發佈?
- 檢驗批量任務與訪問控制是否綁定真實預算與身份系統:大宗非實時任務是否先預留預算再轉入批處理,訪問規則是否對接組織身份與底層權限,而非僅靠提示詞軟性約束?
覺得有用?分享給需要的人。
參考文獻
- [1]
Dean, J., & Barroso, L. A. (2013). The Tail at Scale. Communications of the ACM, 56(2), 74–80. doi.org/10.1145/2408776.2408794
- [2]
Chen, L., Zaharia, M., & Zou, J. (2023). FrugalGPT: How to Use Large Language Models While Reducing Cost and Improving Performance. arXiv preprint arXiv:2305.05176. arxiv.org ↗
- [3]
Kwon, W., Li, Z., Zhuang, S., Sheng, Y., Zheng, L., Yu, C. H., Gonzalez, J. E., Zhang, H., & Stoica, I. (2023). Efficient Memory Management for Large Language Model Serving with PagedAttention. Proceedings of the 29th Symposium on Operating Systems Principles (SOSP '23), 611–626. doi.org/10.1145/3600006.3613165
相關能力
技能包
S12 · 模型網關
模型對比與切換
新模型不斷推出,更換擔心效果下降,不換又擔心落後。
用同一批樣例對比新舊模型的質素、錯誤與費用差異,再確定主用與備用模型。
- 檢查可選模型
- 樣例對比
- 審閲切換建議人工複核
- 設定主備模型
- 切換後抽查人工複核
5 步2 處人工複核7 個組件
S13 · 模型網關
模型用量與費用核算
模型賬單月底才出具,超支後也難以説明費用花在哪些請求上。
調用前預留預算,運行後按每次請求記賬,對不上的差異逐條列出。
- 預留預算
- 提交任務
- 逐筆記賬
- 人工對賬人工複核
4 步1 處人工複核5 個組件
S14 · 模型網關
團隊模型訪問規則
團隊普遍使用 AI,但模型與工具的使用權限缺乏管理,出現問題難以追查。
按角色設定訪問規則,規則變更須經審批後生效,再以實際請求測試放行與攔截。
- 按角色定規則
- 審閲規則變更人工複核
- 規則生效
- 抽查請求記錄人工複核
4 步2 處人工複核6 個組件
S18 · 模型網關
新服務試運行接入
接入新服務時,配置一經修改便影響線上,出錯後也缺乏回退方法。
先登記節點、配置調用方式,以少量請求試運行,確認無誤後正式接入,否則回退。
- 登記服務節點
- 配置調用方式
- 少量試運行
- 接入或回退人工複核
4 步1 處人工複核5 個組件