模型网关(AI Gateway)的工程经济学:多协议路由、尾延迟治理与语义策略灰度发布
统一模型网关把异构协议归一,按任务路由到合适的模型,并集中做提示词灰度、配额熔断与批处理,用以控制尾延迟与成本。

直连模型接口的隐性工程税:协议碎片化与延迟毛刺
设想这样一个场景:某机构内多个工程团队各自开发知识检索、长文本批处理与工单辅助工具。起初,各团队将外部或私有大模型的接口硬编码在业务代码里,凭各自保管的密钥直连调用。进入持续运行阶段后,工程摩擦迅速显现:当上游某个端点偶发响应变慢,直连客户端缺乏统一的超时切换机制,导致业务流水线卡死;当需要升级提示词模板或更换底层模型时,开发团队不得不逐一修改应用代码并重新发版;财务对账时,分散的调用记录更无法与部门预留预算对齐。
这种失控源于将模型调用视为零散的外部请求,而非集中调度的基础设施。统一模型网关把异构协议归一,按任务路由到合适的模型,并集中做提示词灰度、配额熔断与批处理,用以控制尾延迟与成本。
尾延迟容忍、模型级联与显存分页:网关背后的系统机制
为什么大模型接入层必须集中处理延迟波动、路由策略与批处理调度?分布式系统与推理服务的相关研究揭示了底层机制。
首先是大规模分布式服务中的尾延迟规律。Dean 与 Barroso(2013)指出,在大规模服务中,当请求扇出到众多服务器时,单个组件的罕见延迟毛刺会主导整体响应时间(“tail latency”)[1]。与其试图消除所有底层波动,系统更应具备尾延迟容忍能力(“tail-tolerant”),通过备份请求(hedged requests,为慢请求发送副本)、绑定请求(tied requests)、微分区、选择性复制以及将慢节点置于观察期(putting slow machines on probation)等技术平滑响应时间[1]。映射到模型接入层,当工作流串联多次模型调用时,单次慢响应就会拖慢整条链路,因此须由网关统一跟踪节点健康状态并执行回退。
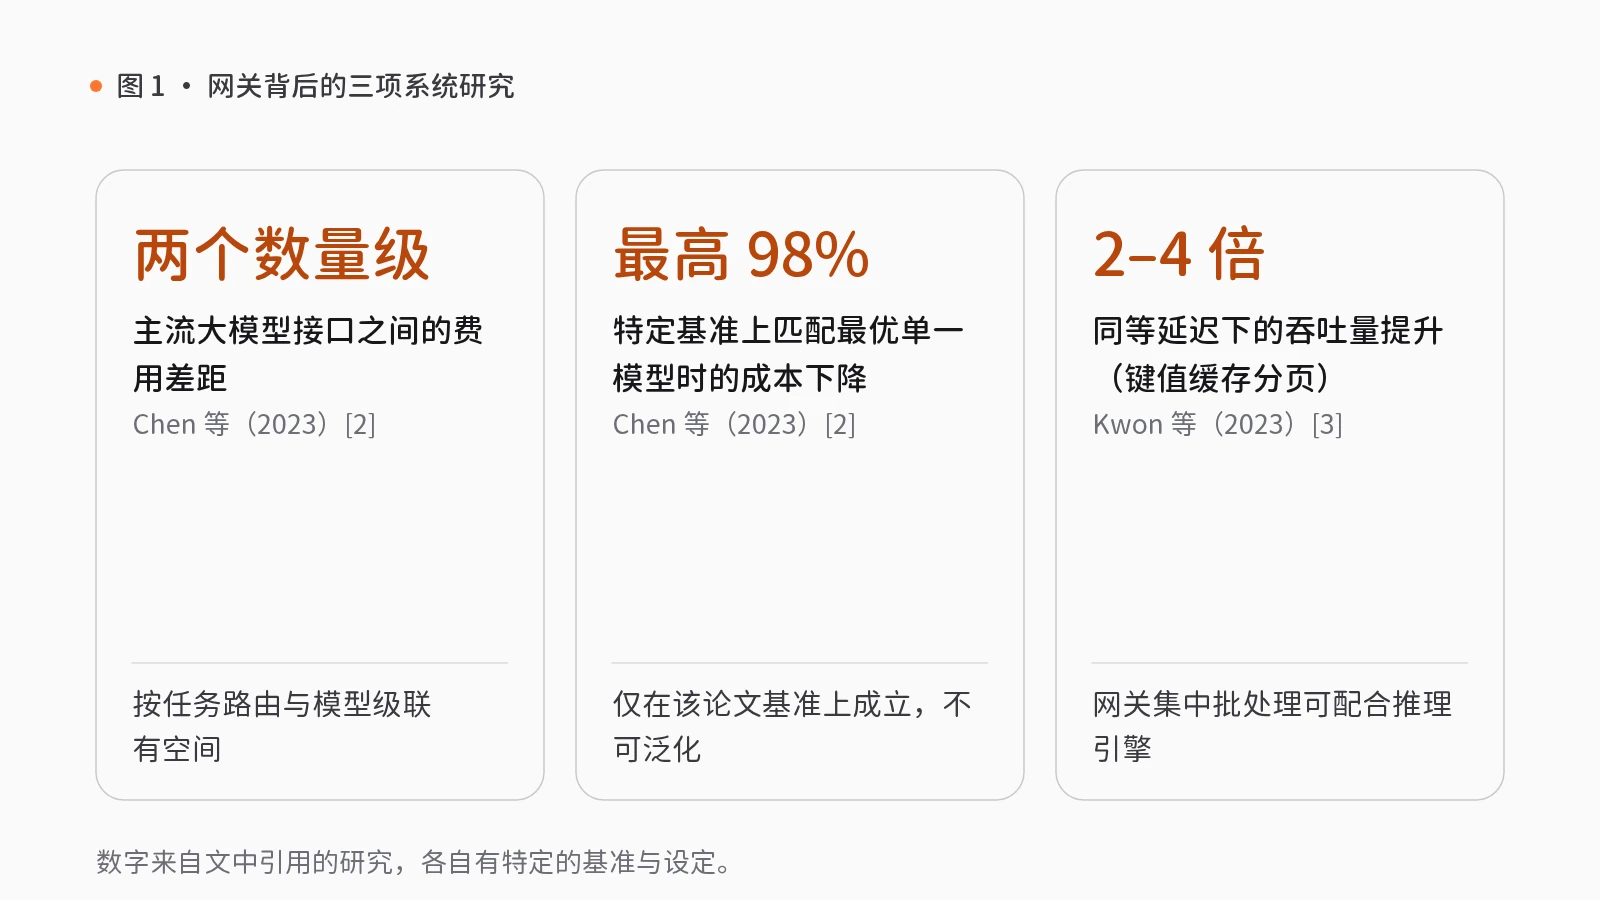
其次是异构模型定价下的级联路由机制。Chen、Zaharia 与 Zou(2023)审视了主流大模型接口的调用成本,发现不同模型的定价结构呈异构分布,费用差距可达两个数量级,在大规模查询与文本集合上调用模型尤其昂贵[2]。作者归纳了降低推理成本的三类策略:提示词适配(prompt adaptation)、模型近似(LLM approximation)与模型级联(LLM cascade)[2]。作为模型级联的实例,他们提出的框架学习针对不同查询组合使用哪些模型;在论文特定实验基准上,该方法在匹配最优单一模型性能的同时实现了最高达 98% 的成本下降,或在同等成本下将准确率提升 4%[2]。需严格界定的是,这一幅度仅在该论文所评测的特定基准上成立,不可泛化为一般企业场景的固定收益。
最后是底层推理服务的显存管理与批处理吞吐。Kwon 等人(2023)指出,大模型的高吞吐服务需要对足够多的请求进行批处理(batching),但既有系统常受制于键值缓存(KV cache):每个请求的键值缓存体积庞大且动态伸缩,若管理不当,内存碎片与冗余复制会造成严重浪费,限制批处理规模[3]。为此,作者受操作系统经典虚拟内存与分页技术启发,提出注意力算法 PagedAttention 并构建推理服务系统,实现了键值缓存内存的近乎零浪费(near-zero waste),以及请求内部与跨请求的灵活键值缓存共享;评估显示,在同等延迟水平下,该系统将主流大模型的吞吐量较既有先进系统提升了 2–4 倍[3],在更长序列、更大模型与更复杂解码算法下提升更为明显。我们据此推断,上游网关若能规范化请求、提升缓存亲和性,并将非实时任务集中转为批量推理,就能配合底层推理引擎释放吞吐潜力。
网关治理的工程落地:接入验收、评测切换与配额访问契约
将上述机制转化为生产架构,核心是把协议转换、主备切换、预算对账与访问控制沉淀为带输入契约与人工复核关口的网关工作流。在 rlab.works 的模型网关模块中,这一过程由组合技能包与底层组件协同承载。
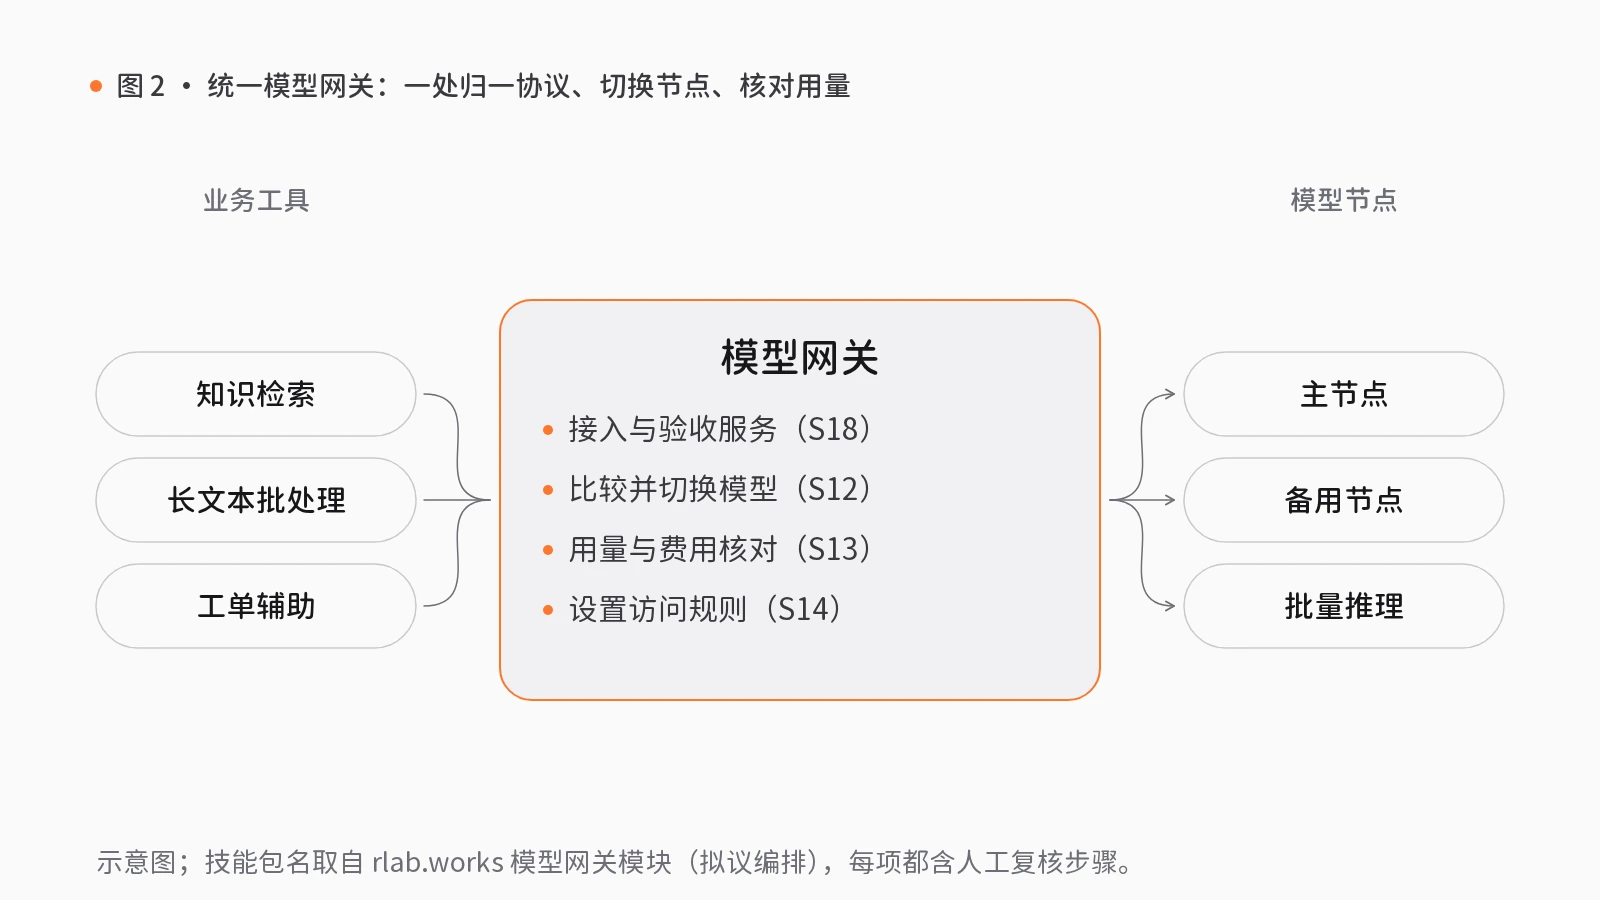
在配额核算与权限控制上,技能包模型用量与费用核算(S13)以“批量任务、计价规则与预算余额”为输入,先核对预算并做预留,再结合「供应商批量推理」(通过适配器管理批处理接口请求并持久化批任务元数据)提交任务、收集供应方用量凭据并核算账本,最后在“人工对账”人工关口确认账单或待查差异。技能包团队模型访问规则(S14)以“团队分工、服务目录与访问要求”为输入,经过按角色定规则、人工审阅规则差异、应用规则试查允许与拒绝请求、人工抽查请求记录等步骤,产出可回退的访问版本。
需诚实说明适配与成熟度边界:上述技能包在相关行业均无“源数据有行业依据”标签,仅作可迁移应用或通用模式。其中,S12 与 S18 仅在企业服务与通用领域为可迁移应用(需用真实样例核验兼容性、基于既有记录审阅建议,不承诺自动找到最优模型;接入需分别检查心跳、应用响应与部署结果,不假设客户端工具包支持流式消费或自动重试),在金融与政务领域无标签。S13 在金融与政务领域为可迁移应用(金融中用于研究工具运营费用对账,需指定计费责任方并统一单位,不涉及金融交易结算;政务中按部门预算记账,充值与结算须映射财政流程,不声称符合特定制度),在企业服务无标签。S14 仅在政务与公共领域为可迁移应用(需接入组织身份与实际文档权限,不能只靠提示词限制访问),在企业服务与金融无标签。此外,站点所有技能包均为拟议编排、尚未接入真实服务,仅以合成数据演示;组件成熟度来自静态源码检查而非生产部署。
上线模型网关前的架构与管理检验
技术负责人在立项或采购模型网关前,可用以下检验标准审视工程完备性:
- 检验健康探测与回退契约是否独立于业务代码:上游节点出现尾延迟毛刺时,网关能否在不改业务代码的前提下,按健康状态与规则切换备用节点并保持缓存亲和性?
- 检验模型切换与策略变更是否具备样例评测与回滚机制:修改路由或提示词策略时,是否要求在固定样例集上比对质量与费用差异,并经有阻断权的人工关口复核后才发布?
- 检验批量任务与访问控制是否绑定真实预算与身份系统:大宗非实时任务是否先预留预算再转入批处理,访问规则是否对接组织身份与底层权限,而非仅靠提示词软性约束?
觉得有用?分享给需要的人。
参考文献
- [1]
Dean, J., & Barroso, L. A. (2013). The Tail at Scale. Communications of the ACM, 56(2), 74–80. doi.org/10.1145/2408776.2408794
- [2]
Chen, L., Zaharia, M., & Zou, J. (2023). FrugalGPT: How to Use Large Language Models While Reducing Cost and Improving Performance. arXiv preprint arXiv:2305.05176. arxiv.org ↗
- [3]
Kwon, W., Li, Z., Zhuang, S., Sheng, Y., Zheng, L., Yu, C. H., Gonzalez, J. E., Zhang, H., & Stoica, I. (2023). Efficient Memory Management for Large Language Model Serving with PagedAttention. Proceedings of the 29th Symposium on Operating Systems Principles (SOSP '23), 611–626. doi.org/10.1145/3600006.3613165
相关能力
技能包
S12 · 模型网关
模型对比与切换
新模型不断推出,更换担心效果下降,不换又担心落后。
用同一批样例对比新旧模型的质量、错误与费用差异,再确定主用与备用模型。
- 检查可选模型
- 样例对比
- 审阅切换建议人工复核
- 设定主备模型
- 切换后抽查人工复核
5 步2 处人工复核7 个组件
S13 · 模型网关
模型用量与费用核算
模型账单月底才出具,超支后也难以说明费用花在哪些请求上。
调用前预留预算,运行后按每次请求记账,对不上的差异逐条列出。
- 预留预算
- 提交任务
- 逐笔记账
- 人工对账人工复核
4 步1 处人工复核5 个组件
S14 · 模型网关
团队模型访问规则
团队普遍使用 AI,但模型与工具的使用权限缺乏管理,出现问题难以追查。
按角色设定访问规则,规则变更须经审批后生效,再以实际请求测试放行与拦截。
- 按角色定规则
- 审阅规则变更人工复核
- 规则生效
- 抽查请求记录人工复核
4 步2 处人工复核6 个组件
S18 · 模型网关
新服务试运行接入
接入新服务时,配置一经修改便影响线上,出错后也缺乏回退方法。
先登记节点、配置调用方式,以少量请求试运行,确认无误后正式接入,否则回退。
- 登记服务节点
- 配置调用方式
- 少量试运行
- 接入或回退人工复核
4 步1 处人工复核5 个组件