多模態感知的工業化流水線:為什麼音影片與圖像理解必須先過「時間軸對齊與版面歸一化」關
工業級多模態流水線應先做時間軸對齊與版面歸一,再用專用索引檢索,並在複核界面上讓每條結論都能回跳到原幀或原截圖區域。

跳過預處理的感知試點,為何在生產複核前停滯
設想這樣一種場景:差旅顧問把不同預訂平台的房價截圖發給視覺模型比價,模型很快給出結論,卻把含早餐的不可退價格與無早餐的可免費取消價格混作同口徑比較,且無法標出條款在原圖中的位置;或者行政團隊將長錄音直接送入轉寫接口生成紀要,但因分段切口漂移與分發副本插播偏移,複核人員無法按文字回跳到原聲位置去核對人名與日期。
這類返工源於工程流水線缺失了前置標準化與證據錨定。工業級多模態流水線應先做時間軸對齊與版面歸一,再用專用索引檢索,並在複核界面上讓每條結論都能回跳到原幀或原截圖區域。
零樣本多模態表徵與大規模向量索引的底層機制
視覺、語音與高維檢索領域的實證研究,既提供了處理非結構化媒體的底層支撐,也劃清了模型表徵與工程約束的邊界。
在視覺表徵方面,Radford 等人(2021)指出,傳統計算機視覺系統通常被訓練來預測固定、預設的物體類別集合,這種受限的監督形式制約了泛化性與可用性,因為指定其他視覺概念還需補充標註數據[1]。為此,研究者利用互聯網上收集的 4 億個(圖像,文本)配對數據集,通過「預測哪段文字説明與哪張圖像匹配」的預訓練任務,從零開始高效且可擴展地學習圖像表徵,並在預訓練後用自然語言指代視覺概念,向各類下游任務實現零樣本遷移[1]。在涵蓋光學字符識別(OCR)、影片動作識別、地理定位及細粒度物體分類等超過 30 個現有計算機視覺數據集的測試中,該模型無需特定數據集訓練即可與全監督基線競爭;例如在含 128 萬個訓練樣本的經典圖像分類基準上,它在零樣本設定下無需使用任何訓練樣本,便追平了原有標準基線的準確率[1]。
在語音感知方面,Radford 等人(2023)研究了僅靠預測互聯網音訊海量轉寫稿所訓練的語音處理系統[2]。當多語言與多任務弱監督規模擴展至 68 萬小時音訊時,所得模型在標準基準上展現出良好的泛化能力,在零樣本遷移設定下無需微調即可與既有全監督結果競爭,並在準確率與魯棒性上接近人類水平[2]。
當媒體被編碼為高維特徵後,海量目錄中的相似性搜尋便成為系統瓶頸。Johnson、Douze 與 Jégou(2021)指出,圖像或影片數據庫依賴專用索引結構;儘管圖形處理器(GPU)擅長距離計算等數據並行任務,既有方法卻受制於並行度不足的候選項選擇算法或記憶體層級利用不佳[3]。他們提出新的候選項選擇設計,用於暴力搜尋、近似搜尋及基於乘積量化的壓縮域搜尋,達到理論峯值性能 55% 的運行效率,使最近鄰搜尋速度達到此前 GPU 最高水平的 8.5 倍[3]。在 4 塊 GPU 上,該方法可在 35 分鐘內為公開數據集的 9500 萬張圖像構建高精度近鄰圖,並在不到 12 小時內構建連接 10 億個向量的圖結構[3]。
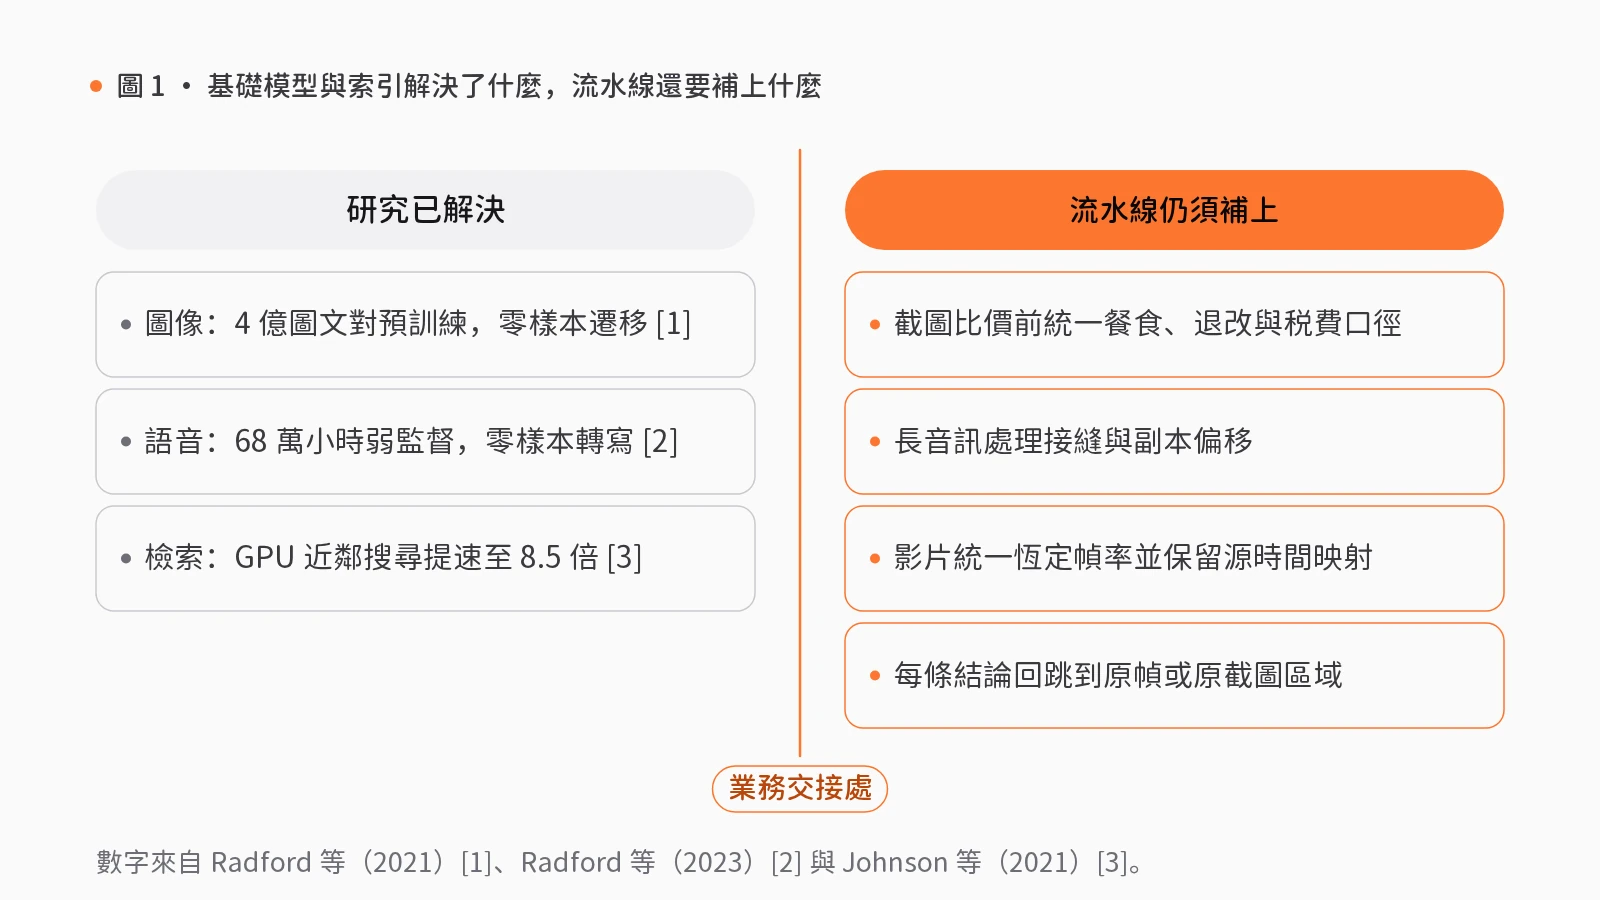
上述研究表明:大規模預訓練與專用 GPU 索引解決了跨模態語義表徵與高維召回的吞吐難題,但並不替業務系統定義音訊切片的時間偏移、多張截圖的比價口徑或畫面中的場地標定。跳過前置歸一化與證據回跳,模型輸出仍會在業務交接處因無法核驗而難以落地。
時間軸對齊、版面歸一與回跳複核的流水線編排
在 rlab.works 的智能感知與模型網關模組中,多模態工作流將前置對齊、專用索引與人工複核關口固化為明確契約:
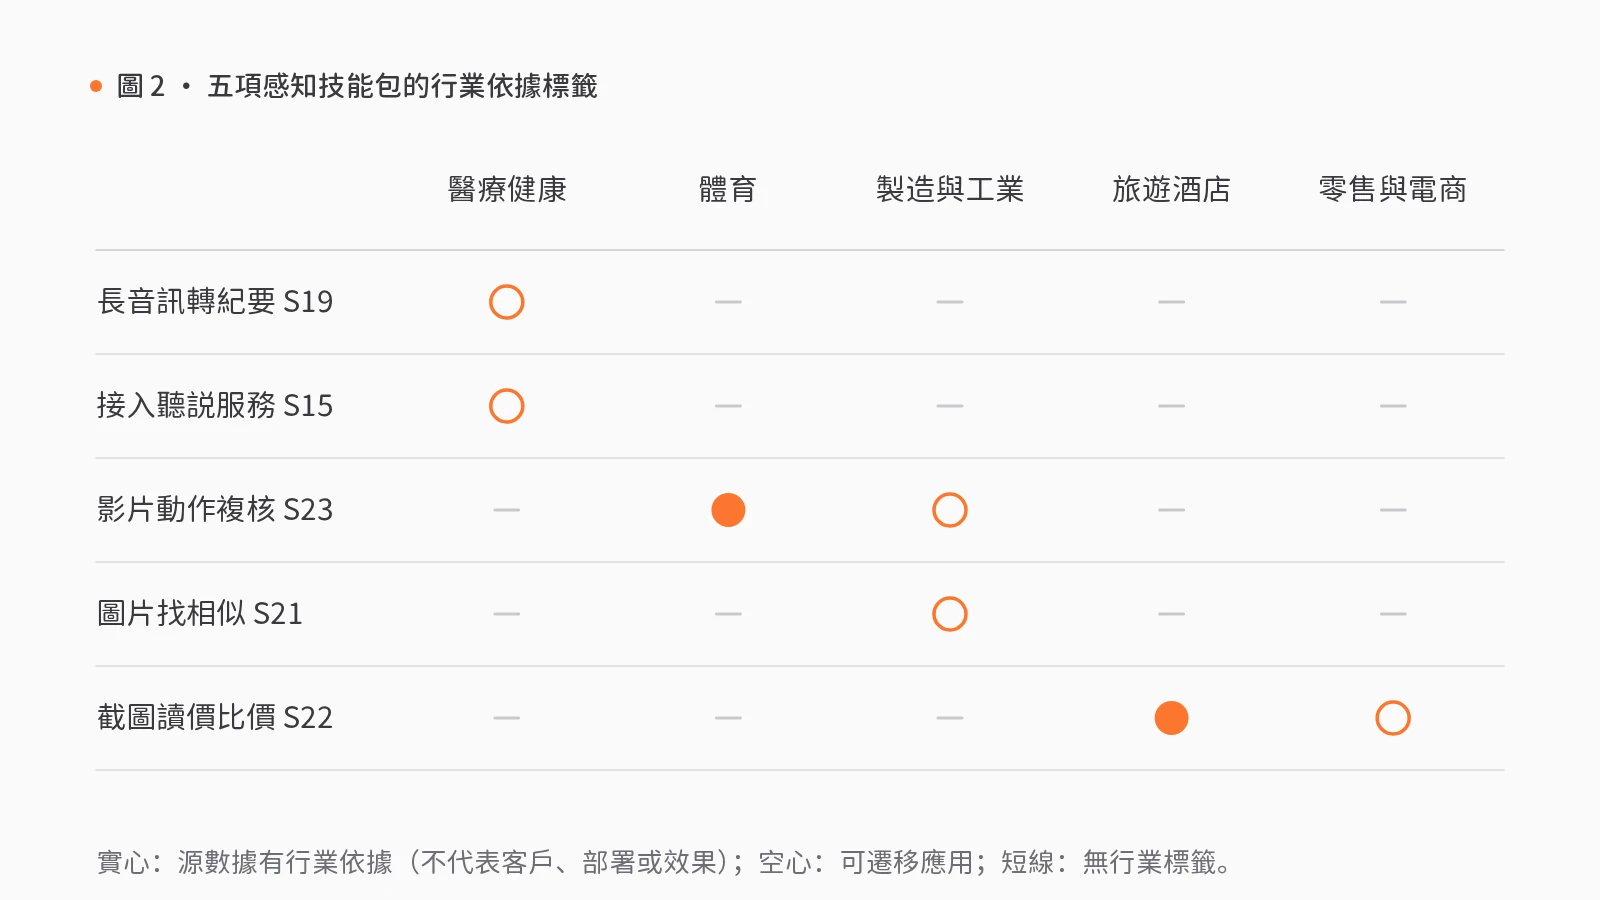
- 長音訊與語音會話的時間軸對齊:技能包長錄音生成紀要(S19)以授權錄音、媒體資訊與紀要要求為輸入,先整理錄音與保留規則,再由「長音訊轉寫、重疊對齊與説話人拼接」組件切分有界任務、處理接縫並輸出帶位置的轉寫與副本偏移;隨後在「核對文字與發言人」和「定稿匯出」處設人工複核關口(被拒絕產出退回修訂且不進入下一步),最終匯出已確認紀要與原音定位。技能包「語音交互接入(S15)」以經同意的音訊、語言和輸出方式為輸入,轉寫並識別意圖後,須經「確認回覆內容」人工複核關口確認文字,再播報回覆並檢查會話記錄。在醫療健康領域,二者均為可遷移應用:前者把經同意錄製的預約服務訪談整理成帶時間位置的紀要並由行政人員核對人名和日期,只作服務記錄,不用於診斷或病歷自動判定,須限制保存週期與查閲權限;後者僅接入行政問答,重要日期先由工作人員核對再讀給來訪者,轉寫服務、人工確認界面和實時會話需單獨編排。二者在體育、旅遊酒店與製造領域均無行業標籤。
- 影片畫面的幀精確歸一與軌跡回放:技能包錄像動作標註與複核(S23)以授權錄像、場地資訊與複核目標為輸入,先由人工確認錄像來源,再通過「媒體檢查與幀精確歸一化」組件統一恆定幀率與分辨率,保留源時間資訊與身份標識,生成有源時間映射的工作影片。標出帶時間位置的候選軌跡後,在「對照要求複核」關口由人工校正軌跡、標註與事件,再彙總統計並生成標註回放與複核包。它在體育領域為源數據有行業依據,可將比賽錄像中的球跡候選交給分析員校正,現有範圍限於指定球場球跡,速度讀數受標定與事件條件限制;在製造與工業領域為可遷移應用,可標出工位可疑動作讓班組長對照標準作業程式確認,但須重做工位標定、動作候選和工序統計,現有組件不自動識別標準作業程式或判定違規。
- 圖像索引與截圖版面口徑歸一:技能包以圖搜尋相似商品(S21)先經人工複核檢查目錄數據,再由「商品目錄與多模態索引」組件批量生成標註了模型的圖像向量並與結構化屬性持久化,找出分層候選後,在「核對規格並選定」關口由人工核對規格。它在製造與工業領域為可遷移應用,可拍舊零件照片找外觀候選並由維修員核對型號、尺寸和替代條件,但需物料欄位和圖片域適配,外觀相似只供找件,不認定機械兼容或安全。技能包報價截圖比價(S22)在定位原報價並讀出有出處的價格與條件候選後,先統一口徑,再由人工核對差異與取捨。它在旅遊酒店領域為源數據有行業依據,但截圖不代表當前可訂庫存,下單前須重新核驗報價;在零售領域為可遷移應用,須替換酒店採集入口、欄位識別和排序規則。
需如實説明邊界:上述技能包均為擬議編排,僅基於合成數據演示,尚未接入真實服務;所提組件均為基於靜態源碼檢查的可運行代碼,而非生產部署;「源數據有行業依據」僅表示源數據有顯式行業關聯,不代表客戶、部署或效果。
啓動多模態感知試點前的管理檢驗
管理層在資助多模態試點前,可通過以下檢驗評估流水線設計:
- 是否先完成時間軸與版面口徑歸一? 檢查長音訊是否處理了接縫與副本偏移,影片是否統一了恆定幀率與源時間映射,報價截圖是否在比價前統一了餐食、退改或税費口徑。
- 每條結論能否回跳到原始媒體位置? 確認紀要、軌跡事件、相似候選或比價欄位均保留原音時間戳、影片幀映射或截圖出處,拒絕無法回查原件的黑盒輸出。
- 人工關口是否具備阻斷權與責任邊界? 確認未通過複核的產出會退回修訂,並嚴格執行醫療僅作服務記錄、製造外觀找件不作安全認定、旅遊截圖不代表實時庫存的邊界約束。
覺得有用?分享給需要的人。
參考文獻
- [1]
Radford, A., Kim, J. W., Hallacy, C., Ramesh, A., Goh, G., Agarwal, S., Sastry, G., Askell, A., Mishkin, P., Clark, J., Krueger, G., & Sutskever, I. (2021). Learning Transferable Visual Models From Natural Language Supervision. Proceedings of the 38th International Conference on Machine Learning (ICML), PMLR 139, 8748–8763. arxiv.org ↗
- [2]
Radford, A., Kim, J. W., Xu, T., Brockman, G., McLeavey, C., & Sutskever, I. (2023). Robust Speech Recognition via Large-Scale Weak Supervision. Proceedings of the 40th International Conference on Machine Learning (ICML), PMLR 202, 28492–28518. arxiv.org ↗
- [3]
Johnson, J., Douze, M., & Jégou, H. (2021). Billion-Scale Similarity Search with GPUs. IEEE Transactions on Big Data, 7(3), 535–547. doi.org/10.1109/TBDATA.2019.2921572
相關能力
技能包
S19 · 智能感知
長錄音生成紀要
長達數小時的會議和訪談,整理紀要還需重新回聽。
分段轉寫並對齊時間,生成紀要草稿,每條要點均可回溯至原始錄音。
- 整理錄音
- 轉寫並對齊時間
- 核對文字與發言人人工複核
- 撰寫紀要草稿
- 定稿匯出人工複核
5 步2 處人工複核6 個組件
S21 · 智能感知
以圖搜尋相似商品
客戶發來圖片詢問是否有貨,人工逐一翻查目錄,效率低且容易遺漏。
以圖片或文字在商品目錄中查找外形相近的候選,經人工核對規格後確定選擇。
- 檢查目錄數據人工複核
- 建立圖片索引
- 查找相似候選
- 核對規格並選定人工複核
4 步2 處人工複核3 個組件
S22 · 智能感知
報價截圖比價
各方報價截圖格式不一,是否含税、包含哪些權益各不相同,人工比價容易混淆口徑。
從截圖與連結中提取價格和條件,統一口徑後比較,差異經人工核對後取捨。
- 查找報價來源
- 提取價格與條件
- 統一口徑
- 比較並核對人工複核
4 步1 處人工複核7 個組件
S23 · 智能感知
錄像動作標註與複核
人工逐幀查看錄像尋找關鍵動作,耗時費力,結論也難以複查。
系統在錄像中標註候選動作,由人工對照要求確認,再生成帶標註的回放與可複查的複核包。
- 確認錄像來源人工複核
- 對齊時間與畫面
- 標註候選動作
- 對照要求複核人工複核
- 彙總確認事件
- 生成標註回放
- 移交複核包
7 步2 處人工複核8 個組件
S15 · 模型網關
語音交互接入
為系統增加語音問答,需分別對接轉寫、理解與合成等多項服務。
將語音轉為文字並識別意圖,回覆內容經人工確認後以選定的聲音播報,會話全程留存記錄。
- 轉寫並識別意圖
- 確認回覆內容人工複核
- 播報回覆
- 檢查會話記錄
4 步1 處人工複核4 個組件