多模态感知的工业化流水线:为什么音视频与图像理解必须先过“时间轴对齐与版面归一化”关
工业级多模态流水线应先做时间轴对齐与版面归一,再用专用索引检索,并在复核界面上让每条结论都能回跳到原帧或原截图区域。

跳过预处理的感知试点,为何在生产复核前停滞
设想这样一种场景:差旅顾问把不同预订平台的房价截图发给视觉模型比价,模型很快给出结论,却把含早餐的不可退价格与无早餐的可免费取消价格混作同口径比较,且无法标出条款在原图中的位置;或者行政团队将长录音直接送入转写接口生成纪要,但因分段切口漂移与分发副本插播偏移,复核人员无法按文字回跳到原声位置去核对人名与日期。
这类返工源于工程流水线缺失了前置标准化与证据锚定。工业级多模态流水线应先做时间轴对齐与版面归一,再用专用索引检索,并在复核界面上让每条结论都能回跳到原帧或原截图区域。
零样本多模态表征与大规模向量索引的底层机制
视觉、语音与高维检索领域的实证研究,既提供了处理非结构化媒体的底层支撑,也划清了模型表征与工程约束的边界。
在视觉表征方面,Radford 等人(2021)指出,传统计算机视觉系统通常被训练来预测固定、预设的物体类别集合,这种受限的监督形式制约了泛化性与可用性,因为指定其他视觉概念还需补充标注数据[1]。为此,研究者利用互联网上收集的 4 亿个(图像,文本)配对数据集,通过“预测哪段文字说明与哪张图像匹配”的预训练任务,从零开始高效且可扩展地学习图像表征,并在预训练后用自然语言指代视觉概念,向各类下游任务实现零样本迁移[1]。在涵盖光学字符识别(OCR)、视频动作识别、地理定位及细粒度物体分类等超过 30 个现有计算机视觉数据集的测试中,该模型无需特定数据集训练即可与全监督基线竞争;例如在含 128 万个训练样本的经典图像分类基准上,它在零样本设置下无需使用任何训练样本,便追平了原有标准基线的准确率[1]。
在语音感知方面,Radford 等人(2023)研究了仅靠预测互联网音频海量转写稿所训练的语音处理系统[2]。当多语言与多任务弱监督规模扩展至 68 万小时音频时,所得模型在标准基准上展现出良好的泛化能力,在零样本迁移设置下无需微调即可与既有全监督结果竞争,并在准确率与鲁棒性上接近人类水平[2]。
当媒体被编码为高维特征后,海量目录中的相似性搜索便成为系统瓶颈。Johnson、Douze 与 Jégou(2021)指出,图像或视频数据库依赖专用索引结构;尽管图形处理器(GPU)擅长距离计算等数据并行任务,既有方法却受制于并行度不足的候选项选择算法或内存层级利用不佳[3]。他们提出新的候选项选择设计,用于暴力搜索、近似搜索及基于乘积量化的压缩域搜索,达到理论峰值性能 55% 的运行效率,使最近邻搜索速度达到此前 GPU 最高水平的 8.5 倍[3]。在 4 块 GPU 上,该方法可在 35 分钟内为公开数据集的 9500 万张图像构建高精度近邻图,并在不到 12 小时内构建连接 10 亿个向量的图结构[3]。
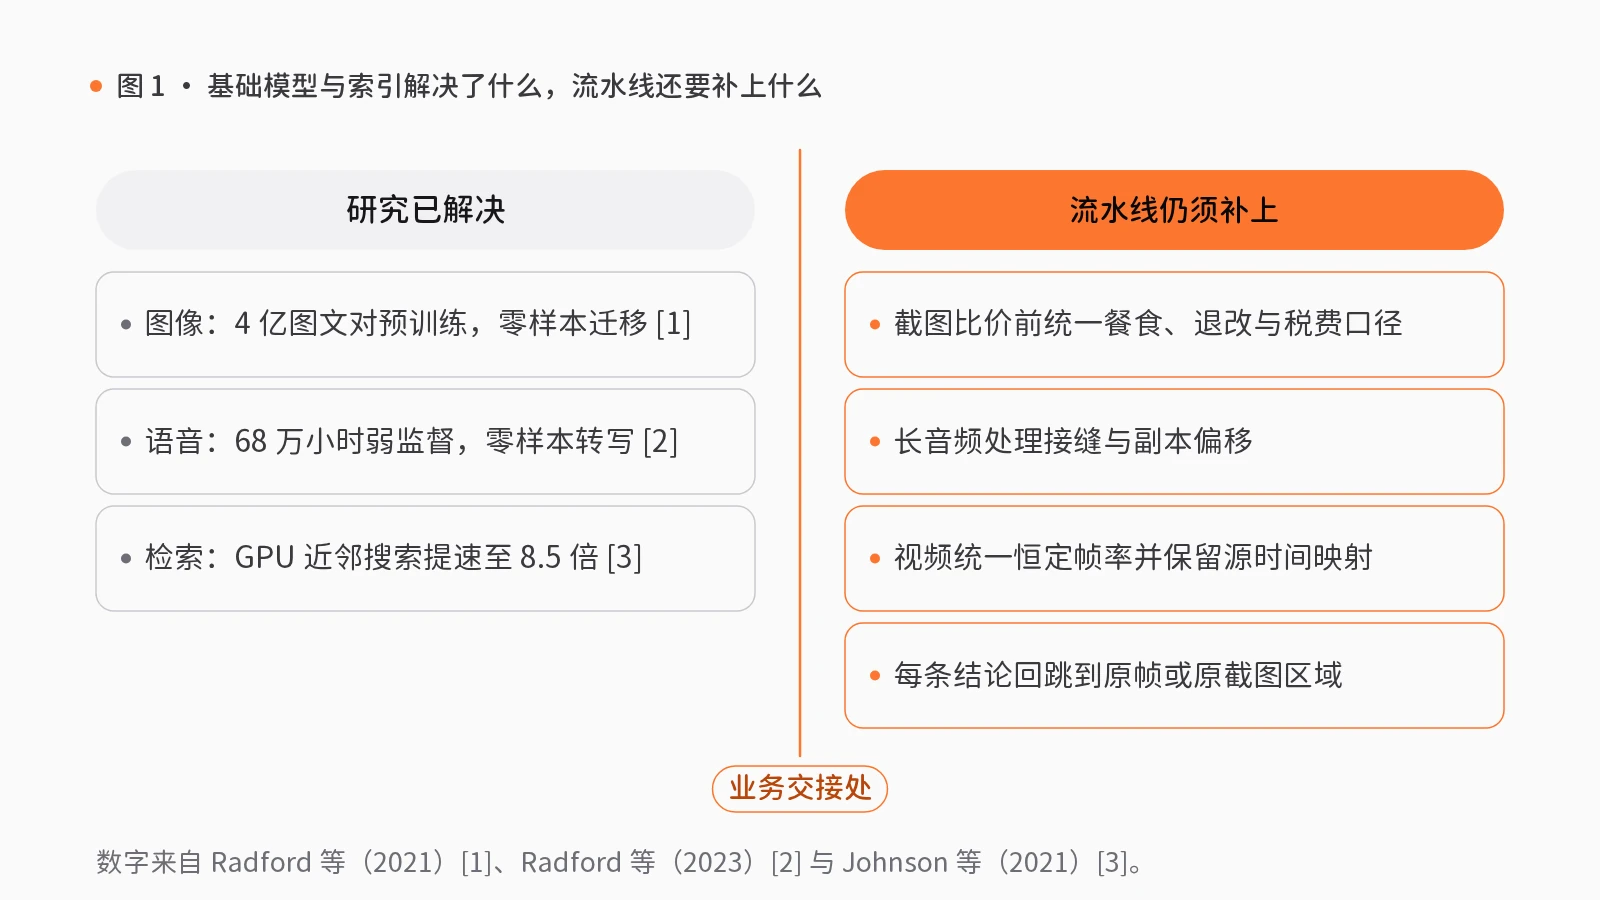
上述研究表明:大规模预训练与专用 GPU 索引解决了跨模态语义表征与高维召回的吞吐难题,但并不替业务系统定义音频切片的时间偏移、多张截图的比价口径或画面中的场地标定。跳过前置归一化与证据回跳,模型输出仍会在业务交接处因无法核验而难以落地。
时间轴对齐、版面归一与回跳复核的流水线编排
在 rlab.works 的智能感知与模型网关模块中,多模态工作流将前置对齐、专用索引与人工复核关口固化为明确契约:
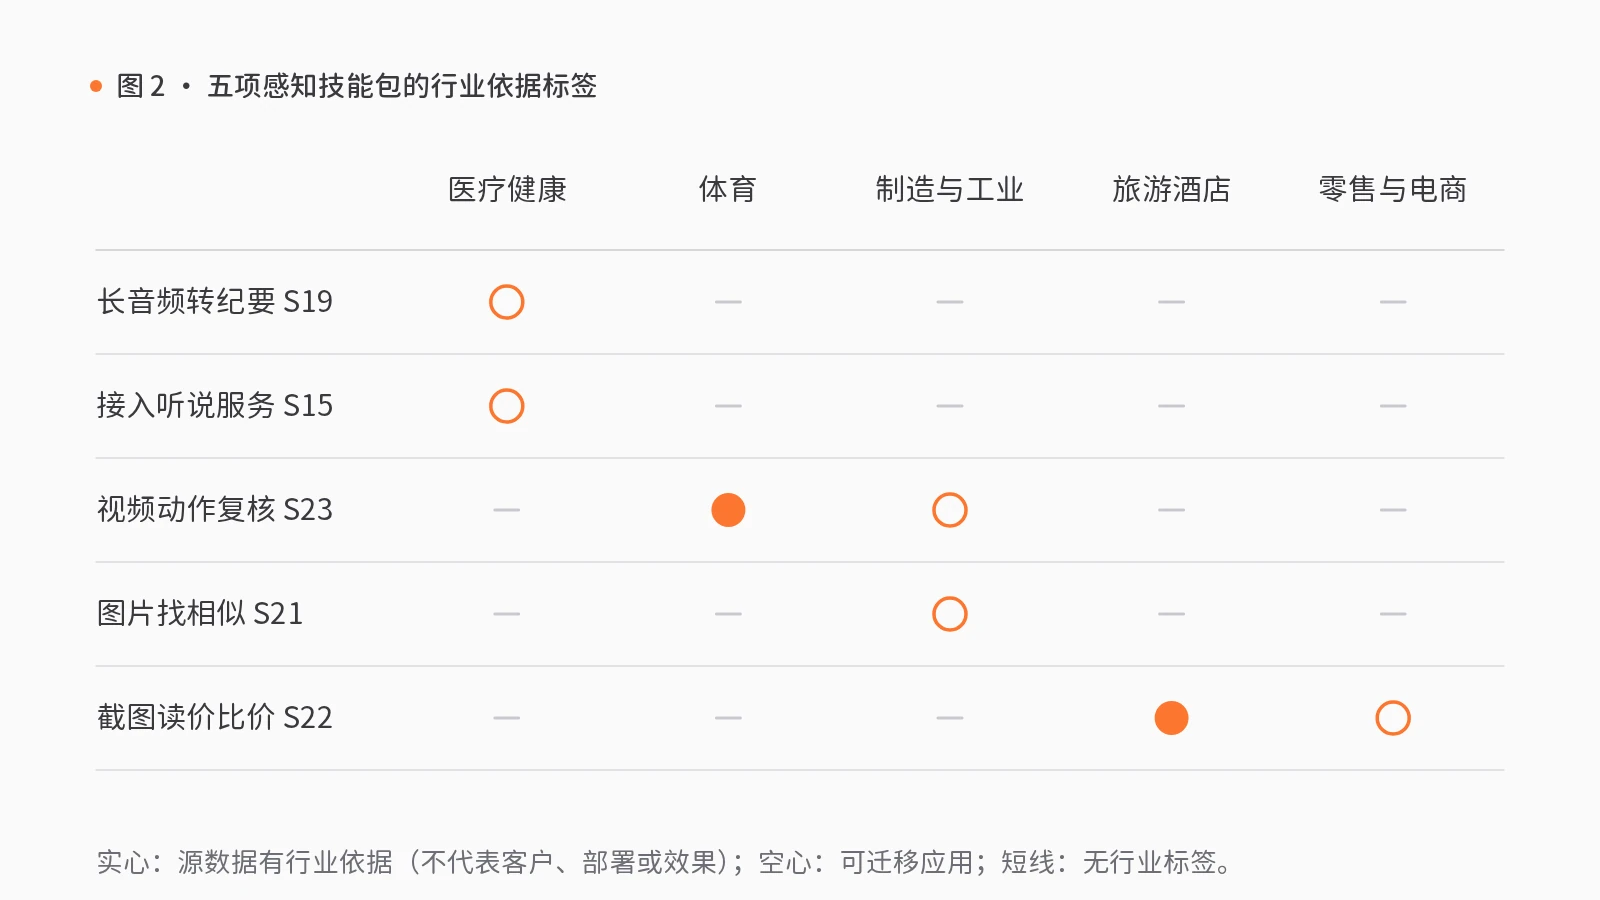
- 长音频与语音会话的时间轴对齐:技能包长录音生成纪要(S19)以授权录音、媒体信息与纪要要求为输入,先整理录音与保留规则,再由“长音频转写、重叠对齐与说话人拼接”组件切分有界任务、处理接缝并输出带位置的转写与副本偏移;随后在“核对文字与发言人”和“定稿导出”处设人工复核关口(被拒绝产出退回修订且不进入下一步),最终导出已确认纪要与原音定位。技能包“语音交互接入(S15)”以经同意的音频、语言和输出方式为输入,转写并识别意图后,须经“确认回复内容”人工复核关口确认文字,再播报回复并检查会话记录。在医疗健康领域,二者均为可迁移应用:前者把经同意录制的预约服务访谈整理成带时间位置的纪要并由行政人员核对人名和日期,只作服务记录,不用于诊断或病历自动判定,须限制保存周期与查阅权限;后者仅接入行政问答,重要日期先由工作人员核对再读给来访者,转写服务、人工确认界面和实时会话需单独编排。二者在体育、旅游酒店与制造领域均无行业标签。
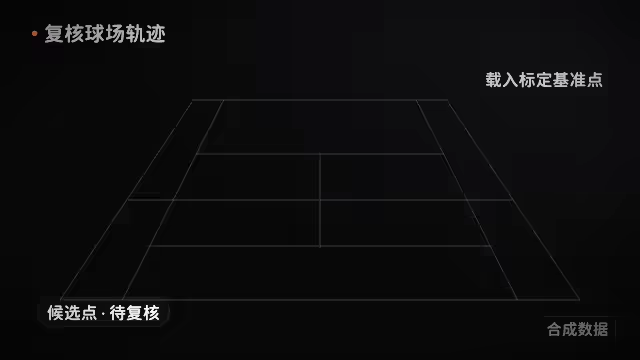
- 视频画面的帧精确归一与轨迹回放:技能包录像动作标注与复核(S23)以授权录像、场地信息与复核目标为输入,先由人工确认录像来源,再通过“媒体检查与帧精确归一化”组件统一恒定帧率与分辨率,保留源时间信息与身份标识,生成有源时间映射的工作视频。标出带时间位置的候选轨迹后,在“对照要求复核”关口由人工校正轨迹、标注与事件,再汇总统计并生成标注回放与复核包。它在体育领域为源数据有行业依据,可将比赛录像中的球迹候选交给分析员校正,现有范围限于指定球场球迹,速度读数受标定与事件条件限制;在制造与工业领域为可迁移应用,可标出工位可疑动作让班组长对照标准作业程序确认,但须重做工位标定、动作候选和工序统计,现有组件不自动识别标准作业程序或判定违规。
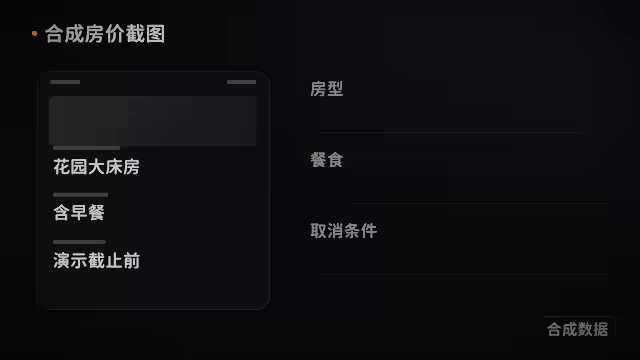
- 图像索引与截图版面口径归一:技能包以图搜索相似商品(S21)先经人工复核检查目录数据,再由“商品目录与多模态索引”组件批量生成标注了模型的图像向量并与结构化属性持久化,找出分层候选后,在“核对规格并选定”关口由人工核对规格。它在制造与工业领域为可迁移应用,可拍旧零件照片找外观候选并由维修员核对型号、尺寸和替代条件,但需物料字段和图片域适配,外观相似只供找件,不认定机械兼容或安全。技能包报价截图比价(S22)在定位原报价并读出有出处的价格与条件候选后,先统一口径,再由人工核对差异与取舍。它在旅游酒店领域为源数据有行业依据,但截图不代表当前可订库存,下单前须重新核验报价;在零售领域为可迁移应用,须替换酒店采集入口、字段识别和排序规则。
需如实说明边界:上述技能包均为拟议编排,仅基于合成数据演示,尚未接入真实服务;所提组件均为基于静态源码检查的可运行代码,而非生产部署;“源数据有行业依据”仅表示源数据有显式行业关联,不代表客户、部署或效果。
启动多模态感知试点前的管理检验
管理层在资助多模态试点前,可通过以下检验评估流水线设计:
- 是否先完成时间轴与版面口径归一? 检查长音频是否处理了接缝与副本偏移,视频是否统一了恒定帧率与源时间映射,报价截图是否在比价前统一了餐食、退改或税费口径。
- 每条结论能否回跳到原始媒体位置? 确认纪要、轨迹事件、相似候选或比价字段均保留原音时间戳、视频帧映射或截图出处,拒绝无法回查原件的黑盒输出。
- 人工关口是否具备阻断权与责任边界? 确认未通过复核的产出会退回修订,并严格执行医疗仅作服务记录、制造外观找件不作安全认定、旅游截图不代表实时库存的边界约束。
觉得有用?分享给需要的人。
参考文献
- [1]
Radford, A., Kim, J. W., Hallacy, C., Ramesh, A., Goh, G., Agarwal, S., Sastry, G., Askell, A., Mishkin, P., Clark, J., Krueger, G., & Sutskever, I. (2021). Learning Transferable Visual Models From Natural Language Supervision. Proceedings of the 38th International Conference on Machine Learning (ICML), PMLR 139, 8748–8763. arxiv.org ↗
- [2]
Radford, A., Kim, J. W., Xu, T., Brockman, G., McLeavey, C., & Sutskever, I. (2023). Robust Speech Recognition via Large-Scale Weak Supervision. Proceedings of the 40th International Conference on Machine Learning (ICML), PMLR 202, 28492–28518. arxiv.org ↗
- [3]
Johnson, J., Douze, M., & Jégou, H. (2021). Billion-Scale Similarity Search with GPUs. IEEE Transactions on Big Data, 7(3), 535–547. doi.org/10.1109/TBDATA.2019.2921572
相关能力
技能包
S19 · 智能感知
长录音生成纪要
长达数小时的会议和访谈,整理纪要还需重新回听。
分段转写并对齐时间,生成纪要草稿,每条要点均可回溯至原始录音。
- 整理录音
- 转写并对齐时间
- 核对文字与发言人人工复核
- 撰写纪要草稿
- 定稿导出人工复核
5 步2 处人工复核6 个组件
S21 · 智能感知
以图搜索相似商品
客户发来图片询问是否有货,人工逐一翻查目录,效率低且容易遗漏。
以图片或文字在商品目录中查找外形相近的候选,经人工核对规格后确定选择。
- 检查目录数据人工复核
- 建立图片索引
- 查找相似候选
- 核对规格并选定人工复核
4 步2 处人工复核3 个组件
S22 · 智能感知
报价截图比价
各方报价截图格式不一,是否含税、包含哪些权益各不相同,人工比价容易混淆口径。
从截图与链接中提取价格和条件,统一口径后比较,差异经人工核对后取舍。
- 查找报价来源
- 提取价格与条件
- 统一口径
- 比较并核对人工复核
4 步1 处人工复核7 个组件
S23 · 智能感知
录像动作标注与复核
人工逐帧查看录像寻找关键动作,耗时费力,结论也难以复查。
系统在录像中标注候选动作,由人工对照要求确认,再生成带标注的回放与可复查的复核包。
- 确认录像来源人工复核
- 对齐时间与画面
- 标注候选动作
- 对照要求复核人工复核
- 汇总确认事件
- 生成标注回放
- 移交复核包
7 步2 处人工复核8 个组件
S15 · 模型网关
语音交互接入
为系统增加语音问答,需分别对接转写、理解与合成等多项服务。
将语音转为文字并识别意图,回复内容经人工确认后以选定的声音播报,会话全程留存记录。
- 转写并识别意图
- 确认回复内容人工复核
- 播报回复
- 检查会话记录
4 步1 处人工复核4 个组件