数据谱系(Data Provenance)与目录卫生:为什么上游数据契约比下游微调更能决定系统上限
不少人工智能应用的质量问题根源在上游数据;企业应在数据进入检索或生成流水线之前,执行导入契约校验、媒体来源审核与信源变动告警,将目录卫生确立为基础工程纪律。

下游调优为何救不了失控的上游台账
设想一种常见的情形:某企业的知识检索与内容生成系统频繁给出过时报价、混淆商品参数,或在对外草稿中混入未获授权的第三方素材。团队可能先归咎于大模型推理能力不足,继而反复修改提示词、调整切片策略或微调模型权重。然而深入底层台账就会发现,真正的原因是上游供应商接口字段早已变更、旧系统迁移留下了无主记录,且未核实来源的图文视频被直接写进了索引。
当上游台账存在实体混淆、出处缺失与静默失真时,下游算法调优只会把脏数据包装得更加流畅。我们认为,不少 AI 质量问题的根源在上游数据;应在数据进入检索或生成流水线之前,执行导入契约校验、媒体来源审核与信源变动告警,以数据谱系与目录卫生决定系统的可靠性上限。
数据规格书、数据声明与内容凭证:上游治理的学术与标准演进
在工程实践中,模型架构常占据聚光灯中心,而数据资产的边界条件却缺乏标准记录。围绕如何记录并核验数据的来龙去脉,学术界与标准组织提出了互补的制度与技术方案。
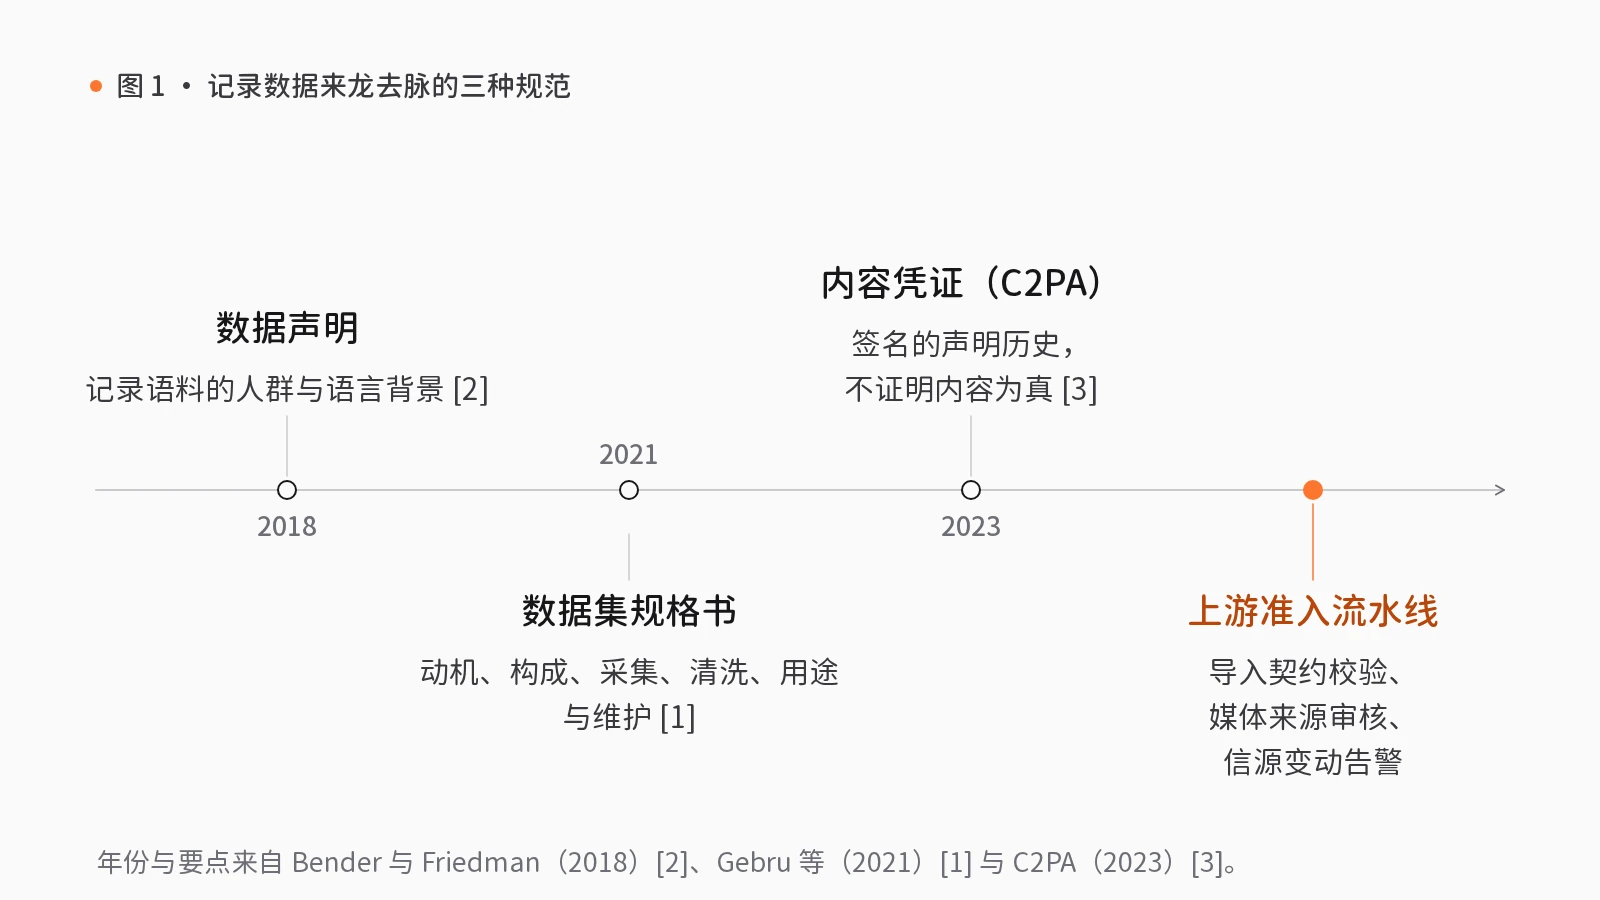
首先是通用数据集的文档化规范。Gebru 等(2021)提出,每个数据集都应附带“数据集规格书”(Datasheets for datasets)[1]。这一构想借鉴自电子工业中随硬件元器件附带的规格说明书[1]。数据集规格书要求系统记录数据集的创建动机、构成、采集过程、预处理与清洗及标注方式、建议使用场景、分发渠道与维护机制,旨在改善数据集创建者与使用者之间的沟通,并促进透明度与问责制[1]。若上游交付数据时未说明清洗规则与适用边界,下游研发就如同在未知参数的电路板上盲目接线。
其次是自然语言处理(NLP)语料的群体与背景契约。Bender 与 Friedman(2018)将“数据声明”(Data Statements)作为设计方案与职业实践引入自然语言处理的研究与开发[2]。她们指出,使用特定人群的数据去开发面向其他人群的语言技术,会引发严峻的科学与伦理问题[2]。通过将标准化数据声明纳入常规实践,研发团队能够缓解语言技术中的排斥与偏见,提高关于研究成果如何泛化的论断精度并改善工程结果,保护企业免受公开声誉受损的尴尬,最终使语言技术既能契合使用者偏好的语言风格,又不会向他人错误表征他们[2]。
最后是多模态资产的密码学溯源。内容来源与真实性联盟(C2PA,2023)制定了开放技术标准,通过将包含内容如何创建或编辑、由谁操作的声明(assertions)封装进清单(manifest),并经密码学签名与资产绑定,使消费方能够核验素材来源与编辑历史(即“内容凭证” Content Credentials)[3]。必须注意的技术边界是:C2PA 谱系展示的是经签名的“声明历史”(claimed history)与签名者身份,并不证明内容本身为真[3]。密码学签名解决的是来源与篡改检验,事实真伪仍需依赖业务规则与人工复核。
将数据谱系固化为工程流水线:目录归并、变动监看与媒体复核
将上述规范转化为企业架构,需要在模型调用前建立数据准入与状态核对流水线。在 rlab.works 的智能感知模块中,这一逻辑体现为相关技能包与底层组件的配合。
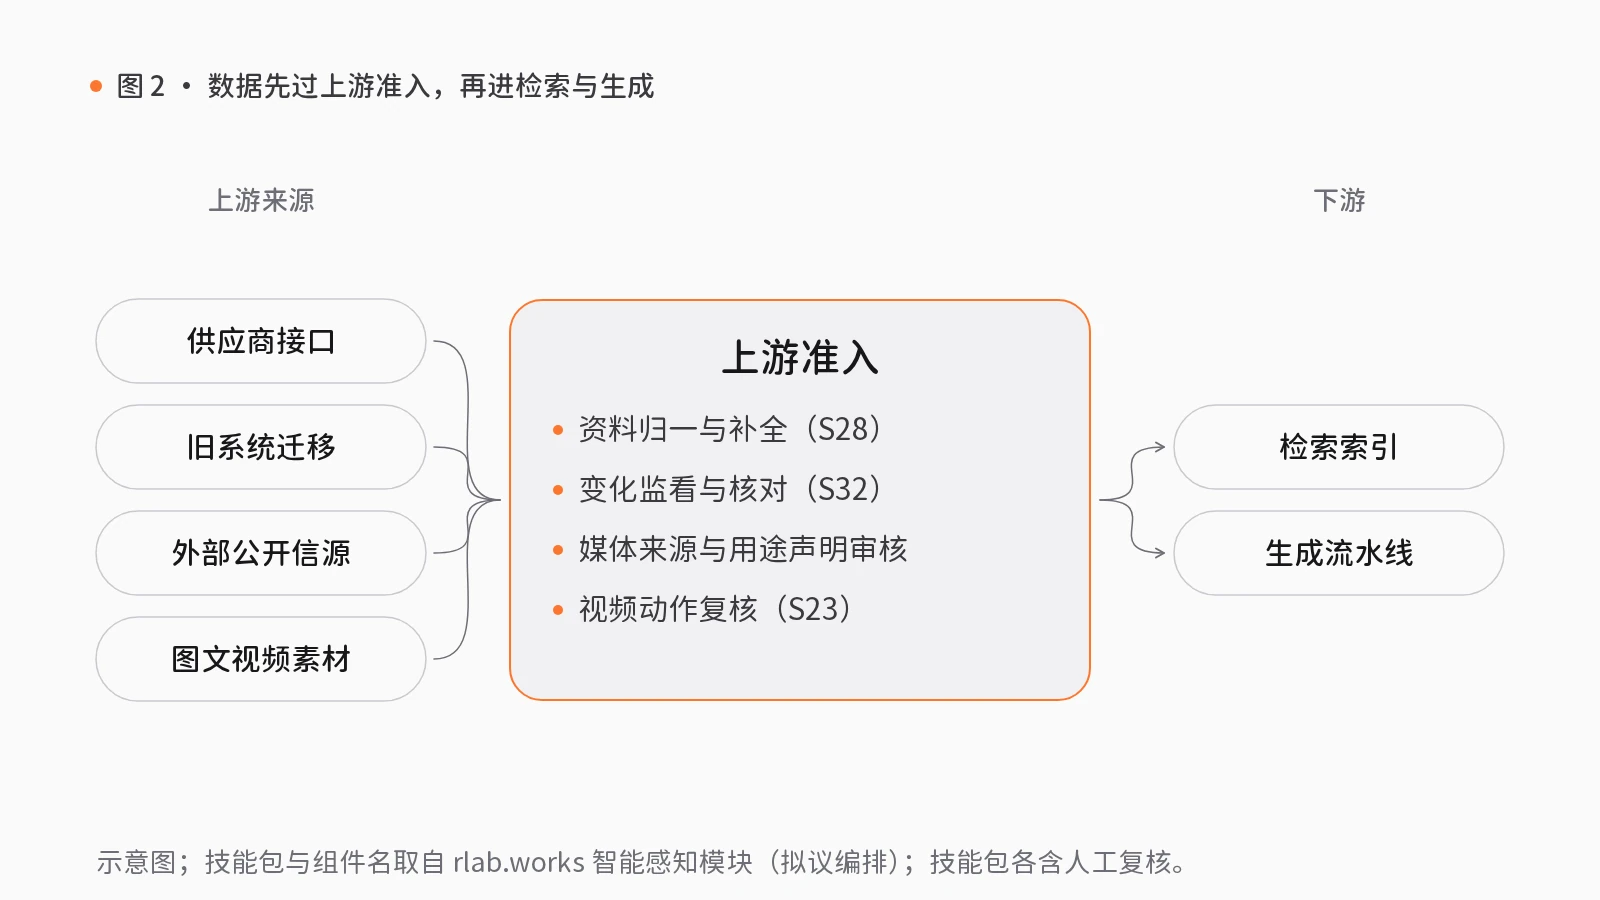
在外部信源的持续监看方面,技能包公开信息变化监测(S32)接收“许可来源、主题词与关注对象”,依次执行“登记来源并采集”(输出有来源和时间的原始信号)、“去重并比较变化”(输出变化片段与公告证据)及“整理关注线索”(输出带理由和证据的候选事项),最后经“决定跟进并归档”人工关口审核,产出人工选定事项、归档包与待办建议。接入层可配合可复用的 B2B 信号数据集注册组件,通过校验契约注册外部信号数据集并规范化公开社区数据接入。该技能包在体育与政务与公共领域为可迁移应用:体育场景可围绕赛程监看获准公开动态并整理成带证据的编辑待审事项,但需替换金融及旅行词表,且公开社交动态不能代替球队正式确认;政务与公共场景可让公开公告和居民公开反馈的变化进入待审队列供工作人员核对,但不能把发帖数量当成代表性民意,需替换源行业事件模型并保留原文和人工判断。它在旅游酒店与媒体内容领域无行业标签。
在富媒体来源审核与视频复核方面,媒体来源与用途声明审核组件将来源身份、归档证据和明确的使用范围声明绑定到素材上,阻止来源未确认或证据发生变化的素材被复用。技能包录像动作标注与复核(S23)以“授权录像、场地信息与复核目标”为输入,首步“确认录像来源”即设人工复核关口,随后执行“对齐时间与画面”与“标注候选动作”,在“对照要求复核”关口再次由人工校正轨迹,最后完成“汇总确认事件”“生成标注回放”与“移交复核包”。它在体育领域属源数据有行业依据(现有范围为指定球场球迹,速度读数受标定与事件条件限制),在制造业为可迁移应用(须重做工位标定与动作候选,不自动识别标准作业程序或判定违规),在旅游酒店、媒体内容及政务与公共领域无行业标签。
需如实说明边界:站点所有技能包均为拟议编排,仅以合成数据演示,尚未接入真实服务;上述组件虽为可运行代码,但成熟度基于静态源码检查而非生产部署;“源数据有行业依据”仅指源数据有显式行业关联,不代表客户、部署或实际业务效果。
资助 AI 试点前的上游数据卫生检验
管理层在批准检索或生成式试点前,可用以下标准检验上游数据防线:
- 导入是否有阻断式契约校验? 检查数据汇入与迁移时是否生成孤立记录与缺失报告;未载明来源、采集方式与适用边界的数据不得直接入库。
- 素材与动态是否绑定来源及用途声明? 确认多媒体素材在来源未确认或证据变更时能否被自动拦截,并在流程中严格区分“签名来源可验”与“内容事实为真”。
- 冲突消解与事实补全是否经过人工复核? 核实多源冲突、动态线索与动作轨迹是否停留在待审队列中由复核人裁决,确保未经接受的候选数据不进入下游生产环节。
觉得有用?分享给需要的人。
参考文献
- [1]
Gebru, T., Morgenstern, J., Vecchione, B., Vaughan, J. W., Wallach, H., Daumé III, H., & Crawford, K. (2021). Datasheets for datasets. Communications of the ACM, 64(12), 86–92. doi.org/10.1145/3458723
- [2]
Bender, E. M., & Friedman, B. (2018). Data Statements for Natural Language Processing: Toward Mitigating System Bias and Enabling Better Science. Transactions of the Association for Computational Linguistics (TACL), 6, 587–604. doi.org/10.1162/tacl_a_00041
- [3]
Coalition for Content Provenance and Authenticity (C2PA). (2023). C2PA Technical Specification (v1.3 / v2.0). C2PA. c2pa.org ↗
相关能力
技能包
S28 · 智能感知
多源资料合并
同一对象在多个系统中各有一份资料,名称不一、字段不全,越用越混乱。
将多方资料合并为统一目录并标明缺失项,补查到的新事实经人工确认后方可写入。
- 导入各方资料
- 合并同一对象
- 分类并标明缺口
- 补查并确认人工复核
4 步1 处人工复核10 个组件
S32 · 智能感知
公开信息变化监测
竞品、政策与公告持续变化,依靠人工定期查看网页,重要变化往往发现过晚。
持续采集有许可的公开来源,筛选出有依据的变化与相关线索,由人工决定是否跟进。
- 登记来源并采集
- 去重并比较变化
- 整理关注线索
- 决定跟进并归档人工复核
4 步1 处人工复核8 个组件
S23 · 智能感知
录像动作标注与复核
人工逐帧查看录像寻找关键动作,耗时费力,结论也难以复查。
系统在录像中标注候选动作,由人工对照要求确认,再生成带标注的回放与可复查的复核包。
- 确认录像来源人工复核
- 对齐时间与画面
- 标注候选动作
- 对照要求复核人工复核
- 汇总确认事件
- 生成标注回放
- 移交复核包
7 步2 处人工复核8 个组件