數據譜系(Data Provenance)與目錄衞生:為什麼上游數據契約比下游微調更能決定系統上限
不少人工智能應用的質素問題根源在上游數據;企業應在數據進入檢索或生成流水線之前,執行匯入契約校驗、媒體來源審核與信源變動告警,將目錄衞生確立為基礎工程紀律。

下游調優為何救不了失控的上游台賬
設想一種常見的情形:某企業的知識檢索與內容生成系統頻繁給出過時報價、混淆商品參數,或在對外草稿中混入未獲授權的第三方素材。團隊可能先歸咎於大模型推理能力不足,繼而反覆修改提示詞、調整切片策略或微調模型權重。然而深入底層台賬就會發現,真正的原因是上游供應商接口欄位早已變更、舊系統遷移留下了無主記錄,且未核實來源的圖文影片被直接寫進了索引。
當上遊台賬存在實體混淆、出處缺失與靜默失真時,下游算法調優只會把髒數據包裝得更加流暢。我們認為,不少 AI 質素問題的根源在上游數據;應在數據進入檢索或生成流水線之前,執行匯入契約校驗、媒體來源審核與信源變動告警,以數據譜系與目錄衞生決定系統的可靠性上限。
數據規格書、數據聲明與內容憑證:上游治理的學術與標準演進
在工程實踐中,模型架構常佔據聚光燈中心,而數據資產的邊界條件卻缺乏標準記錄。圍繞如何記錄並核驗數據的來龍去脈,學術界與標準組織提出了互補的制度與技術方案。
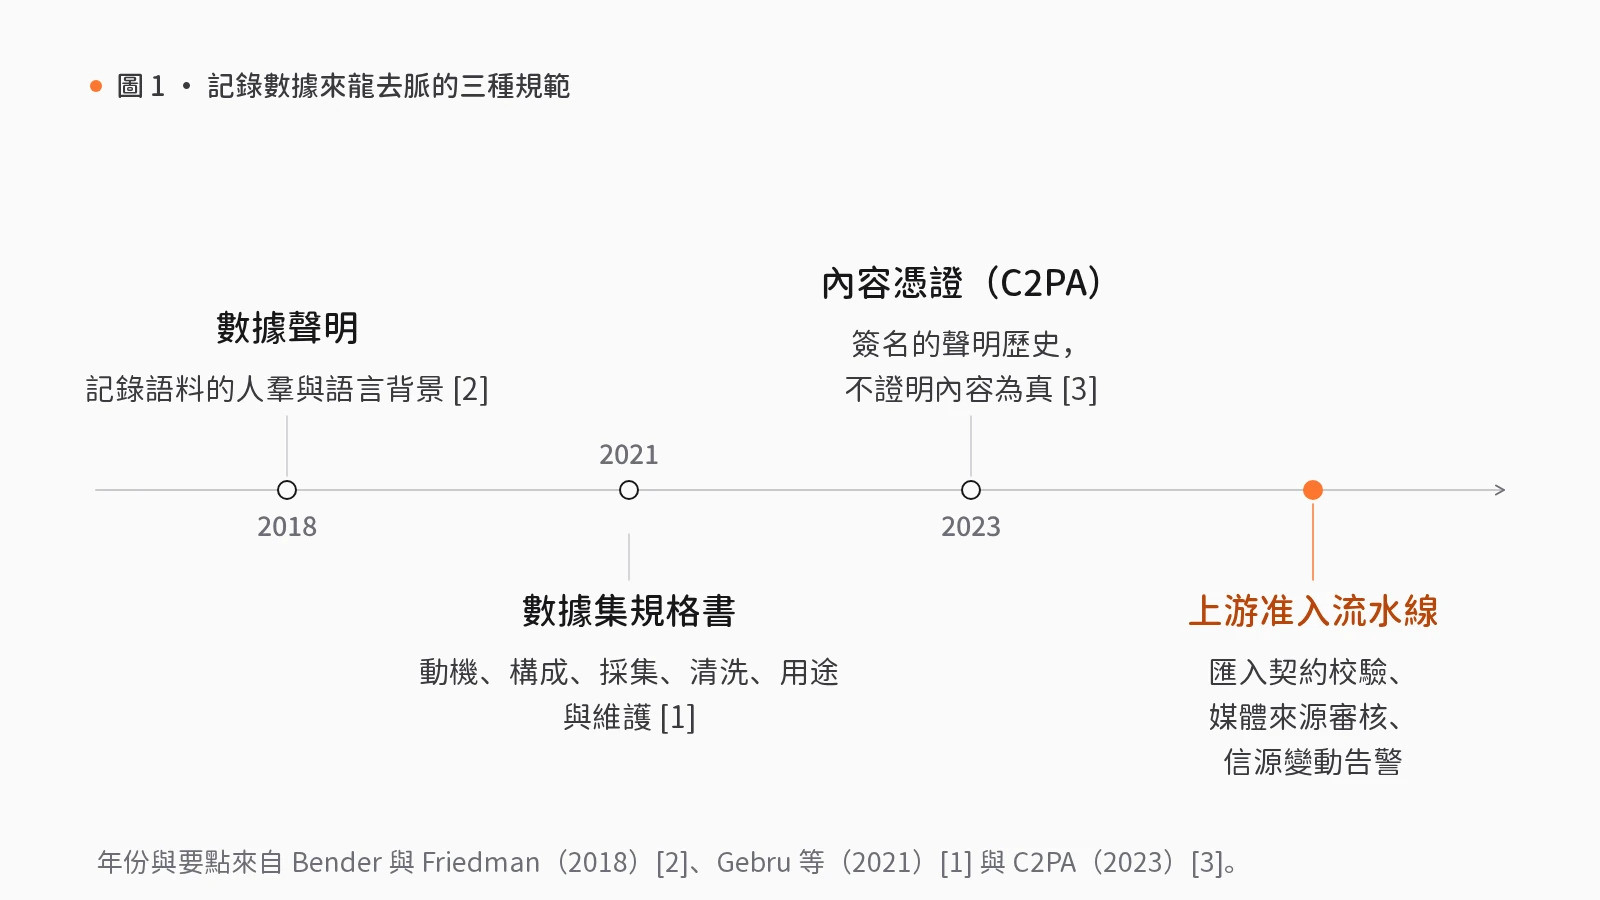
首先是通用數據集的文檔化規範。Gebru 等(2021)提出,每個數據集都應附帶「數據集規格書」(Datasheets for datasets)[1]。這一構想借鑑自電子工業中隨硬件元器件附帶的規格説明書[1]。數據集規格書要求系統記錄數據集的創建動機、構成、採集過程、預處理與清洗及標註方式、建議使用場景、分發渠道與維護機制,旨在改善數據集創建者與使用者之間的溝通,並促進透明度與問責制[1]。若上游交付數據時未説明清洗規則與適用邊界,下游研發就如同在未知參數的電路板上盲目接線。
其次是自然語言處理(NLP)語料的羣體與背景契約。Bender 與 Friedman(2018)將「數據聲明」(Data Statements)作為設計方案與職業實踐引入自然語言處理的研究與開發[2]。她們指出,使用特定人羣的數據去開發面向其他人羣的語言技術,會引發嚴峻的科學與倫理問題[2]。通過將標準化數據聲明納入常規實踐,研發團隊能夠緩解語言技術中的排斥與偏見,提高關於研究成果如何泛化的論斷精度並改善工程結果,保護企業免受公開聲譽受損的尷尬,最終使語言技術既能契合使用者偏好的語言風格,又不會向他人錯誤表徵他們[2]。
最後是多模態資產的密碼學溯源。內容來源與真實性聯盟(C2PA,2023)制定了開放技術標準,通過將包含內容如何創建或編輯、由誰操作的聲明(assertions)封裝進清單(manifest),並經密碼學簽名與資產綁定,使消費方能夠核驗素材來源與編輯歷史(即「內容憑證」 Content Credentials)[3]。必須注意的技術邊界是:C2PA 譜系展示的是經簽名的「聲明歷史」(claimed history)與簽名者身份,並不證明內容本身為真[3]。密碼學簽名解決的是來源與篡改檢驗,事實真偽仍需依賴業務規則與人工複核。
將數據譜系固化為工程流水線:目錄歸併、變動監看與媒體複核
將上述規範轉化為企業架構,需要在模型調用前建立數據准入與狀態核對流水線。在 rlab.works 的智能感知模組中,這一邏輯體現為相關技能包與底層組件的配合。
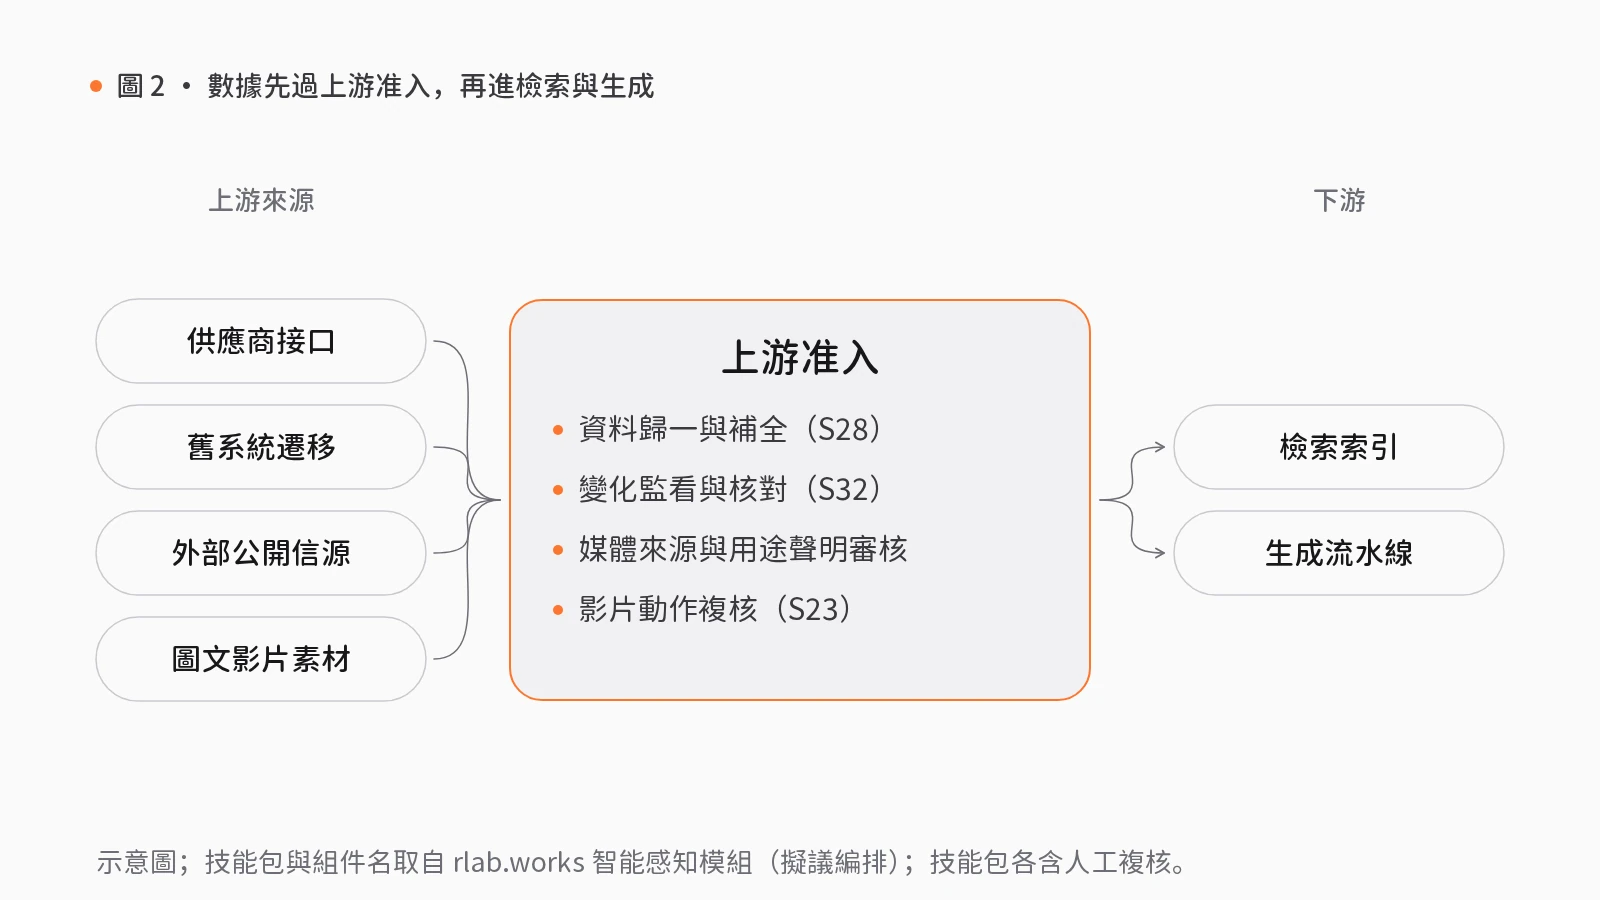
在外部信源的持續監看方面,技能包公開資訊變化監測(S32)接收「許可來源、主題詞與關注對象」,依次執行「登記來源並採集」(輸出有來源和時間的原始信號)、「去重並比較變化」(輸出變化片段與公告證據)及「整理關注線索」(輸出帶理由和證據的候選事項),最後經「決定跟進並歸檔」人工關口審核,產出人工選定事項、歸檔包與待辦建議。接入層可配合可複用的 B2B 信號數據集註冊組件,通過校驗契約註冊外部信號數據集並規範化公開社區數據接入。該技能包在體育與政務與公共領域為可遷移應用:體育場景可圍繞賽程監看獲准公開動態並整理成帶證據的編輯待審事項,但需替換金融及旅行詞表,且公開社交動態不能代替球隊正式確認;政務與公共場景可讓公開公告和居民公開反饋的變化進入待審隊列供工作人員核對,但不能把發帖數量當成代表性民意,需替換源行業事件模型並保留原文和人工判斷。它在旅遊酒店與媒體內容領域無行業標籤。
在富媒體來源審核與影片複核方面,媒體來源與用途聲明審核組件將來源身份、歸檔證據和明確的使用範圍聲明綁定到素材上,阻止來源未確認或證據發生變化的素材被複用。技能包錄像動作標註與複核(S23)以「授權錄像、場地資訊與複核目標」為輸入,首步「確認錄像來源」即設人工複核關口,隨後執行「對齊時間與畫面」與「標註候選動作」,在「對照要求複核」關口再次由人工校正軌跡,最後完成「彙總確認事件」「生成標註回放」與「移交複核包」。它在體育領域屬源數據有行業依據(現有範圍為指定球場球跡,速度讀數受標定與事件條件限制),在製造業為可遷移應用(須重做工位標定與動作候選,不自動識別標準作業程式或判定違規),在旅遊酒店、媒體內容及政務與公共領域無行業標籤。
需如實説明邊界:站點所有技能包均為擬議編排,僅以合成數據演示,尚未接入真實服務;上述組件雖為可運行代碼,但成熟度基於靜態源碼檢查而非生產部署;「源數據有行業依據」僅指源數據有顯式行業關聯,不代表客戶、部署或實際業務效果。
資助 AI 試點前的上游數據衞生檢驗
管理層在批准檢索或生成式試點前,可用以下標準檢驗上游數據防線:
- 匯入是否有阻斷式契約校驗? 檢查數據匯入與遷移時是否生成孤立記錄與缺失報告;未載明來源、採集方式與適用邊界的數據不得直接入庫。
- 素材與動態是否綁定來源及用途聲明? 確認多媒體素材在來源未確認或證據變更時能否被自動攔截,並在流程中嚴格區分「簽名來源可驗」與「內容事實為真」。
- 衝突消解與事實補全是否經過人工複核? 核實多源衝突、動態線索與動作軌跡是否停留在待審隊列中由複核人裁決,確保未經接受的候選數據不進入下游生產環節。
覺得有用?分享給需要的人。
參考文獻
- [1]
Gebru, T., Morgenstern, J., Vecchione, B., Vaughan, J. W., Wallach, H., Daumé III, H., & Crawford, K. (2021). Datasheets for datasets. Communications of the ACM, 64(12), 86–92. doi.org/10.1145/3458723
- [2]
Bender, E. M., & Friedman, B. (2018). Data Statements for Natural Language Processing: Toward Mitigating System Bias and Enabling Better Science. Transactions of the Association for Computational Linguistics (TACL), 6, 587–604. doi.org/10.1162/tacl_a_00041
- [3]
Coalition for Content Provenance and Authenticity (C2PA). (2023). C2PA Technical Specification (v1.3 / v2.0). C2PA. c2pa.org ↗
相關能力
技能包
S28 · 智能感知
多源資料合併
同一對象在多個系統中各有一份資料,名稱不一、欄位不全,越用越混亂。
將多方資料合併為統一目錄並標明缺失項,補查到的新事實經人工確認後方可寫入。
- 匯入各方資料
- 合併同一對象
- 分類並標明缺口
- 補查並確認人工複核
4 步1 處人工複核10 個組件
S32 · 智能感知
公開資訊變化監測
競品、政策與公告持續變化,依靠人工定期查看網頁,重要變化往往發現過晚。
持續採集有許可的公開來源,篩選出有依據的變化與相關線索,由人工決定是否跟進。
- 登記來源並採集
- 去重並比較變化
- 整理關注線索
- 決定跟進並歸檔人工複核
4 步1 處人工複核8 個組件
S23 · 智能感知
錄像動作標註與複核
人工逐幀查看錄像尋找關鍵動作,耗時費力,結論也難以複查。
系統在錄像中標註候選動作,由人工對照要求確認,再生成帶標註的回放與可複查的複核包。
- 確認錄像來源人工複核
- 對齊時間與畫面
- 標註候選動作
- 對照要求複核人工複核
- 彙總確認事件
- 生成標註回放
- 移交複核包
7 步2 處人工複核8 個組件