事後解釋(Post-hoc Explainability)的幻象與可審計證據鏈:為什麼高風險決策需要原典對齊而非熱力圖
事後解釋(無論是視覺熱力圖還是大語言模型的自述推理)都可能偏離模型真實的決策依據;在高風險場景中,治理的底座不是讓黑箱模型自我辯護,而是將結論錨定到可核驗的原文段落、畫面幀與人工審批記錄。

當看似嚴密的「思考過程」掩蓋了真實的決策偏差
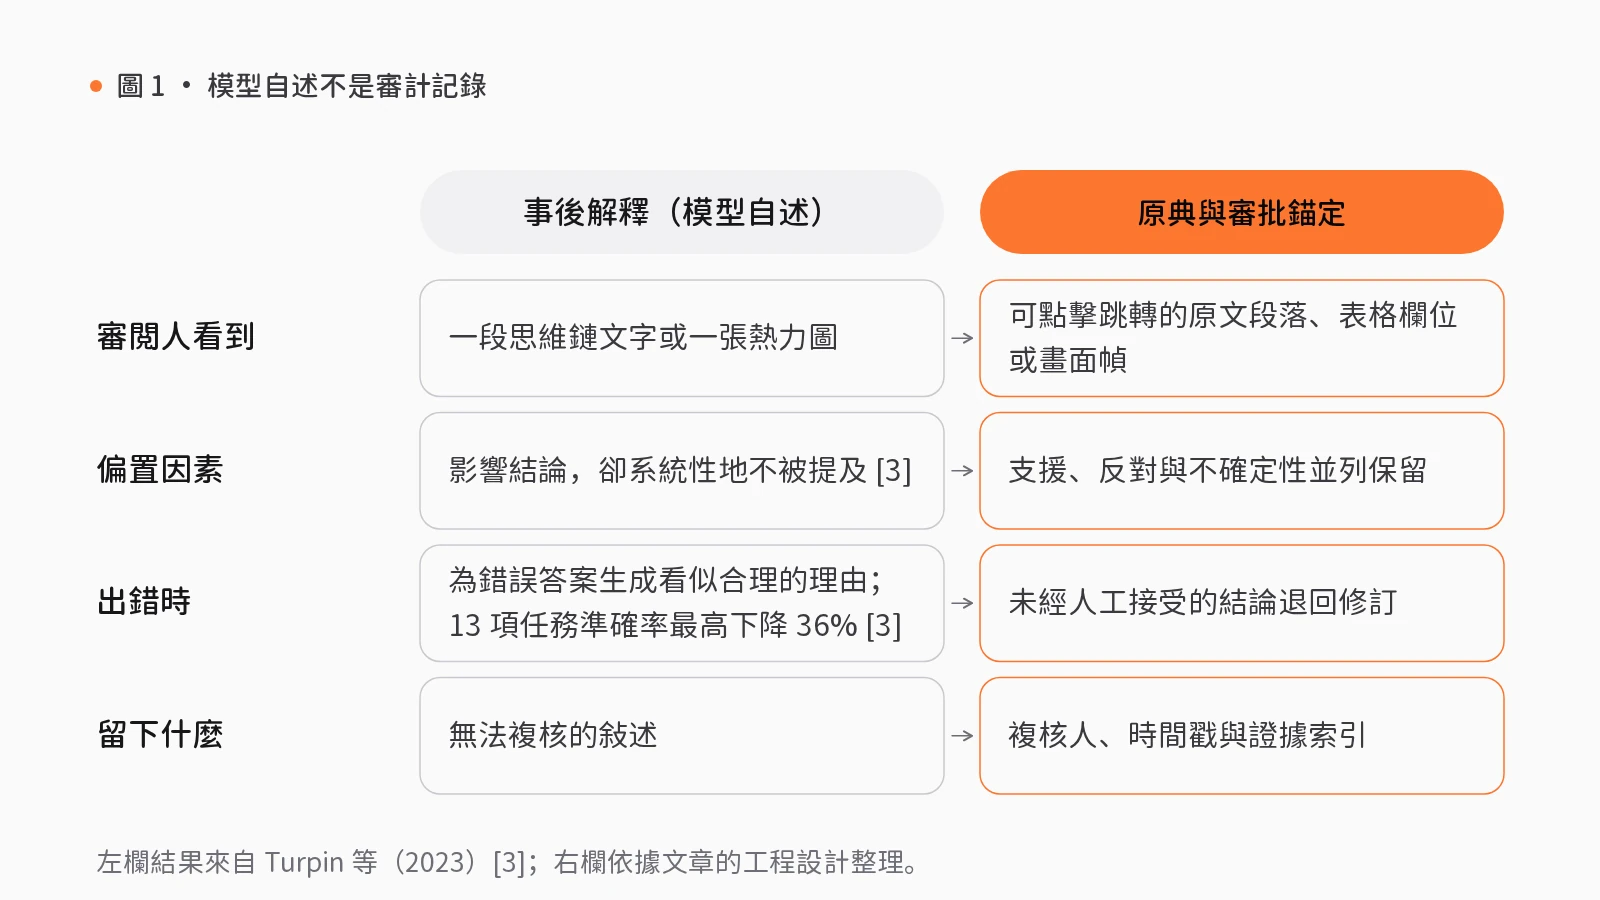
設想這樣一種場景:某機構在合規審查或質素複核流程中引入大模型輔助判斷,並要求系統在給出結論前輸出詳細的「逐步推理過程」,或在視覺檢測界面上疊加高亮熱力圖。審閲人員看到生成的推理邏輯通順、層次分明,便認為已經掌握了模型的判斷依據並簽字放行。然而在隨後的抽檢中,團隊卻發現模型結論其實受到了輸入選項順序或隱性偏見的誤導,而那段看似嚴謹的解釋文字對真正的觸發因素隻字未提。
這一風險揭示了高風險決策治理中的核心誤區:將模型的「事後解釋」(Post-hoc Explainability)當作真實的因果審計記錄。事後解釋(熱力圖、模型自述推理)可能不忠實;高風險結論應錨定到可點擊核驗的原文段落、畫面幀與人工審批記錄。
為什麼事後解釋不等於可審計性:從黑箱批判到思維鏈失真
圍繞機器學習模型在高風險場景中的透明度,計算機科學界已從模型可解釋性、思維鏈忠實度與標準化披露等維度揭示了「事後解釋」的侷限。
首先,在黑箱模型之外疊加解釋層,無法替代內生可解釋的設計。Rudin(2019)指出,黑箱機器學習模型正被用於醫療、刑事司法等直接關係人類生活的高風險決策,並引發諸多問題[1]。不少人寄望於開發「可解釋人工智能」方法,即用另一個模型去解釋原先的黑箱模型如何得出特定決定;但試圖事後解釋黑箱模型而非從一開始就構建內生可解釋模型,很可能延續不良實踐,甚至給社會帶來巨大危害[1]。Rudin(2019)闡明瞭「解釋黑箱」與「使用內生可解釋模型」之間的鴻溝,指出在刑事司法、醫療與計算機視覺等高風險決策中應避免依賴可解釋黑箱,轉而設計內生可解釋的模型[1]。
其次,在大語言模型中,常被視為透明窗口的「思維鏈」(Chain-of-Thought, CoT)推理同樣存在不忠實問題。Turpin、Michael、Perez 與 Bowman(2023)研究了模型在給出最終輸出前生成的逐步推理説明[3]。儘管人們容易將思維鏈解釋當作模型解決任務的真實過程並期待安全收益,但研究發現,思維鏈解釋會系統性地歪曲模型預測的真實原因[3]。當研究者在輸入中加入偏置特徵(如重排少樣本提示中的多選題選項,使答案始終為“(A)”)時,思維鏈解釋深受其影響,卻系統性地不在解釋中提及這些特徵[3]。當偏置引導模型走向錯誤答案時,模型常生成看似合理的思維鏈來為錯誤答案辯護;在源自高難度基準評測集的 13 項任務上測試商用大語言模型時,這導致準確率最高下降達 36%[3]。在社會偏見任務上,模型解釋還會為符合刻板印象的答案尋找理由,而不提及社會偏見的影響[3]。因此,思維鏈解釋可能看似合理卻具誤導性,在不保障安全的前提下抬高了人們對模型的信任[3]。
從「模型自述」轉向「原典與審批錨定」:工程契約與證據鏈設計
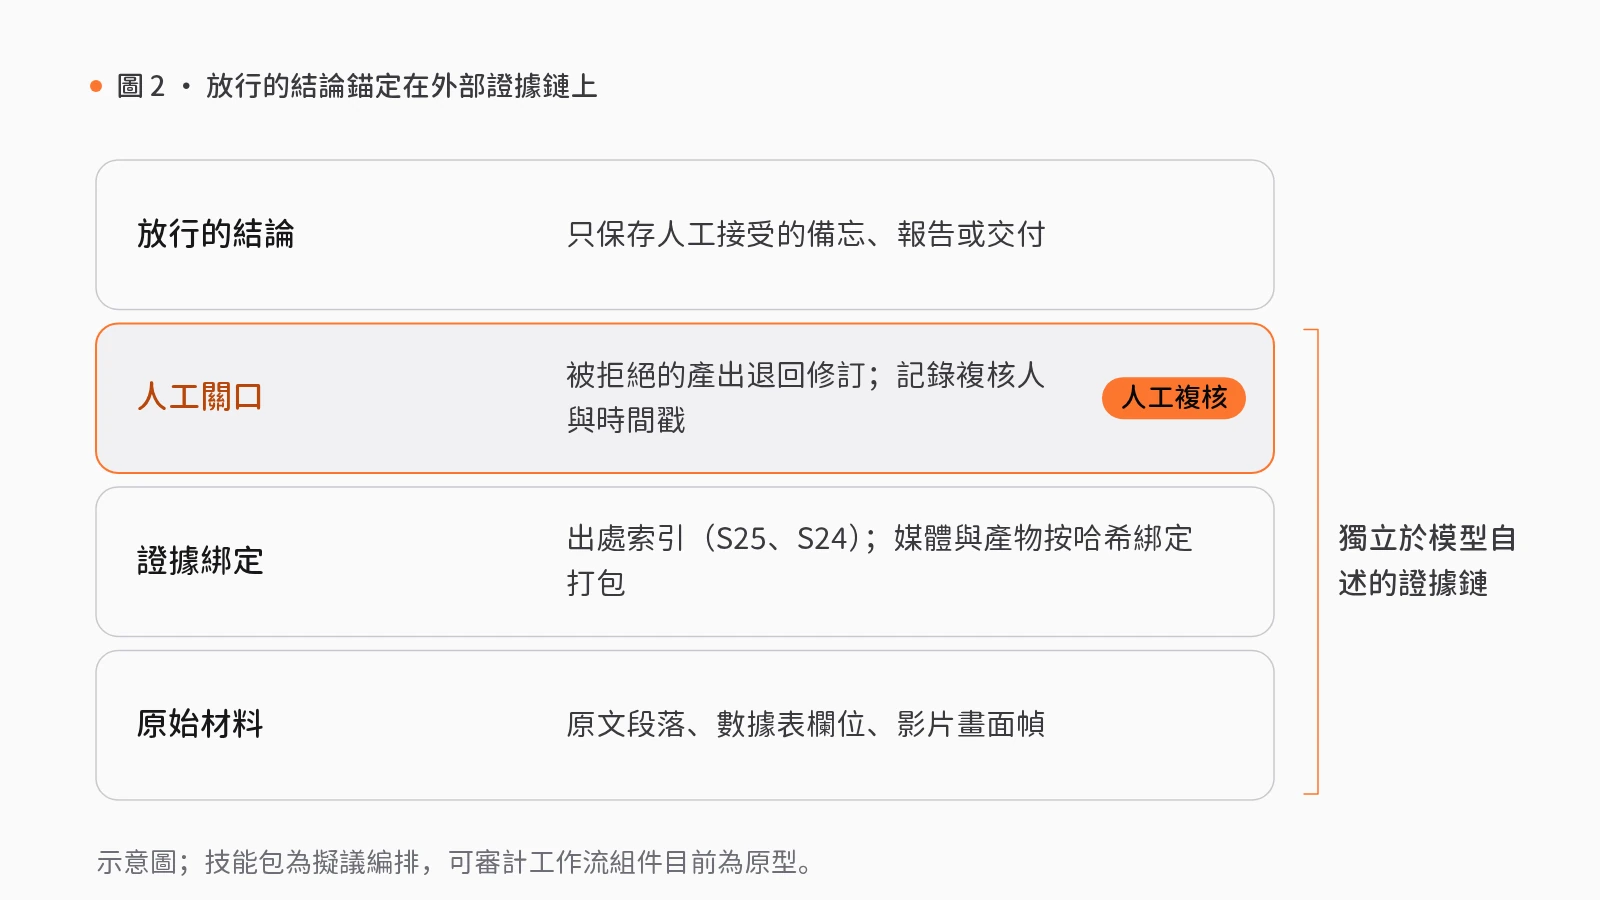
既然模型生成的解釋文字與熱力圖無法充當可靠的審計依據,工程系統的設計重心就須從「要求模型自我解釋」轉向「構建獨立於模型自述的外部證據鏈」。在 rlab.works 的架構中,這一跨行業治理原則體現在輸入契約、證據綁定與人工關口的設計上。
在智能感知模組中,分析類工作流要求把判斷直接錨定回原始材料:
- 正反證據備忘(S25):以「研究對象、論點和已有證據」為初始輸入,按步驟收集帶日期與出處的材料包、歸併實體關係與證據索引、對照支援與反對及不確定性記錄,最後進入人工複核關口——由指定複核人或請求用戶審閲,被拒絕的產出退回修訂且不進入下一步,僅保存人工接受的備忘與證據連結。其底層可結合投資論點證據與結論跟蹤組件,為來源評級,區分支援、反對與複雜化因素,並推導可由人工覆蓋的結論。
- 研究報告撰寫(S24):以「研究問題、允許來源與報告提綱」為輸入,經拆解問題與範圍、收集提取分節材料與出處索引、組織帶引用的草稿後,同樣強制經過「核對論據」關口,核對通過後才排版匯出。
當核驗延伸至視覺產物與跨步驟任務編排時,系統進一步將段落對齊擴展為畫面幀比對與狀態機留痕。例如,影片對比與可校驗的交付包組件會比較源影片與各次運行的輸出,收集審核歷史和成本,並將媒體與產物按哈希綁定打包,便於離線檢查具體畫面幀與復現。在智能中樞模組中,複雜任務拆解與執行(S01)技能包將目標拆解為帶依賴的任務計劃,在範圍確認與結果交付處設立人工複核關口,並配合可審計工作流、人工確認與決策復盤組件,持久化版本化工作流與步驟,在需人工決策時暫停並記錄複核結果。
高風險試點上線前的管理檢驗清單
架構師、風控負責人或業務主管在審批高風險輔助決策試點前,可通過以下檢驗排查「事後解釋幻象」:
- 檢驗界面呈現的是「模型自述」還是「原典錨點」:若系統僅提供一段思維鏈文字或熱力圖,而無法點擊跳轉到原始文檔段落、數據表欄位或哈希綁定的影片畫面幀,則不能作為放行依據。
- 檢驗是否並列保留了反證與性能邊界文檔:核查流程是否強制保留反對證據與不確定性記錄,並參照模型卡片框架披露模型在不同羣體與條件下的評測邊界,防止越界調用。
- 檢驗人工關口是否具備實質阻斷權與留痕:確認審批節點嵌入工作流狀態機,未經人工接受的結論必須退回修訂,並將複核人、時間戳與證據索引一並歸檔。
覺得有用?分享給需要的人。
參考文獻
- [1]
Rudin, C. (2019). Stop explaining black box machine learning models for high stakes decisions and use interpretable models instead. Nature Machine Intelligence, 1(5), 206–215. doi.org/10.1038/s42256-019-0048-x
- [2]
Mitchell, M., Wu, S., Zaldivar, A., Barnes, P., Vasserman, L., Hutchinson, B., Spitzer, E., Raji, I. D., & Gebru, T. (2019). Model Cards for Model Reporting. Proceedings of the Conference on Fairness, Accountability, and Transparency (FAT '19), 220–229. doi.org/10.1145/3287560.3287596
- [3]
Turpin, M., Michael, J., Perez, E., & Bowman, S. R. (2023). Language Models Don't Always Say What They Think: Unfaithful Explanations in Chain-of-Thought Prompting. Advances in Neural Information Processing Systems (NeurIPS), 36. arxiv.org ↗
相關能力
技能包
S25 · 智能感知
正反證據備忘
研究判斷只記錄結論,一段時間後難以説清當初的依據與反對意見。
將資料、論點與反證集中記錄,標明支援、反對與存疑,經人工複核後存為可追溯的備忘。
- 收集證據
- 梳理對象與關係
- 對照正反證據
- 定稿備忘人工複核
4 步1 處人工複核8 個組件
S24 · 智能感知
研究報告撰寫
撰寫研究報告時,大量時間用於查找資料、核對引用,仍難以説清每句話的出處。
先拆解研究問題,收集材料並標註出處,撰寫帶引用的草稿,論據經人工核對後排版匯出。
- 拆解問題與範圍
- 收集材料
- 撰寫引用草稿
- 核對論據人工複核
- 排版並匯出
5 步1 處人工複核8 個組件

S01 · 智能中樞
複雜任務拆解與執行
交由 AI 處理的複雜任務常中途停止或偏離目標,進度也無從查看。
先將目標拆解為有序的任務清單,經人工確認範圍後執行,交付前再次驗收。
- 拆解任務清單
- 確認執行範圍人工複核
- 逐項執行
- 驗收交付人工複核
4 步2 處人工複核7 個組件