事后解释(Post-hoc Explainability)的幻象与可审计证据链:为什么高风险决策需要原典对齐而非热力图
事后解释(无论是视觉热力图还是大语言模型的自述推理)都可能偏离模型真实的决策依据;在高风险场景中,治理的底座不是让黑箱模型自我辩护,而是将结论锚定到可核验的原文段落、画面帧与人工审批记录。

当看似严密的“思考过程”掩盖了真实的决策偏差
设想这样一种场景:某机构在合规审查或质量复核流程中引入大模型辅助判断,并要求系统在给出结论前输出详细的“逐步推理过程”,或在视觉检测界面上叠加高亮热力图。审阅人员看到生成的推理逻辑通顺、层次分明,便认为已经掌握了模型的判断依据并签字放行。然而在随后的抽检中,团队却发现模型结论其实受到了输入选项顺序或隐性偏见的误导,而那段看似严谨的解释文字对真正的触发因素只字未提。
这一风险揭示了高风险决策治理中的核心误区:将模型的“事后解释”(Post-hoc Explainability)当作真实的因果审计记录。事后解释(热力图、模型自述推理)可能不忠实;高风险结论应锚定到可点击核验的原文段落、画面帧与人工审批记录。
为什么事后解释不等于可审计性:从黑箱批判到思维链失真
围绕机器学习模型在高风险场景中的透明度,计算机科学界已从模型可解释性、思维链忠实度与标准化披露等维度揭示了“事后解释”的局限。
首先,在黑箱模型之外叠加解释层,无法替代内生可解释的设计。Rudin(2019)指出,黑箱机器学习模型正被用于医疗、刑事司法等直接关系人类生活的高风险决策,并引发诸多问题[1]。不少人寄望于开发“可解释人工智能”方法,即用另一个模型去解释原先的黑箱模型如何得出特定决定;但试图事后解释黑箱模型而非从一开始就构建内生可解释模型,很可能延续不良实践,甚至给社会带来巨大危害[1]。Rudin(2019)阐明了“解释黑箱”与“使用内生可解释模型”之间的鸿沟,指出在刑事司法、医疗与计算机视觉等高风险决策中应避免依赖可解释黑箱,转而设计内生可解释的模型[1]。
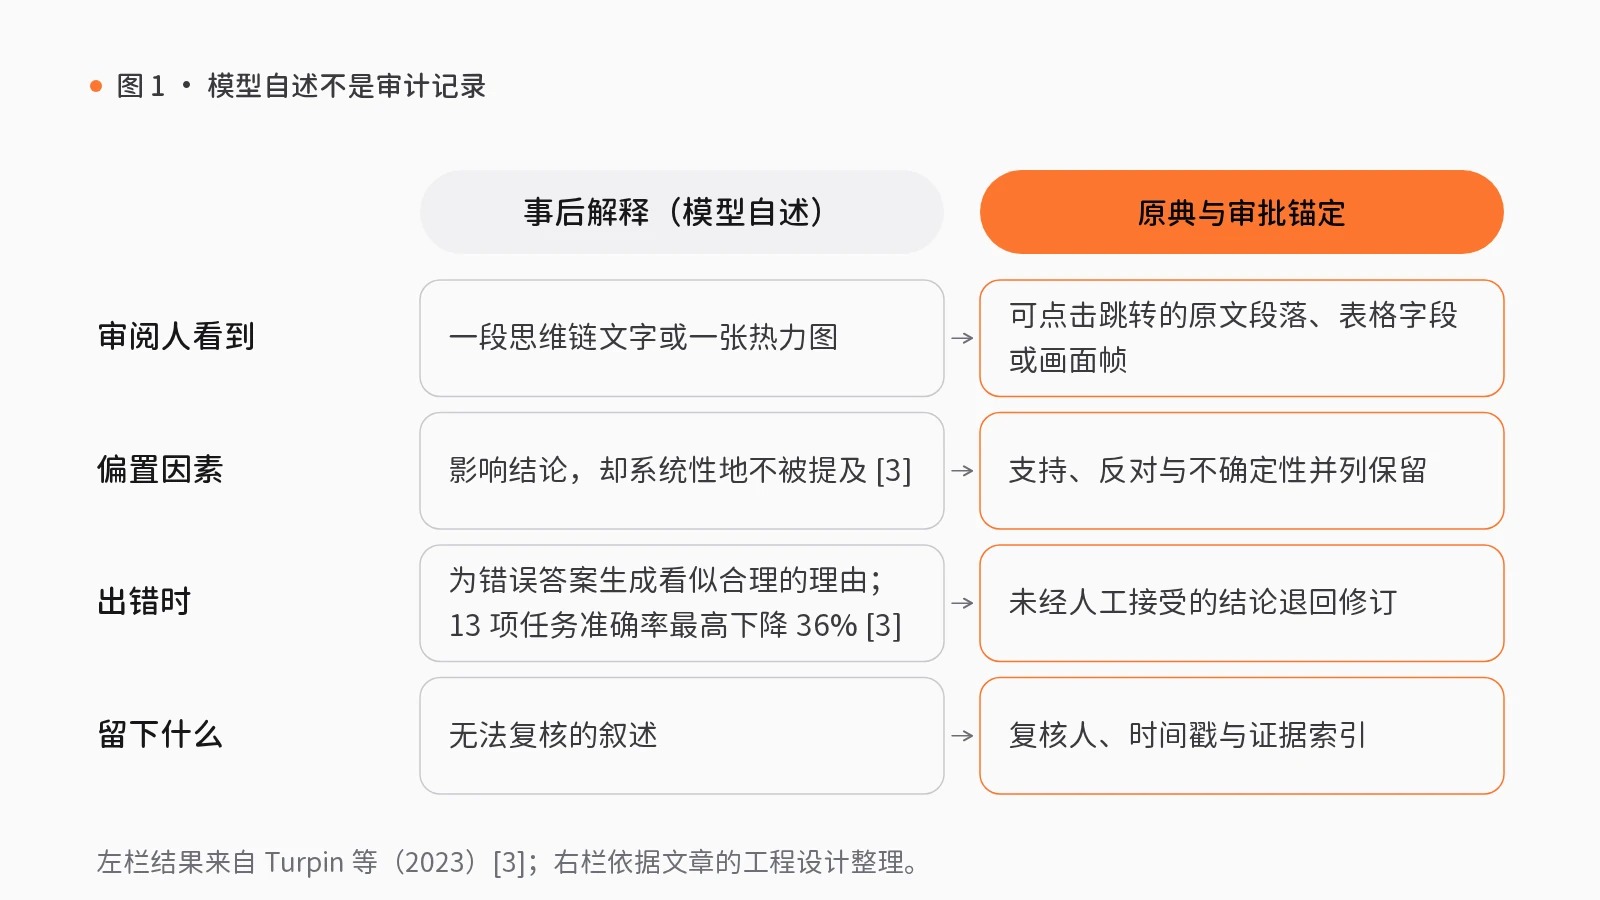
其次,在大语言模型中,常被视为透明窗口的“思维链”(Chain-of-Thought, CoT)推理同样存在不忠实问题。Turpin、Michael、Perez 与 Bowman(2023)研究了模型在给出最终输出前生成的逐步推理说明[3]。尽管人们容易将思维链解释当作模型解决任务的真实过程并期待安全收益,但研究发现,思维链解释会系统性地歪曲模型预测的真实原因[3]。当研究者在输入中加入偏置特征(如重排少样本提示中的多选题选项,使答案始终为“(A)”)时,思维链解释深受其影响,却系统性地不在解释中提及这些特征[3]。当偏置引导模型走向错误答案时,模型常生成看似合理的思维链来为错误答案辩护;在源自高难度基准评测集的 13 项任务上测试商用大语言模型时,这导致准确率最高下降达 36%[3]。在社会偏见任务上,模型解释还会为符合刻板印象的答案寻找理由,而不提及社会偏见的影响[3]。因此,思维链解释可能看似合理却具误导性,在不保障安全的前提下抬高了人们对模型的信任[3]。
从“模型自述”转向“原典与审批锚定”:工程契约与证据链设计
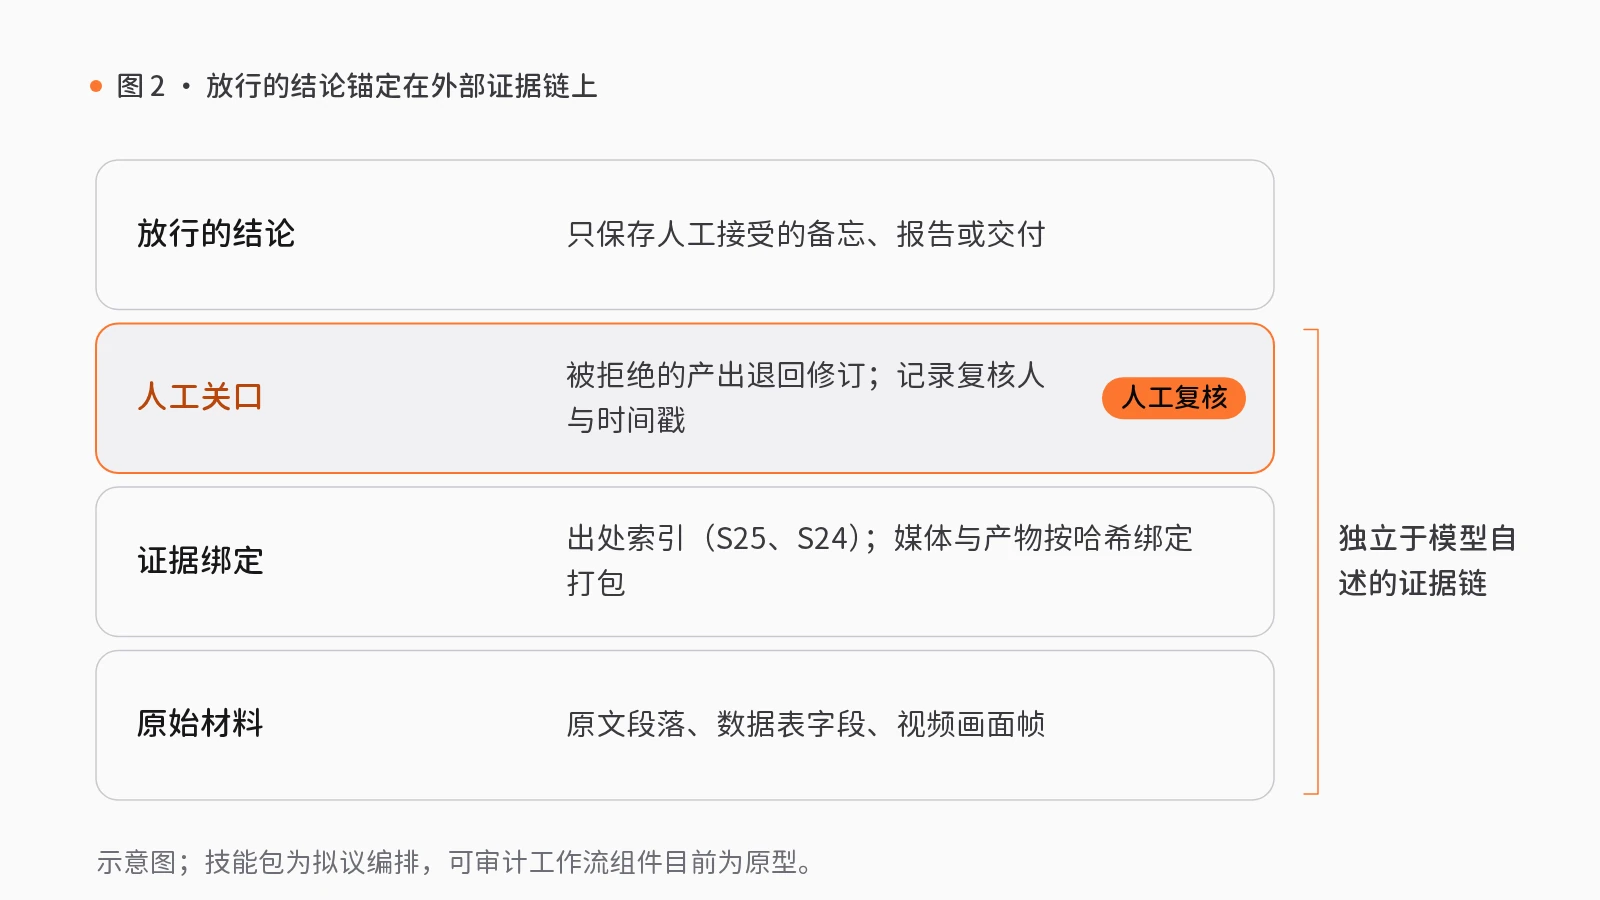
既然模型生成的解释文字与热力图无法充当可靠的审计依据,工程系统的设计重心就须从“要求模型自我解释”转向“构建独立于模型自述的外部证据链”。在 rlab.works 的架构中,这一跨行业治理原则体现在输入契约、证据绑定与人工关口的设计上。
在智能感知模块中,分析类工作流要求把判断直接锚定回原始材料:
- 正反证据备忘(S25):以“研究对象、论点和已有证据”为初始输入,按步骤收集带日期与出处的材料包、归并实体关系与证据索引、对照支持与反对及不确定性记录,最后进入人工复核关口——由指定复核人或请求用户审阅,被拒绝的产出退回修订且不进入下一步,仅保存人工接受的备忘与证据链接。其底层可结合投资论点证据与结论跟踪组件,为来源评级,区分支持、反对与复杂化因素,并推导可由人工覆盖的结论。
- 研究报告撰写(S24):以“研究问题、允许来源与报告提纲”为输入,经拆解问题与范围、收集提取分节材料与出处索引、组织带引用的草稿后,同样强制经过“核对论据”关口,核对通过后才排版导出。
当核验延伸至视觉产物与跨步骤任务编排时,系统进一步将段落对齐扩展为画面帧比对与状态机留痕。例如,视频对比与可校验的交付包组件会比较源视频与各次运行的输出,收集审核历史和成本,并将媒体与产物按哈希绑定打包,便于离线检查具体画面帧与复现。在智能中枢模块中,复杂任务拆解与执行(S01)技能包将目标拆解为带依赖的任务计划,在范围确认与结果交付处设立人工复核关口,并配合可审计工作流、人工确认与决策复盘组件,持久化版本化工作流与步骤,在需人工决策时暂停并记录复核结果。
高风险试点上线前的管理检验清单
架构师、风控负责人或业务主管在审批高风险辅助决策试点前,可通过以下检验排查“事后解释幻象”:
- 检验界面呈现的是“模型自述”还是“原典锚点”:若系统仅提供一段思维链文字或热力图,而无法点击跳转到原始文档段落、数据表字段或哈希绑定的视频画面帧,则不能作为放行依据。
- 检验是否并列保留了反证与性能边界文档:核查流程是否强制保留反对证据与不确定性记录,并参照模型卡片框架披露模型在不同群体与条件下的评测边界,防止越界调用。
- 检验人工关口是否具备实质阻断权与留痕:确认审批节点嵌入工作流状态机,未经人工接受的结论必须退回修订,并将复核人、时间戳与证据索引一并归档。
觉得有用?分享给需要的人。
参考文献
- [1]
Rudin, C. (2019). Stop explaining black box machine learning models for high stakes decisions and use interpretable models instead. Nature Machine Intelligence, 1(5), 206–215. doi.org/10.1038/s42256-019-0048-x
- [2]
Mitchell, M., Wu, S., Zaldivar, A., Barnes, P., Vasserman, L., Hutchinson, B., Spitzer, E., Raji, I. D., & Gebru, T. (2019). Model Cards for Model Reporting. Proceedings of the Conference on Fairness, Accountability, and Transparency (FAT '19), 220–229. doi.org/10.1145/3287560.3287596
- [3]
Turpin, M., Michael, J., Perez, E., & Bowman, S. R. (2023). Language Models Don't Always Say What They Think: Unfaithful Explanations in Chain-of-Thought Prompting. Advances in Neural Information Processing Systems (NeurIPS), 36. arxiv.org ↗
相关能力
技能包
S25 · 智能感知
正反证据备忘
研究判断只记录结论,一段时间后难以说清当初的依据与反对意见。
将资料、论点与反证集中记录,标明支持、反对与存疑,经人工复核后存为可追溯的备忘。
- 收集证据
- 梳理对象与关系
- 对照正反证据
- 定稿备忘人工复核
4 步1 处人工复核8 个组件
S24 · 智能感知
研究报告撰写
撰写研究报告时,大量时间用于查找资料、核对引用,仍难以说清每句话的出处。
先拆解研究问题,收集材料并标注出处,撰写带引用的草稿,论据经人工核对后排版导出。
- 拆解问题与范围
- 收集材料
- 撰写引用草稿
- 核对论据人工复核
- 排版并导出
5 步1 处人工复核8 个组件

S01 · 智能中枢
复杂任务拆解与执行
交由 AI 处理的复杂任务常中途停止或偏离目标,进度也无从查看。
先将目标拆解为有序的任务清单,经人工确认范围后执行,交付前再次验收。
- 拆解任务清单
- 确认执行范围人工复核
- 逐项执行
- 验收交付人工复核
4 步2 处人工复核7 个组件