区分“已验证能力(Proven)”与“可迁移模式(Transferable)”:跨行业复用 AI 能力的工程边界
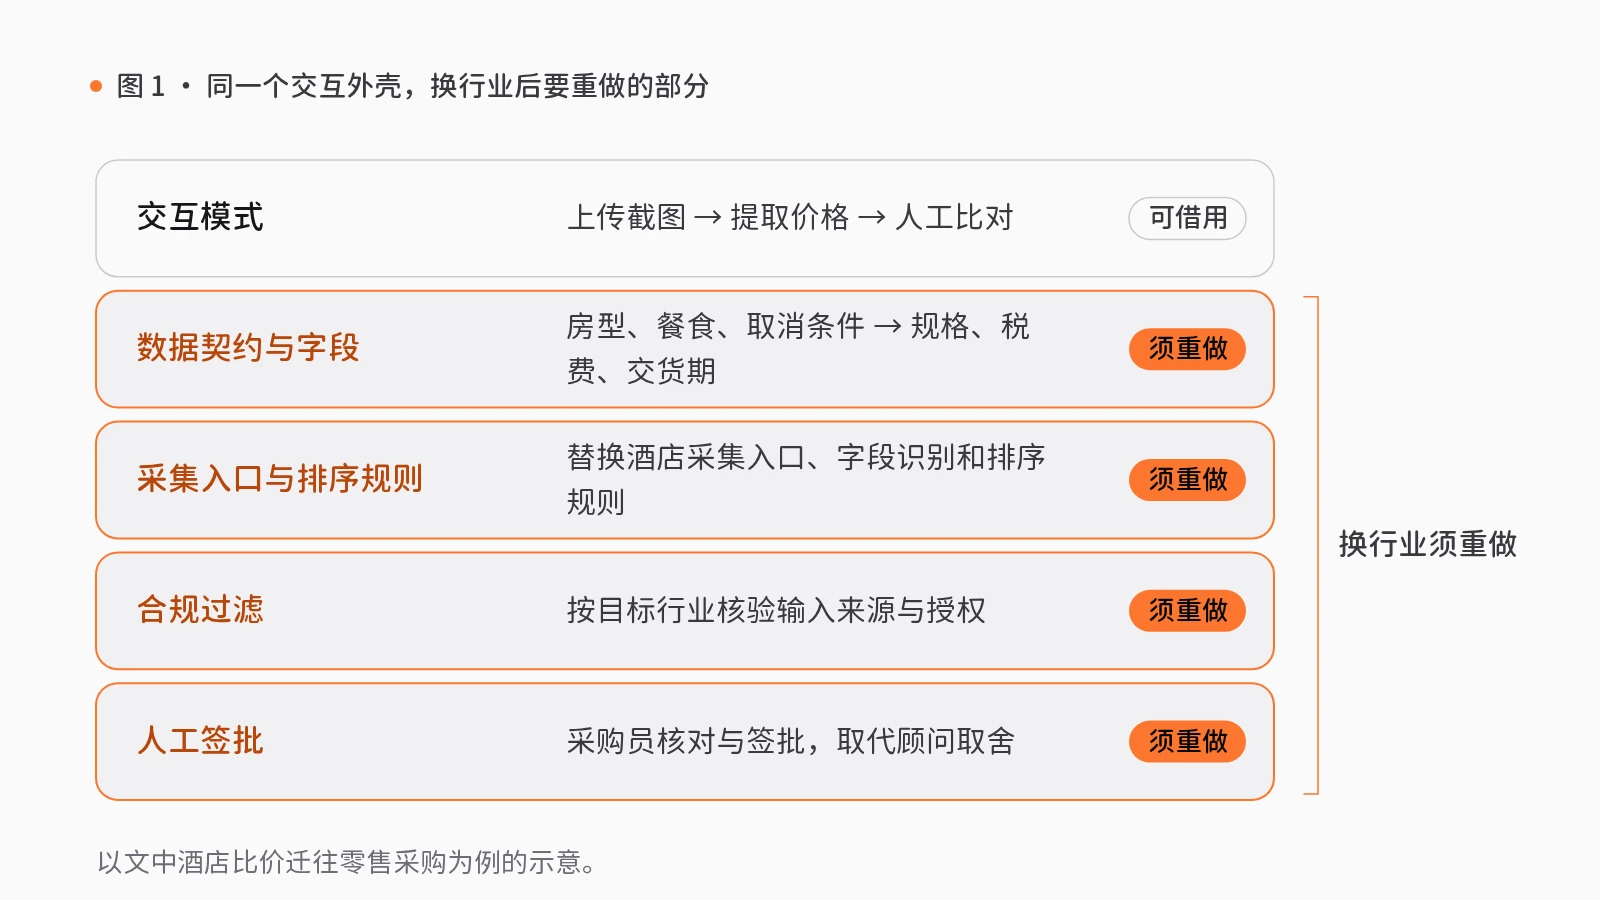
交互模式相同的能力,换一个行业后要重做数据契约、合规过滤与人工签批;能力目录应按站点依据策略区分“源数据有行业依据”与“可迁移应用”。
交互外壳看似通用,换行业后为何难以直接上线
设想这样一种情形:某零售采购团队看到一套旅游酒店的截图比价工具——上传报价截图与链接,即可提取价格并生成对比表,供顾问核对取舍。采购负责人认为“上传图片、提取价格、人工比对”的交互模式与商品询价一致,便要求直接复用。然而联调后发现,原流程围绕房型、餐食与取消条件构建字段和排序规则,无法处理商品规格、税费与交货期;采购员核对与签批边界也完全不同,系统无法直接投用。
这一困境源于将交互界面的相似性等同于工程实现的通用性。交互模式相同的能力,换一个行业后要重做数据契约、合规过滤与人工签批;能力目录应按站点依据策略区分“源数据有行业依据”与“可迁移应用”,把跨行业改造显式纳入工程规划。
特征分布偏移、外围基础设施与数据级联:跨行业迁移的机制
为何在单一领域跑通的模型与流程,跨越行业边界就会遭遇系统性摩擦?机器学习理论、系统工程与人机交互研究从数据分布、系统结构与数据实践揭示了底层机制。
首先是特征空间与数据分布的变化。Pan 与 Yang(2010)在迁移学习综述中指出,许多机器学习与数据挖掘算法依赖一项核心假设:训练数据与未来数据必须处于相同特征空间并具有相同分布[2]。但在现实应用中,这一假设往往不成立——目标领域的分类、回归或聚类任务常缺乏充足训练数据,而拥有充足训练数据的另一领域,其数据可能处于不同特征空间或服从不同数据分布[2]。成功的知识迁移虽能避免大量昂贵的数据标注并显著改善学习性能,但必须直面领域自适应、多任务学习、样本选择偏差及协变量偏移等问题[2]。
其次是外围基础设施的紧耦合。Sculley 等人(2015)借用技术债框架指出,将机器学习中的快速见效视为免费午餐是危险的,真实的机器学习系统会产生庞大的持续维护成本[1]。在真实系统中,机器学习代码只占很小一部分,绝大部分是数据采集、校验、配置、服务与监控等外围基础设施[1]。作者归纳了边界侵蚀、纠缠、隐性反馈回路、未声明的消费者、数据依赖、配置问题、外部世界变化及系统级反模式等特有风险[1]。当能力跨行业迁移时,围绕原领域构建的数据依赖、校验与配置会随外部世界变化而失效,外围基础设施必须重构。
最后是轻视数据工作引发的下游级联风险。Sambasivan 等人(2021)指出,在医疗健康、野生动物保护与贷款分配等高风险领域,数据质量因其放大的下游影响而至关重要,但数据却悖论般地成为人工智能中最被低估、最缺乏光环的环节[3]。通过对印度、东非和西非国家以及美国的 53 名人工智能从业者[3]进行访谈,作者定义并实证呈现了“数据级联”——由低估数据质量的常规实践触发、因数据问题引起负面下游影响的复合事件[3]。研究发现,数据级联普遍存在,发生率达 92%[3],具有隐蔽、滞后但往往可避免的特征,需要将卓越的数据工作设计并激励为一等公民[3]。
按站点依据策略界定边界:从酒店比价与体育视频复核看跨行业适配
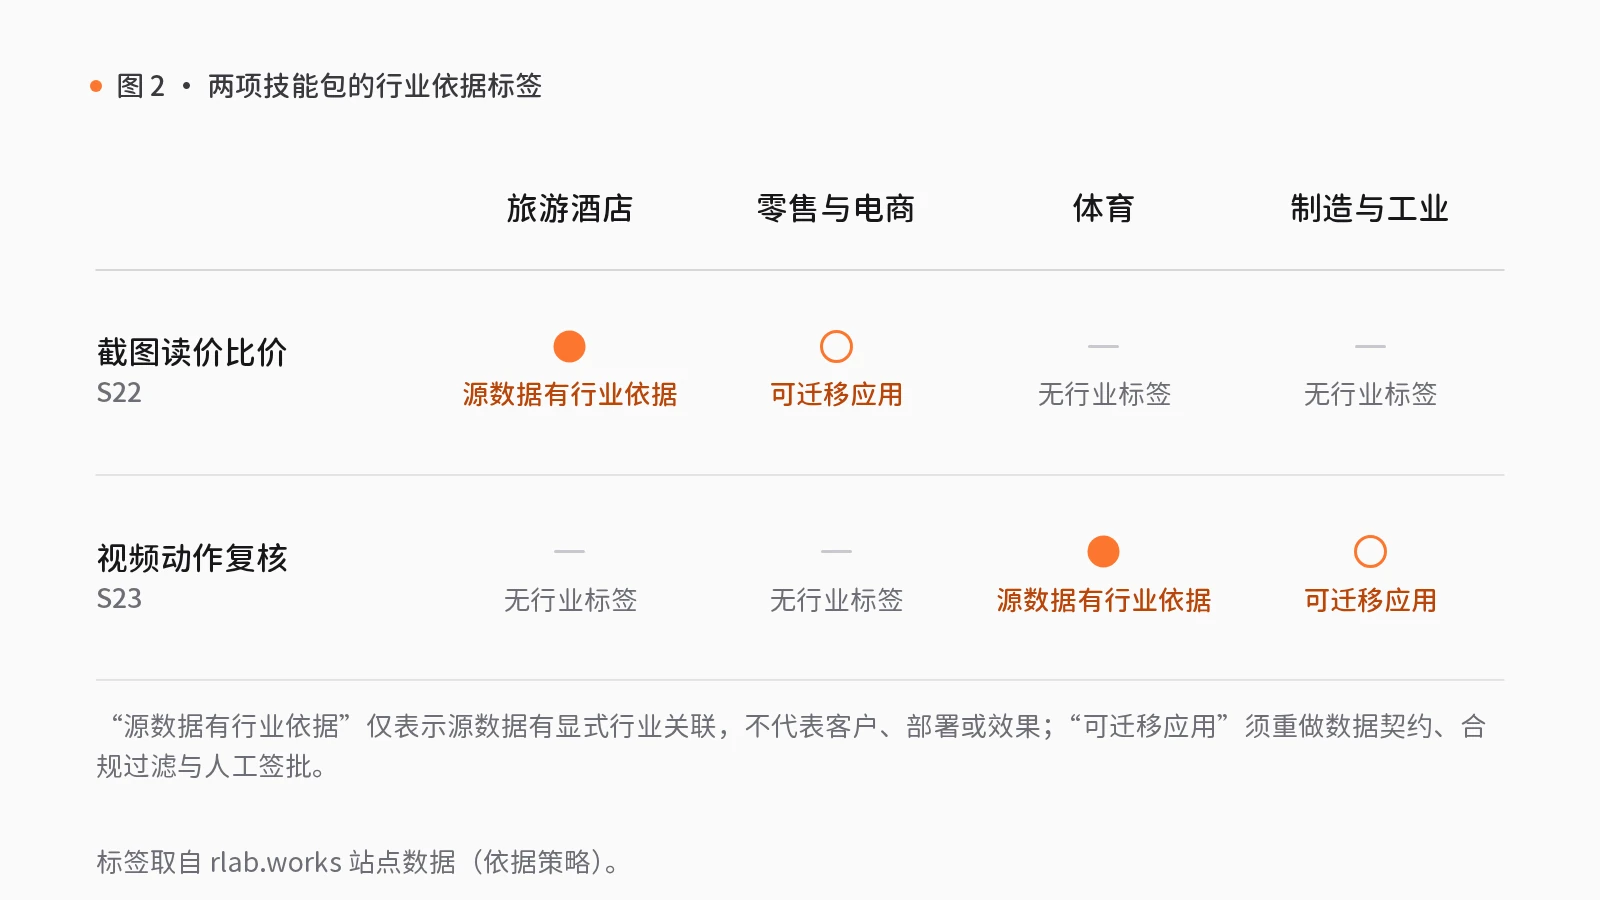
将上述机制转化为工程准则,意味着能力目录必须如实交代行业适用性。在 rlab.works 中,站点依据策略作出严格区分:**“源数据有行业依据”仅代表源文件中有显式的该行业关联,不代表客户、部署或效果;“可迁移应用”**则代表交互模式可跨行业借用,但须重做数据契约、合规过滤与人工签批。
以智能感知模块下的两项技能包为例,可清晰看到二者的工程边界。
第一项是报价截图比价(S22),从截图和链接读出价格,统一比较条件,再核对差异与取舍。它以“报价截图、链接与比较条件”为初始输入:先查找报价来源(辅助),产出报价来源与采集记录;再经多图 OTA 房价抽取等组件提取价格与条件(辅助),产出有出处的价格与条件候选;接着统一口径(辅助),生成同口径价格、权益与承诺状态;最后进入“比较并核对”人工复核关口,由指定复核人或请求用户核对,被拒绝的产出退回修订且不进入下一步,通过后输出人工核对的选项差异与待确认项。
该技能包在旅游酒店行业为“源数据有行业依据”,可从房价截图读出房型、餐食和取消条件供顾问核对取舍,但截图不代表当前可订库存,下单前须通过预订流程重新核验报价。在零售与电商行业,它为“可迁移应用”:虽能把不同供应商报价截图读成同口径表供采购员核对规格、税费和交货期,但须替换酒店采集入口、字段识别和排序规则,不能直接用房型、餐食字段比较商品。该技能包在体育及制造与工业行业无标签,至多作通用模式参考。
第二项是录像动作标注与复核(S23),保留录像来源,提出运动候选,由人校正后生成带证据的回放。它以“授权录像、场地信息与复核目标”为初始输入:先由媒体来源与用途声明审核执行“确认录像来源”人工复核,绑定来源身份、归档证据与使用范围声明,阻止未确认或证据变更的素材被复用;随后依次对齐时间与画面(辅助)、标注候选动作(辅助);接着在“对照要求复核”关口暂停,由球场标定与复核轨迹重建接收人工标注并审计修订记录,被拒绝的产出退回修订,仅人工接受的轨迹、标注与事件可继续流转;最后依次汇总确认事件(辅助)、生成标注回放(辅助)并移交复核包(辅助)。
在体育行业,该技能包为“源数据有行业依据”,所有成员均有体育源标签,可将比赛录像中的球迹候选交给分析员校正并生成标注回放,但现有范围限于指定球场球迹,速度读数受标定与事件条件限制。若迁往制造与工业行业作为“可迁移应用”——如标出工位可疑动作、让班组长对照标准作业程序确认并交接班次复核包——则须重做工位标定、动作候选和工序统计;现有组件不自动识别标准作业程序或判定违规,班次报告模板也待适配。它在旅游酒店与零售与电商行业无标签。
跨行业复用立项前的管理检验
业务负责人或首席架构师在批准跨行业复用项目前,可执行以下检验:
- 核查依据标签与行业范围:确认目标能力在该行业是“源数据有行业依据”、需改造的“可迁移应用”,还是未收录领域,切勿把源数据关联误读为已验证的客户部署效果。
- 审计数据契约与外围设施改造量:对比源行业与目标行业的采集入口、字段定义与排序口径,将特征重定义、数据校验与配置重构计入正式开发成本。
- 落实合规过滤与人工复核阻断权:明确素材授权核验规则与复核责任人,确保未经授权的输入与未获人工接受的候选输出在工作流中被强制拦截并退回。
觉得有用?分享给需要的人。
参考文献
- [1]
Sculley, D., Holt, G., Golovin, D., Davydov, E., Phillips, T., Ebner, D., Chaudhary, V., Young, M., Crespo, J.-F., & Dennison, D. (2015). Hidden Technical Debt in Machine Learning Systems. Advances in Neural Information Processing Systems (NeurIPS), 28, 2503–2511. papers.nips.cc ↗
- [2]
Pan, S. J., & Yang, Q. (2010). A Survey on Transfer Learning. IEEE Transactions on Knowledge and Data Engineering, 22(10), 1345–1359. doi.org/10.1109/TKDE.2009.191
- [3]
Sambasivan, N., Kapania, S., Highfill, H., Akrong, D., Paritosh, P., & Aroyo, L. M. (2021). "Everyone wants to do the model work, not the data work": Data Cascades in High-Stakes AI. Proceedings of the 2021 CHI Conference on Human Factors in Computing Systems, Article 39. doi.org/10.1145/3411764.3445518