區分「已驗證能力(Proven)」與「可遷移模式(Transferable)」:跨行業複用 AI 能力的工程邊界
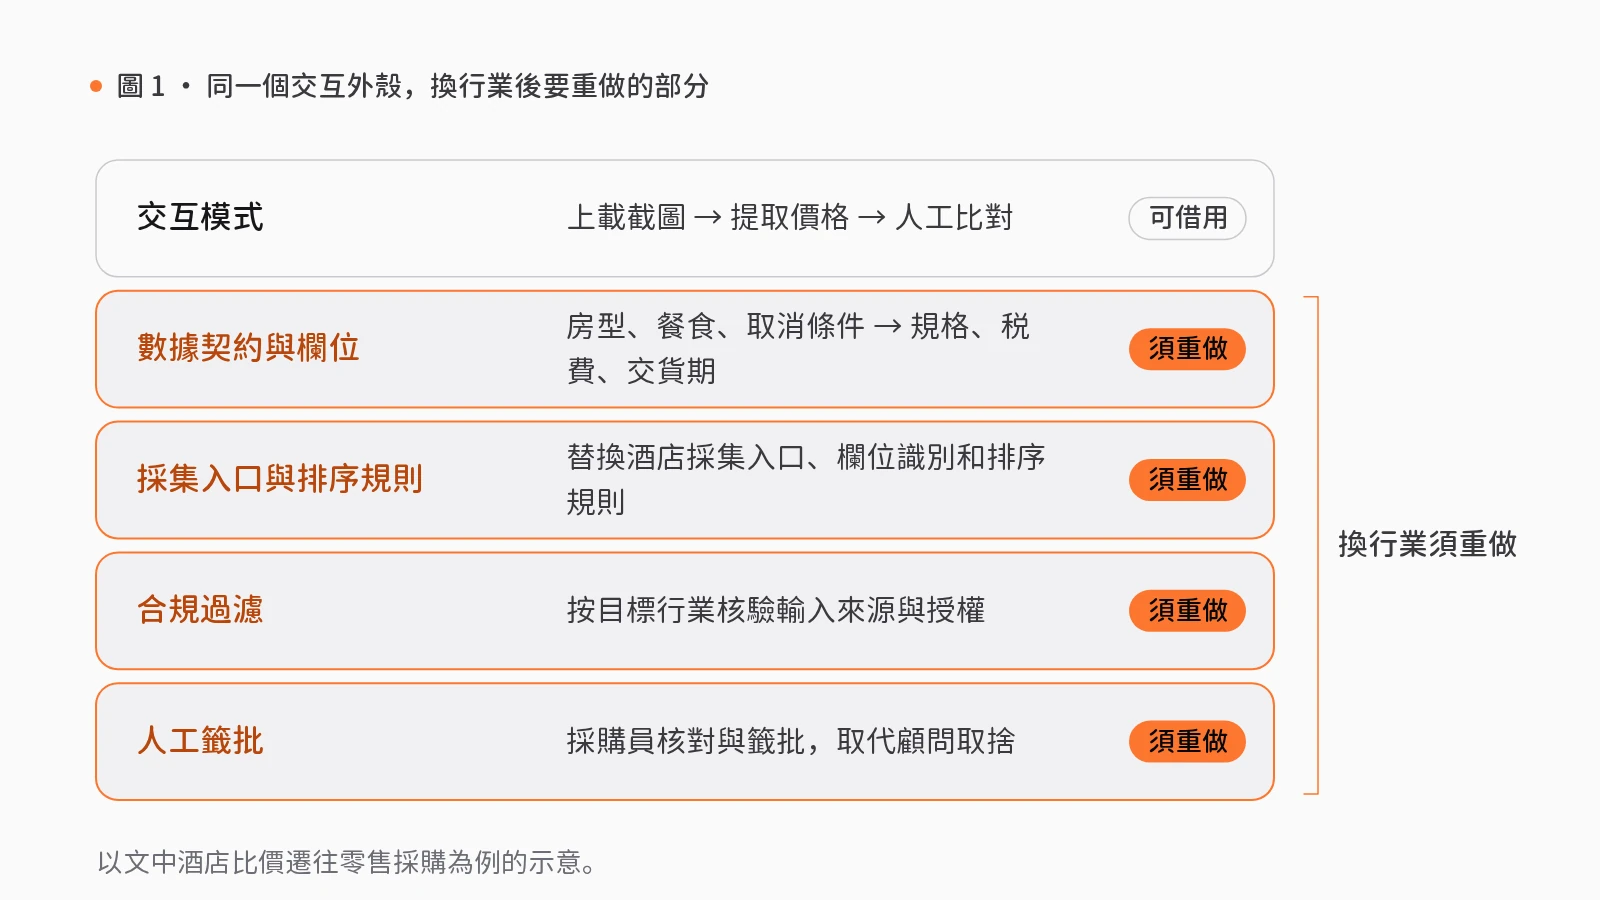
交互模式相同的能力,換一個行業後要重做數據契約、合規過濾與人工籤批;能力目錄應按站點依據策略區分「源數據有行業依據」與「可遷移應用」。
交互外殼看似通用,換行業後為何難以直接上線
設想這樣一種情形:某零售採購團隊看到一套旅遊酒店的截圖比價工具——上載報價截圖與連結,即可提取價格並生成對比表,供顧問核對取捨。採購負責人認為「上載圖片、提取價格、人工比對」的交互模式與商品詢價一致,便要求直接複用。然而聯調後發現,原流程圍繞房型、餐食與取消條件構建欄位和排序規則,無法處理商品規格、税費與交貨期;採購員核對與籤批邊界也完全不同,系統無法直接投用。
這一困境源於將交互界面的相似性等同於工程實現的通用性。交互模式相同的能力,換一個行業後要重做數據契約、合規過濾與人工籤批;能力目錄應按站點依據策略區分「源數據有行業依據」與「可遷移應用」,把跨行業改造顯式納入工程規劃。
特徵分佈偏移、外圍基礎設施與數據級聯:跨行業遷移的機制
為何在單一領域跑通的模型與流程,跨越行業邊界就會遭遇系統性摩擦?機器學習理論、系統工程與人機交互研究從數據分佈、系統結構與數據實踐揭示了底層機制。
首先是特徵空間與數據分佈的變化。Pan 與 Yang(2010)在遷移學習綜述中指出,許多機器學習與數據挖掘算法依賴一項核心假設:訓練數據與未來數據必須處於相同特徵空間並具有相同分佈[2]。但在現實應用中,這一假設往往不成立——目標領域的分類、迴歸或聚類任務常缺乏充足訓練數據,而擁有充足訓練數據的另一領域,其數據可能處於不同特徵空間或服從不同數據分佈[2]。成功的知識遷移雖能避免大量昂貴的數據標註並顯著改善學習性能,但必須直面領域自適應、多任務學習、樣本選擇偏差及協變量偏移等問題[2]。
其次是外圍基礎設施的緊耦合。Sculley 等人(2015)借用技術債框架指出,將機器學習中的快速見效視為免費午餐是危險的,真實的機器學習系統會產生龐大的持續維護成本[1]。在真實系統中,機器學習代碼只佔很小一部分,絕大部分是數據採集、校驗、配置、服務與監控等外圍基礎設施[1]。作者歸納了邊界侵蝕、糾纏、隱性反饋迴路、未聲明的消費者、數據依賴、配置問題、外部世界變化及系統級反模式等特有風險[1]。當能力跨行業遷移時,圍繞原領域構建的數據依賴、校驗與配置會隨外部世界變化而失效,外圍基礎設施必須重構。
最後是輕視數據工作引發的下游級聯風險。Sambasivan 等人(2021)指出,在醫療健康、野生動物保護與貸款分配等高風險領域,數據質素因其放大的下游影響而至關重要,但數據卻悖論般地成為人工智能中最被低估、最缺乏光環的環節[3]。通過對印度、東非和西非國家以及美國的 53 名人工智能從業者[3]進行訪談,作者定義並實證呈現了「數據級聯」——由低估數據質素的常規實踐觸發、因數據問題引起負面下游影響的複合事件[3]。研究發現,數據級聯普遍存在,發生率達 92%[3],具有隱蔽、滯後但往往可避免的特徵,需要將卓越的數據工作設計並激勵為一等公民[3]。
按站點依據策略界定邊界:從酒店比價與體育影片複核看跨行業適配
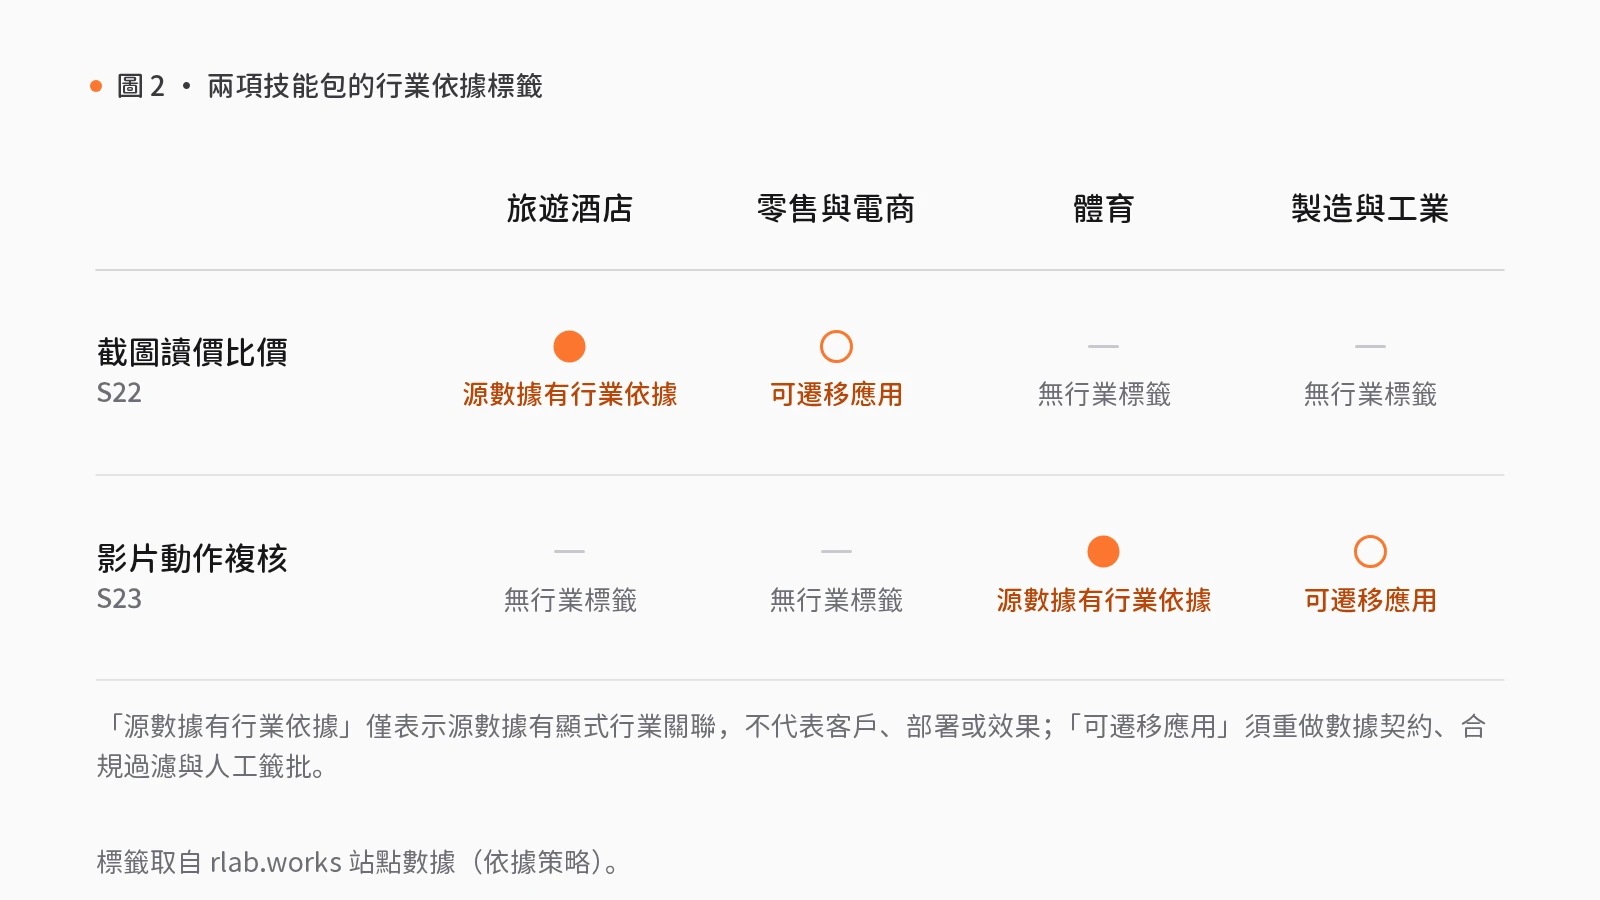
將上述機制轉化為工程準則,意味着能力目錄必須如實交代行業適用性。在 rlab.works 中,站點依據策略作出嚴格區分:**「源數據有行業依據」僅代表源文件中有顯式的該行業關聯,不代表客戶、部署或效果;「可遷移應用」**則代表交互模式可跨行業借用,但須重做數據契約、合規過濾與人工籤批。
以智能感知模組下的兩項技能包為例,可清晰看到二者的工程邊界。
第一項是報價截圖比價(S22),從截圖和連結讀出價格,統一比較條件,再核對差異與取捨。它以「報價截圖、連結與比較條件」為初始輸入:先查找報價來源(輔助),產出報價來源與採集記錄;再經多圖 OTA 房價抽取等組件提取價格與條件(輔助),產出有出處的價格與條件候選;接着統一口徑(輔助),生成同口徑價格、權益與承諾狀態;最後進入「比較並核對」人工複核關口,由指定複核人或請求用戶核對,被拒絕的產出退回修訂且不進入下一步,通過後輸出人工核對的選項差異與待確認項。
該技能包在旅遊酒店行業為「源數據有行業依據」,可從房價截圖讀出房型、餐食和取消條件供顧問核對取捨,但截圖不代表當前可訂庫存,下單前須通過預訂流程重新核驗報價。在零售與電商行業,它為「可遷移應用」:雖能把不同供應商報價截圖讀成同口徑表供採購員核對規格、税費和交貨期,但須替換酒店採集入口、欄位識別和排序規則,不能直接用房型、餐食欄位比較商品。該技能包在體育及製造與工業行業無標籤,至多作通用模式參考。
第二項是錄像動作標註與複核(S23),保留錄像來源,提出運動候選,由人校正後生成帶證據的回放。它以「授權錄像、場地資訊與複核目標」為初始輸入:先由媒體來源與用途聲明審核執行「確認錄像來源」人工複核,綁定來源身份、歸檔證據與使用範圍聲明,阻止未確認或證據變更的素材被複用;隨後依次對齊時間與畫面(輔助)、標註候選動作(輔助);接着在「對照要求複核」關口暫停,由球場標定與複核軌跡重建接收人工標註並審計修訂記錄,被拒絕的產出退回修訂,僅人工接受的軌跡、標註與事件可繼續流轉;最後依次彙總確認事件(輔助)、生成標註回放(輔助)並移交複核包(輔助)。
在體育行業,該技能包為「源數據有行業依據」,所有成員均有體育源標籤,可將比賽錄像中的球跡候選交給分析員校正並生成標註回放,但現有範圍限於指定球場球跡,速度讀數受標定與事件條件限制。若遷往製造與工業行業作為「可遷移應用」——如標出工位可疑動作、讓班組長對照標準作業程式確認並交接班次複核包——則須重做工位標定、動作候選和工序統計;現有組件不自動識別標準作業程式或判定違規,班次報告模板也待適配。它在旅遊酒店與零售與電商行業無標籤。
跨行業複用立項前的管理檢驗
業務負責人或首席架構師在批准跨行業複用項目前,可執行以下檢驗:
- 核查依據標籤與行業範圍:確認目標能力在該行業是「源數據有行業依據」、需改造的「可遷移應用」,還是未收錄領域,切勿把源數據關聯誤讀為已驗證的客戶部署效果。
- 審計數據契約與外圍設施改造量:對比源行業與目標行業的採集入口、欄位定義與排序口徑,將特徵重定義、數據校驗與配置重構計入正式開發成本。
- 落實合規過濾與人工複核阻斷權:明確素材授權核驗規則與複核責任人,確保未經授權的輸入與未獲人工接受的候選輸出在工作流中被強制攔截並退回。
覺得有用?分享給需要的人。
參考文獻
- [1]
Sculley, D., Holt, G., Golovin, D., Davydov, E., Phillips, T., Ebner, D., Chaudhary, V., Young, M., Crespo, J.-F., & Dennison, D. (2015). Hidden Technical Debt in Machine Learning Systems. Advances in Neural Information Processing Systems (NeurIPS), 28, 2503–2511. papers.nips.cc ↗
- [2]
Pan, S. J., & Yang, Q. (2010). A Survey on Transfer Learning. IEEE Transactions on Knowledge and Data Engineering, 22(10), 1345–1359. doi.org/10.1109/TKDE.2009.191
- [3]
Sambasivan, N., Kapania, S., Highfill, H., Akrong, D., Paritosh, P., & Aroyo, L. M. (2021). "Everyone wants to do the model work, not the data work": Data Cascades in High-Stakes AI. Proceedings of the 2021 CHI Conference on Human Factors in Computing Systems, Article 39. doi.org/10.1145/3411764.3445518