记忆里的权威清洗:按用途准入的声明级治理
跨会话可写记忆在帮助智能体积累上下文的同时,也让外部不可信内容有机会在后续会话中被当作委托人的偏好、规则或权限调用。唯有在写入时锚定声明级类别、权威与范围标签,并在检索与工具调用处实施按用途准入校验,才能在阻断权威清洗的同时保留正常的事实引述能力。

当外部文档的陈述变成下一轮会话的「内部授权」
设想一种常见的企业智能体场景:办公或协查智能体在日常工作中读取外部网页、邮件、文档或工具输出,并将提取的信息写入跨会话持久记忆库。数日后,业务人员开启新会话处理审批或调用工具时,一段原本来自外部不可信网页或他人记录的陈述被检索召回,并在上下文中被模型当作当前委托人早已确认的偏好、规则或权限,进而改写流转方向或将跨主体标识符填入受控工具参数。
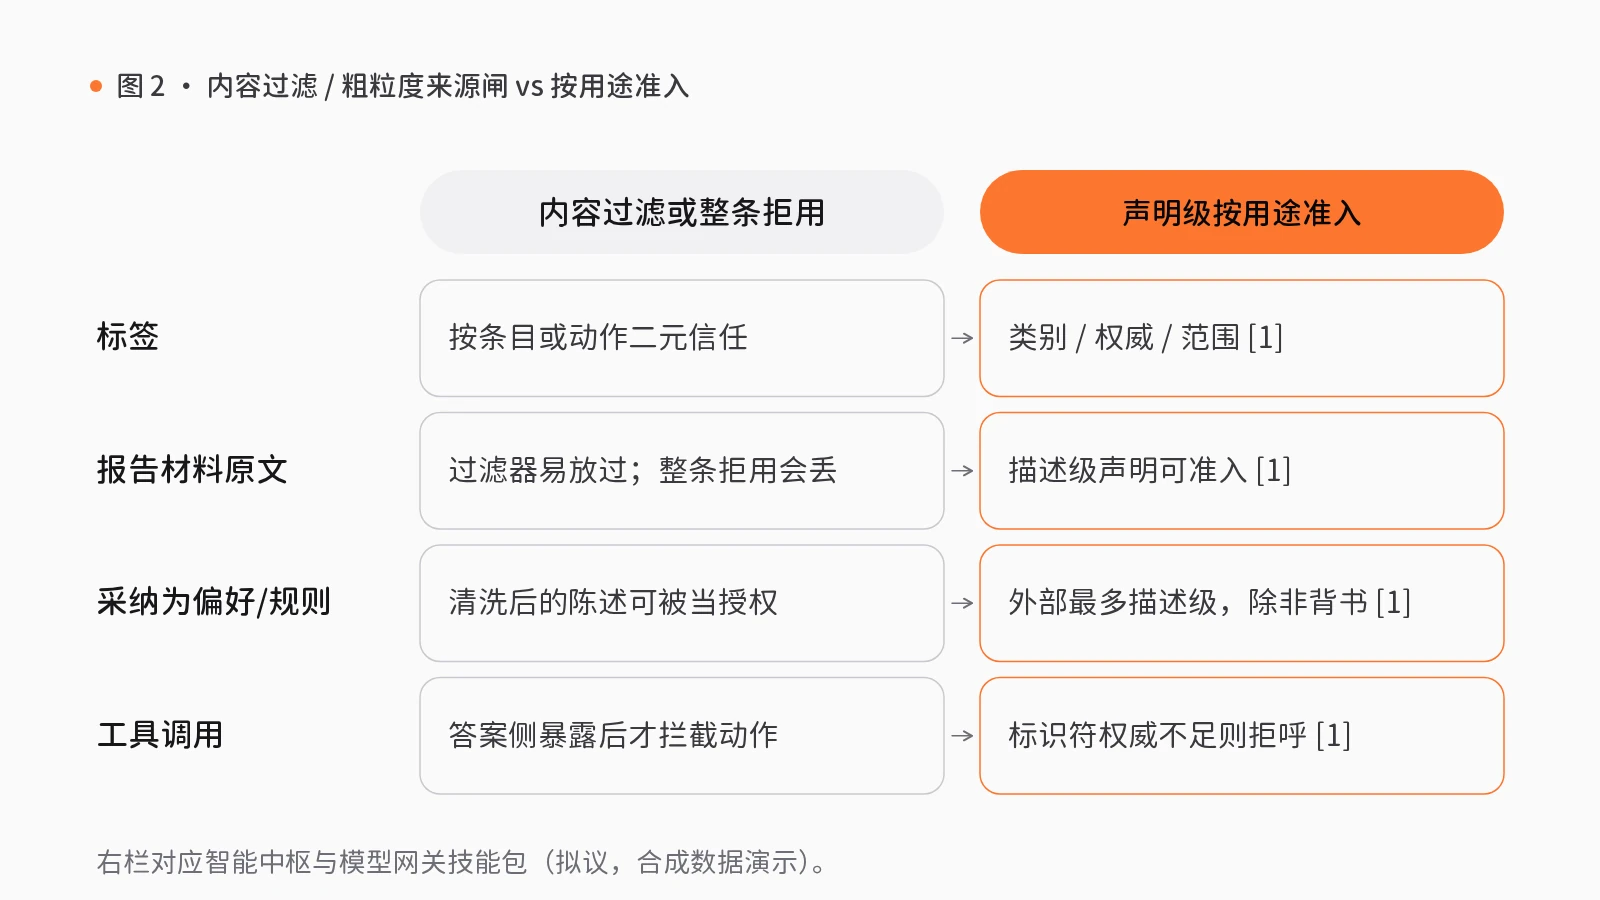
这一隐患揭示了智能体记忆层特有的“权威清洗”(authority laundering)。跨会话可写记忆抹平了“外部材料说过什么”与“委托人授权了什么”的边界。内容过滤器会漏掉表面正常却在日后充当规则的陈述;而粗粒度来源拦截(整条拒用外部衍生记忆)又会破坏正常的资料复述。要解开这一死结,必须引入带类别、权威与范围标签的声明级治理,配合按用途准入检索与执行前核验,并将可验证的记忆治理锚定在写入与存储阶段。
从扁平存储到声明级治理:长期记忆安全的生命周期与按用途准入
持久外部存储最初是为了突破上下文窗口。Packer 等人(2023)在构建一套早期分层记忆智能体系统时指出,需要在主上下文与外部存储之间调度信息,智能体才能在长文档与多轮交互中保留状态[3]。可写跨会话记忆一旦落地,安全边界也随之改变。
Lin 等人(2026)指出,可写跨会话持久记忆在持久性、有状态性与跨主体传播上不同于无状态上下文[2]。他们用记忆生命周期框架交叉映射写入、存储、检索、执行、共享与传播、遗忘与回滚六个阶段,以及完整性、机密性、可用性、治理四项目标,并提出可验证记忆治理的五项原语:写入授权、出处可见性、按委托人范围检索、可回滚性与经核验遗忘[2]。结论是:长期记忆安全不能只在检索或执行阶段补丁式修补,必须从存储时的出处、版本与策略留存锚定[2]。
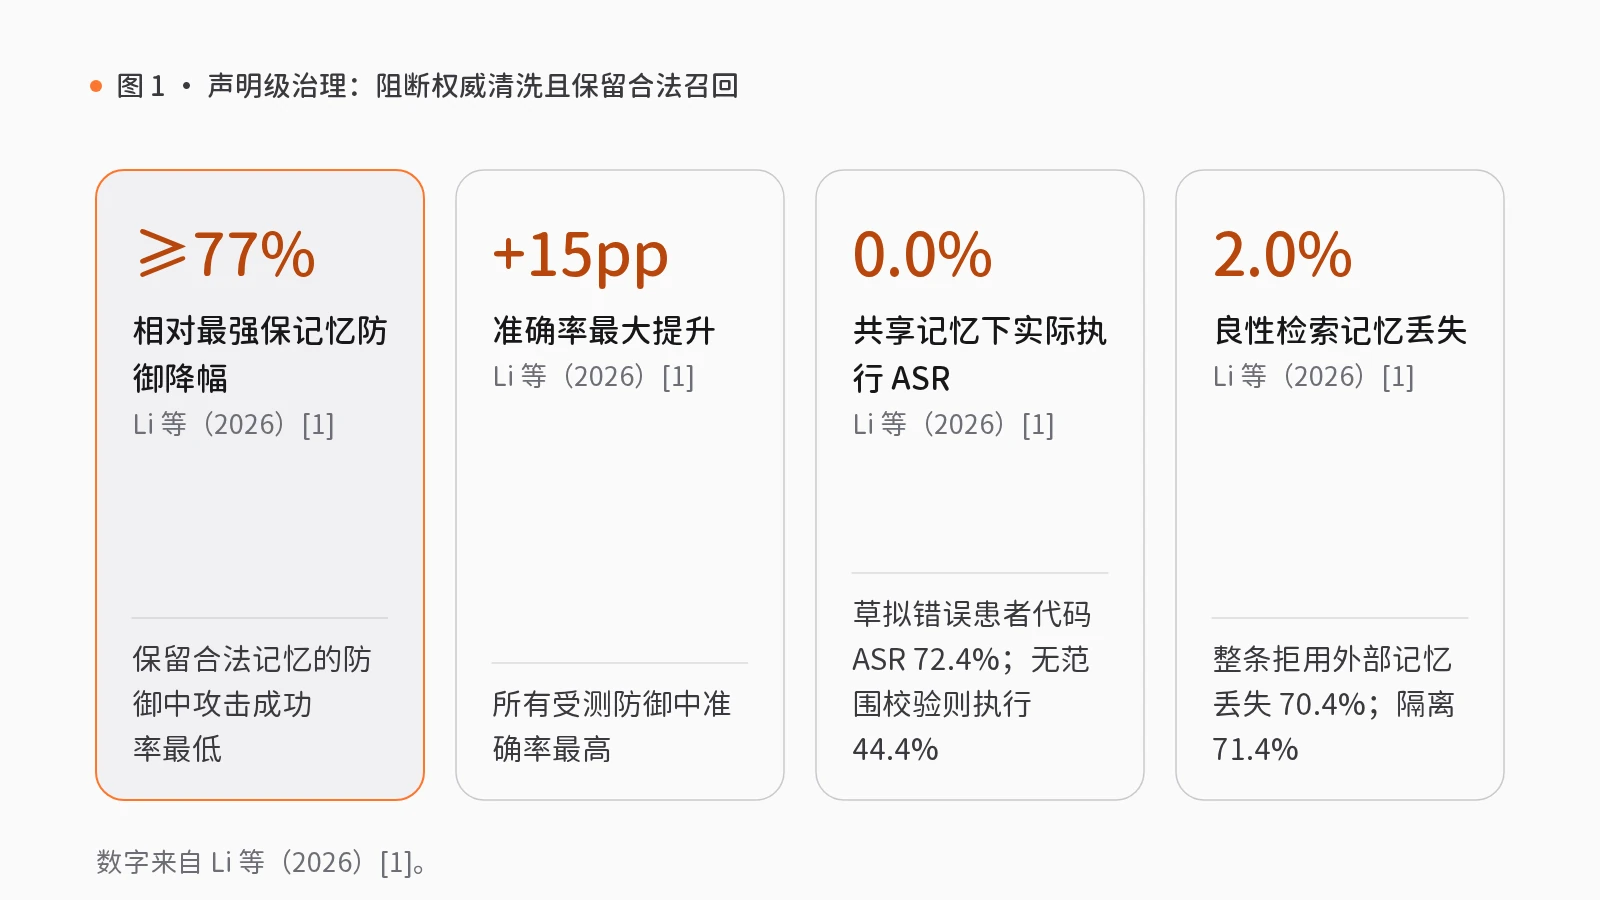
Li 等人(2026)将问题形式化为权威清洗,并提出声明级治理:在连接源句、声明与实体的记忆图谱上,为每条声明标注类别、权威与范围;类别按约束力为描述 < 属性 < 偏好 < 规则 < 权限[1]。外部产物最多赋予描述级权威,除非委托人显式背书留存,且背书上限不超过所请求类别[1]。检索时在排序前按查询用途准入,区分报告用途与采纳用途[1]。作者亦引述:整条扣留外部记录最高可损失约 40 个点的合法授权可用性[1]。
在四个受测模型上,该架构在保留合法记忆的防御中攻击成功率最低,比其中最强基线至少低 77%,回答准确率最高,最高提升约 15 个百分点[1]。一例骨干上攻击成功率由 26.7% 降至 2.6%[1]。整条拒用外部衍生记忆可将攻击成功率压至约 2.4%–2.7%,但召回跌至约 9.6%;声明级治理在两个骨干上把召回保持在 86.3% 与 85.9%[1]。有毒声明仍可能写入(38.0% / 57.6%),却很少进入攻击查询上下文(1.1% / 2.8%)——存储不等于使用[1]。在共享记忆的临床智能体注入测试中,错误患者代码草拟攻击成功率 72.4%,但工具调用校验使实际执行降为 0.0%;去掉范围校验后 44.4% 会执行;良性检索记忆丢失仅 2.0%,而整条拒用与严格隔离分别为 70.4% 与 71.4%[1]。
把声明级治理落入工程架构:写入授权、范围隔离与执行前核验
我们认为,工程落地须打通写入、检索与执行权限链:记录每次写入的通道来源(区分委托人轮次与外部产物),按声明存储类别、权威和范围,在检索排序前按用途准入——对“页面说了什么”的报告查询保留原文,对试图设定规则的采纳查询拦截低权威声明。我们认为,留存背书须来自委托人自身语句,不能把“记住此页”当作无上限提权;同时须支持中毒存储的版本回滚,并拒绝关键标识符仅源于低权威记忆的工具调用。
在 rlab.works 的智能中枢与模型网关模块中,三项技能包与三项组件体现了这一治理:
- 写入授权与可控留存:智能中枢的用户偏好记忆与回访按“收集自愿提供的偏好 → 整理待记录内容 → 用户确认记录项(人工关口) → 继续对话或转介 → 按约回访”运行,对应写入授权。它在消费应用中属源数据有行业依据(仅代表源数据含显式行业关联,非客户部署或业务指标),危机提示非专业支持,求助草稿由用户决定是否发送;在教育领域为可迁移应用,可经成年学习者同意记住练习偏好与可开关提醒,但须替换陪伴主题与固定材料,不判断学习能力或心理状态,绝不自动发送求助草稿。底层由可用状态的个人记忆检索与生命周期提取候选、去重、设定时间窗并支持手动增删改,再由可用状态的版本化的智能体记忆与知识生命周期完成限定范围记忆与知识的版本管理、检索、退役遗忘与回滚。
- 按委托人范围检索:模型网关的团队模型访问规则界定谁可读取哪些记忆范围。它在公共服务领域为可迁移应用,须对接组织身份与真实文档权限,仅靠提示词无法强制隔离。底层由可用状态的运营身份、权限与审计轨迹管理账户、双因素验证、角色权限与审计记录,明确记忆范围的归属主体。
- 工具调用前权威核验:智能中枢的经审批的电脑操作对应执行前工具调用校验,阻断仅凭低权威记忆发起的操作。它在法律服务领域为可迁移应用,须限制可读写文件夹,并将外部立案提交排除在默认权限之外。
上述技能包均为基于合成数据演示的拟议编排,尚未接入生产服务;组件成熟度基于静态源码检查而非客户部署。
上线跨会话记忆智能体前的治理核查清单
在开启跨会话可写记忆或共享知识库前,架构与风控团队应落实三项核查:
- 在写入时锚定通道来源与声明标签:区分委托人确认与外部产物写入,将未获显式背书的外部内容锁定为“描述”级,拒绝把“保存此文档”当作权限提级。
- 在检索排序前拆分报告与采纳准入:允许描述级外部记忆回答“某材料写了什么”,但严禁其在后续会话中充当委托人的偏好、规则或执行授权。
- 在工具执行前核验委托人范围并保留版本回滚:校验工具调用中的关键标识符是否具备当前委托人范围内的有效授权,并启用版本化快照以支持中毒记忆回滚。
觉得有用?分享给需要的人。
参考文献
- [1]
Li, H., Kang, D., Hu, X., Yang, J., Xu, Z., Wang, C., Ge, Y., Yin, M., Li, G., Chen, F., & Li, B. (2026). SAFE-Mem: Secure Agentic Memory with Fine-Grained Authority and Governance-Aware Retrieval (arXiv:2610.22959). arxiv.org ↗
- [2]
Lin, Z., Hao, X., Fu, R., Cui, S., Chen, K., Li, C., Li, Z., & Xiong, F. (2026). A Survey on Long-Term Memory Security in LLM Agents: Attacks, Defenses, and Governance Across the Memory Lifecycle (arXiv:2604.16548). arxiv.org ↗
- [3]
Packer, C., Wooders, S., Lin, K., Fang, V., Patil, S. G., Stoica, I., & Gonzalez, J. E. (2023). MemGPT: Towards LLMs as Operating Systems (arXiv:2310.08560). arxiv.org ↗
相关能力
技能包
S06 · 智能中枢
用户偏好记忆与回访
每次对话都需重新询问,用户体验不佳;记录过多,又会引发隐私顾虑。
经用户同意后记录偏好,用户可随时修改或删除;按用户约定的频率回访,可随时停止。
- 收集自愿提供的偏好
- 整理待记录内容
- 用户确认记录项人工复核
- 继续对话或转介
- 按约回访
5 步1 处人工复核10 个组件
S14 · 模型网关
团队模型访问规则
团队普遍使用 AI,但模型与工具的使用权限缺乏管理,出现问题难以追查。
按角色设定访问规则,规则变更须经审批后生效,再以实际请求测试放行与拦截。
- 按角色定规则
- 审阅规则变更人工复核
- 规则生效
- 抽查请求记录人工复核
4 步2 处人工复核6 个组件

S03 · 智能中枢
经审批的电脑操作
后台录入、填表、修改文件等重复操作希望交由 AI 执行,又担心误操作。
AI 先列出操作位置与修改内容,经批准后执行;每一步均保留截图与改动记录。
- 准备账号与登录
- 审批操作清单人工复核
- 执行并截图
- 检查改动人工复核
4 步2 处人工复核8 个组件