記憶裏的權威清洗:按用途准入的聲明級治理
跨會話可寫記憶在幫助智能體積累上下文的同時,也讓外部不可信內容有機會在後續會話中被當作委託人的偏好、規則或權限調用。唯有在寫入時錨定聲明級類別、權威與範圍標籤,並在檢索與工具調用處實施按用途准入校驗,才能在阻斷權威清洗的同時保留正常的事實引述能力。

當外部文檔的陳述變成下一輪會話的「內部授權」
設想一種常見的企業智能體場景:辦公或協查智能體在日常工作中讀取外部網頁、郵件、文檔或工具輸出,並將提取的資訊寫入跨會話持久記憶庫。數日後,業務人員開啓新會話處理審批或調用工具時,一段原本來自外部不可信網頁或他人記錄的陳述被檢索召回,並在上下文中被模型當作當前委託人早已確認的偏好、規則或權限,進而改寫流轉方向或將跨主體標識符填入受控工具參數。
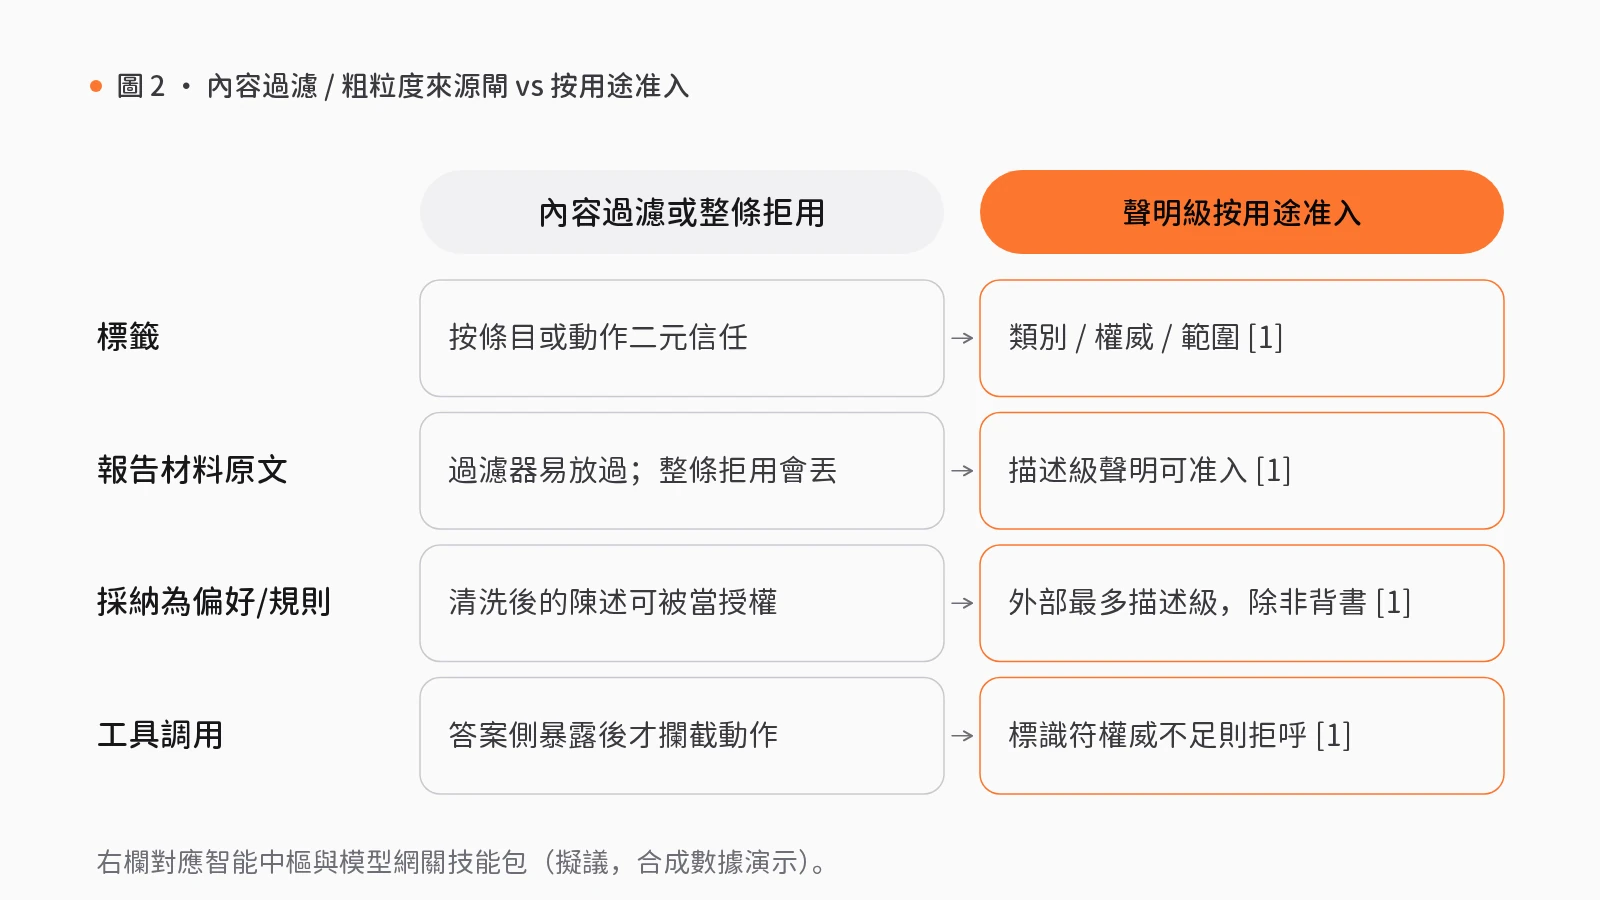
這一隱患揭示了智能體記憶層特有的「權威清洗」(authority laundering)。跨會話可寫記憶抹平了「外部材料説過什麼」與「委託人授權了什麼」的邊界。內容過濾器會漏掉表面正常卻在日後充當規則的陳述;而粗粒度來源攔截(整條拒用外部衍生記憶)又會破壞正常的資料複述。要解開這一死結,必須引入帶類別、權威與範圍標籤的聲明級治理,配合按用途准入檢索與執行前核驗,並將可驗證的記憶治理錨定在寫入與存儲階段。
從扁平存儲到聲明級治理:長期記憶安全的生命週期與按用途准入
持久外部存儲最初是為了突破上下文窗口。Packer 等人(2023)在構建一套早期分層記憶智能體系統時指出,需要在主上下文與外部存儲之間調度資訊,智能體才能在長文檔與多輪交互中保留狀態[3]。可寫跨會話記憶一旦落地,安全邊界也隨之改變。
Lin 等人(2026)指出,可寫跨會話持久記憶在持久性、有狀態性與跨主體傳播上不同於無狀態上下文[2]。他們用記憶生命週期框架交叉映射寫入、存儲、檢索、執行、共享與傳播、遺忘與回滾六個階段,以及完整性、機密性、可用性、治理四項目標,並提出可驗證記憶治理的五項原語:寫入授權、出處可見性、按委託人範圍檢索、可回滾性與經核驗遺忘[2]。結論是:長期記憶安全不能只在檢索或執行階段補丁式修補,必須從存儲時的出處、版本與策略留存錨定[2]。
Li 等人(2026)將問題形式化為權威清洗,並提出聲明級治理:在連接源句、聲明與實體的記憶圖譜上,為每條聲明標註類別、權威與範圍;類別按約束力為描述 < 屬性 < 偏好 < 規則 < 權限[1]。外部產物最多賦予描述級權威,除非委託人顯式背書留存,且背書上限不超過所請求類別[1]。檢索時在排序前按查詢用途准入,區分報告用途與採納用途[1]。作者亦引述:整條扣留外部記錄最高可損失約 40 個點的合法授權可用性[1]。
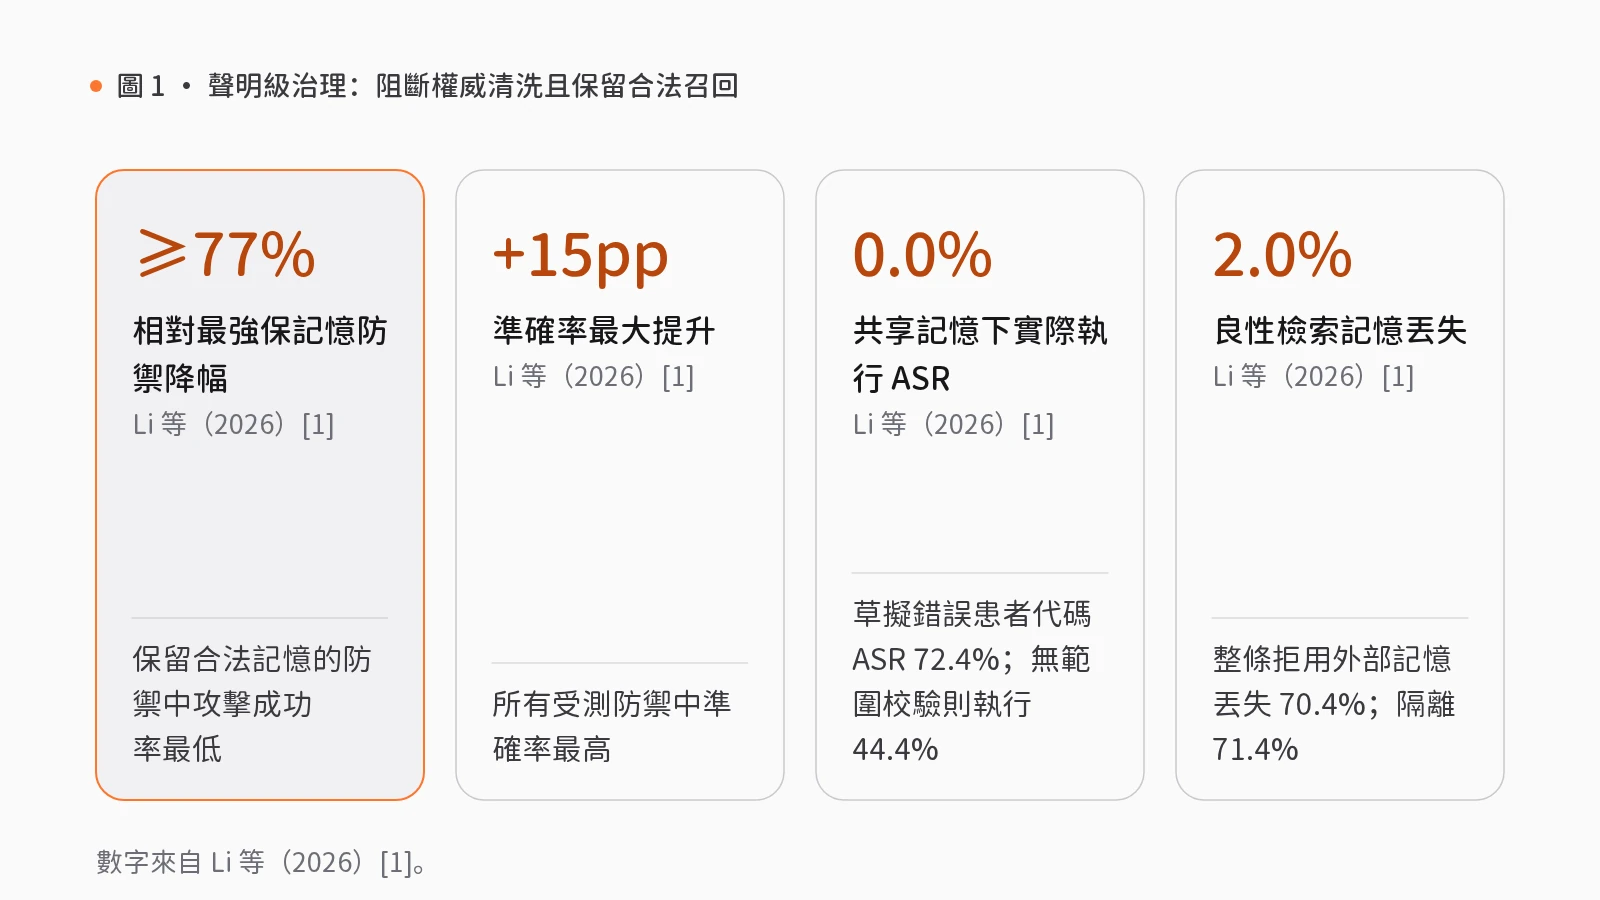
在四個受測模型上,該架構在保留合法記憶的防禦中攻擊成功率最低,比其中最強基線至少低 77%,回答準確率最高,最高提升約 15 個百分點[1]。一例骨幹上攻擊成功率由 26.7% 降至 2.6%[1]。整條拒用外部衍生記憶可將攻擊成功率壓至約 2.4%–2.7%,但召回跌至約 9.6%;聲明級治理在兩個骨幹上把召回保持在 86.3% 與 85.9%[1]。有毒聲明仍可能寫入(38.0% / 57.6%),卻很少進入攻擊查詢上下文(1.1% / 2.8%)——存儲不等於使用[1]。在共享記憶的臨牀智能體注入測試中,錯誤患者代碼草擬攻擊成功率 72.4%,但工具調用校驗使實際執行降為 0.0%;去掉範圍校驗後 44.4% 會執行;良性檢索記憶丟失僅 2.0%,而整條拒用與嚴格隔離分別為 70.4% 與 71.4%[1]。
把聲明級治理落入工程架構:寫入授權、範圍隔離與執行前核驗
我們認為,工程落地須打通寫入、檢索與執行權限鏈:記錄每次寫入的通道來源(區分委託人輪次與外部產物),按聲明存儲類別、權威和範圍,在檢索排序前按用途准入——對「頁面説了什麼」的報告查詢保留原文,對試圖設定規則的採納查詢攔截低權威聲明。我們認為,留存背書須來自委託人自身語句,不能把「記住此頁」當作無上限提權;同時須支援中毒存儲的版本回滾,並拒絕關鍵標識符僅源於低權威記憶的工具調用。
在 rlab.works 的智能中樞與模型網關模組中,三項技能包與三項組件體現了這一治理:
- 寫入授權與可控留存:智能中樞的用戶偏好記憶與回訪按「收集自願提供的偏好 → 整理待記錄內容 → 用戶確認記錄項(人工關口) → 繼續對話或轉介 → 按約回訪」運行,對應寫入授權。它在消費應用中屬源數據有行業依據(僅代表源數據含顯式行業關聯,非客戶部署或業務指標),危機提示非專業支援,求助草稿由用戶決定是否發送;在教育領域為可遷移應用,可經成年學習者同意記住練習偏好與可開關提醒,但須替換陪伴主題與固定材料,不判斷學習能力或心理狀態,絕不自動發送求助草稿。底層由可用狀態的個人記憶檢索與生命週期提取候選、去重、設定時間窗並支援手動增刪改,再由可用狀態的版本化的智能體記憶與知識生命週期完成限定範圍記憶與知識的版本管理、檢索、退役遺忘與回滾。
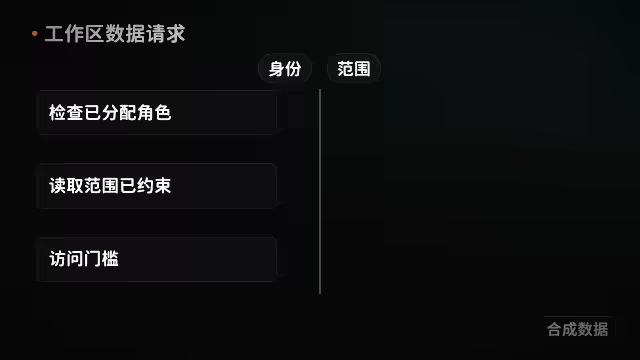
- 按委託人範圍檢索:模型網關的團隊模型訪問規則界定誰可讀取哪些記憶範圍。它在公共服務領域為可遷移應用,須對接組織身份與真實文檔權限,僅靠提示詞無法強制隔離。底層由可用狀態的運營身份、權限與審計軌跡管理帳戶、雙因素驗證、角色權限與審計記錄,明確記憶範圍的歸屬主體。
- 工具調用前權威核驗:智能中樞的經審批的電腦操作對應執行前工具調用校驗,阻斷僅憑低權威記憶發起的操作。它在法律服務領域為可遷移應用,須限制可讀寫資料夾,並將外部立案提交排除在預設權限之外。
上述技能包均為基於合成數據演示的擬議編排,尚未接入生產服務;組件成熟度基於靜態源碼檢查而非客戶部署。
上線跨會話記憶智能體前的治理核查清單
在開啓跨會話可寫記憶或共享知識庫前,架構與風控團隊應落實三項核查:
- 在寫入時錨定通道來源與聲明標籤:區分委託人確認與外部產物寫入,將未獲顯式背書的外部內容鎖定為「描述」級,拒絕把「保存此文檔」當作權限提級。
- 在檢索排序前拆分報告與採納准入:允許描述級外部記憶回答「某材料寫了什麼」,但嚴禁其在後續會話中充當委託人的偏好、規則或執行授權。
- 在工具執行前核驗委託人範圍並保留版本回滾:校驗工具調用中的關鍵標識符是否具備當前委託人範圍內的有效授權,並啓用版本化快照以支援中毒記憶回滾。
覺得有用?分享給需要的人。
參考文獻
- [1]
Li, H., Kang, D., Hu, X., Yang, J., Xu, Z., Wang, C., Ge, Y., Yin, M., Li, G., Chen, F., & Li, B. (2026). SAFE-Mem: Secure Agentic Memory with Fine-Grained Authority and Governance-Aware Retrieval (arXiv:2610.22959). arxiv.org ↗
- [2]
Lin, Z., Hao, X., Fu, R., Cui, S., Chen, K., Li, C., Li, Z., & Xiong, F. (2026). A Survey on Long-Term Memory Security in LLM Agents: Attacks, Defenses, and Governance Across the Memory Lifecycle (arXiv:2604.16548). arxiv.org ↗
- [3]
Packer, C., Wooders, S., Lin, K., Fang, V., Patil, S. G., Stoica, I., & Gonzalez, J. E. (2023). MemGPT: Towards LLMs as Operating Systems (arXiv:2310.08560). arxiv.org ↗
相關能力
技能包
S06 · 智能中樞
用戶偏好記憶與回訪
每次對話都需重新詢問,用戶體驗不佳;記錄過多,又會引發隱私顧慮。
經用戶同意後記錄偏好,用戶可隨時修改或刪除;按用戶約定的頻率回訪,可隨時停止。
- 收集自願提供的偏好
- 整理待記錄內容
- 用戶確認記錄項人工複核
- 繼續對話或轉介
- 按約回訪
5 步1 處人工複核10 個組件
S14 · 模型網關
團隊模型訪問規則
團隊普遍使用 AI,但模型與工具的使用權限缺乏管理,出現問題難以追查。
按角色設定訪問規則,規則變更須經審批後生效,再以實際請求測試放行與攔截。
- 按角色定規則
- 審閲規則變更人工複核
- 規則生效
- 抽查請求記錄人工複核
4 步2 處人工複核6 個組件

S03 · 智能中樞
經審批的電腦操作
後台錄入、填表、修改文件等重複操作希望交由 AI 執行,又擔心誤操作。
AI 先列出操作位置與修改內容,經批准後執行;每一步均保留截圖與改動記錄。
- 準備帳戶與登入
- 審批操作清單人工複核
- 執行並截圖
- 檢查改動人工複核
4 步2 處人工複核8 個組件