【媒体内容】从信息过载到可溯源编务:每日简报图谱、多语种编译审校与跨渠道归因
生成内容泛滥后,信源可追溯与编辑问责比发稿速度更为稀缺;媒体工作流需在每日简报、解说视频合成、多语种编译与跨渠道归因中植入原文出处锚定与责任编辑复核。

稿件供给泛滥之后,为何编辑部反而面临信任赤字
设想一家国际商业资讯机构的日常编务场景:编辑部接入生成式大模型与多语种自动改写脚本后,每日抓取的行业快讯、编译稿件与短视频解说词产量大幅增加。然而上线不久,值班主编却发现审校负担不降反升——自动聚合的晨报混入了未经核实的二手传闻且缺失原始出处,多语种渠道发布的编译稿在关键表述上与母本出现偏差,而合成短视频的旁白时间轴与画面出处也难以逐一核对。
这一困境揭示了内容机构在算法时代的工程症结。生成内容泛滥后,单纯的文本与音视频产能已不再构成壁垒,信源可追溯与编辑问责反而更加稀缺。媒体与内容团队要将大模型引入生产流程,不能依赖缺乏依据的自动改写,而必须在系统架构中强制要求简报附带原文出处,并让多语种改写、解说视频合成与分发效果复盘经过责任编辑审校与实验验证。
注意力稀缺、算法新闻与受众信任边界
信息供给的膨胀为何会加剧编辑部的筛选与核验压力?赫伯特·西蒙(Herbert A. Simon, 1971)在探讨信息富足世界的组织设计时指出,当信息本身变得充裕时,必然导致另一种要素的匮乏,即信息接收者的注意力——正如其研究所表述的,“a wealth of information creates a poverty of attention”[2]。基于这一机制,西蒙指出信息系统的设计重点应当是节约并保护受众的注意力,即承担过滤职能,而不是向系统内盲目供给更多信息[2]。对于媒体组织而言,如果自动化工具只是在制造更多缺乏出处过滤的快讯与改写稿,实质上是在透支读者的注意力与信任。
进入算法深度介入传媒业的阶段,尼古拉斯·迪亚科波洛斯(Nicholas Diakopoulos, 2019)在其关于算法如何改写媒体的专著中进一步剖析了算法如何改变新闻的生产、传播与接收方式[1]。从大数据中的隐藏关联到传播虚假新闻的自动程序,新闻业正越来越多地由计算机生成;但迪亚科波洛斯同时阐明,新闻工作者及其所秉持的专业价值几乎没有被算法取代的风险[1]。算法可以辅助线索挖掘、文本生成与分发编排,但核实事实、权衡公共利益与承担差错责任的价值判断,依然必须留在人类编辑手中。
受众侧的经验证据同样印证了这一边界。牛津大学路透新闻研究所发布的 2024 年度数字新闻报告(Newman et al., 2024)是一项覆盖 47 个市场、约 95,000 名受访者[3]的年度数字新闻消费调查报告。该报告发现,公众对于主要由人工智能生成、仅配备少量人工监督的新闻普遍感到不安;相比之下,当人工智能在幕后用于辅助新闻工作者时,受众的接受度明显更高;同时,公众对于网络信息真伪的担忧持续存在[3]。我们据此认为,将人工智能置于幕后承担去重、关联与对齐,将把关权交还责任编辑,是兼顾编务效率与公信力的制度前提。
可溯源编务的工程映射:简报图谱、多语审校与跨渠道复盘
将上述理论转化为媒体工程实践,核心在于用带证据链的工作流替代无约束的直接发布。在 rlab.works 的智能感知与智能商务模块中,这一编务流程被拆解为四个相互衔接的组合技能包。
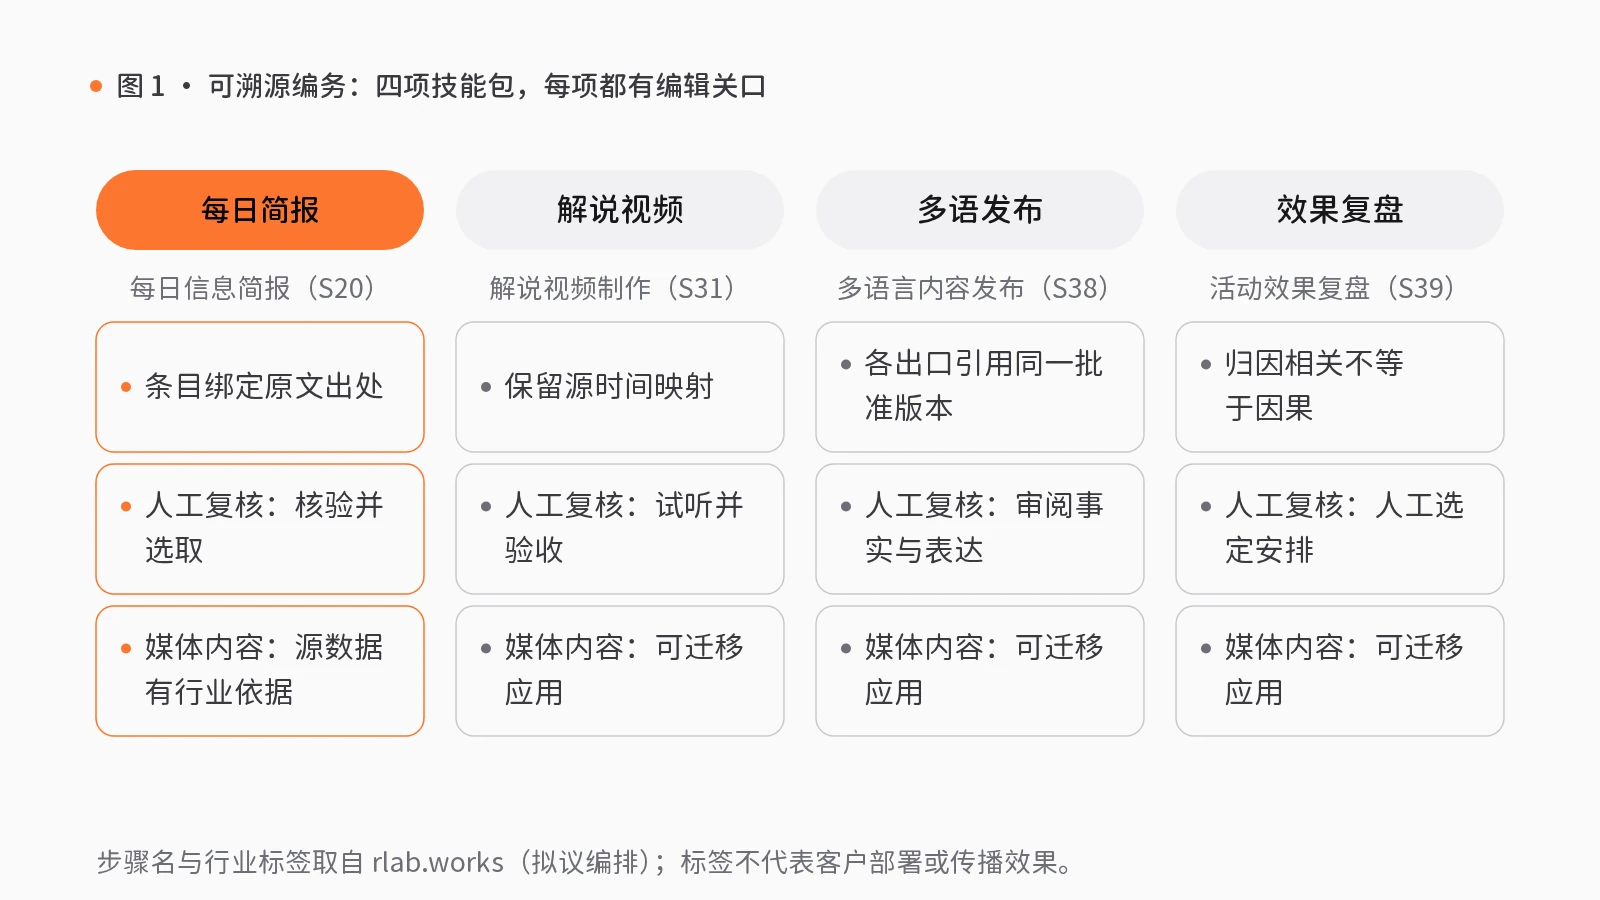
进入跨语种分发阶段,智能商务模块下的多语言内容发布(S38)技能包以已接受事实、受众、语言与目标渠道为输入,执行撰写内容草稿(辅助)、翻译并校对(辅助)、审阅事实与措辞(人工复核)、发布至网页与渠道(辅助)及优化搜索与分享(辅助)。它在媒体内容与公共服务行业均为可迁移应用:翻译组件原有的酒店字段需适配通用稿件,不同出口必须引用同一批准版本,使同一份事实在不同语言和渠道保持一致。
发布后的效果评估由营销活动复盘(S39)技能包承接。工作流以已发布内容、许可统计与活动目标为输入,通过对应来源与转化(辅助,结合「归因与转化反馈」组件关联追踪链接与注册及转化数据)、比较表现(辅助)、起草调整方案(辅助)、选定下一轮(人工复核)及排期并存档(辅助),将文章来源链接、阅读与订阅行动对齐,供编辑选择下一轮选题和渠道。该技能包在媒体内容行业为可迁移应用,需区分阅读、订阅和实际付费事件,且归因相关性不证明传播因果。
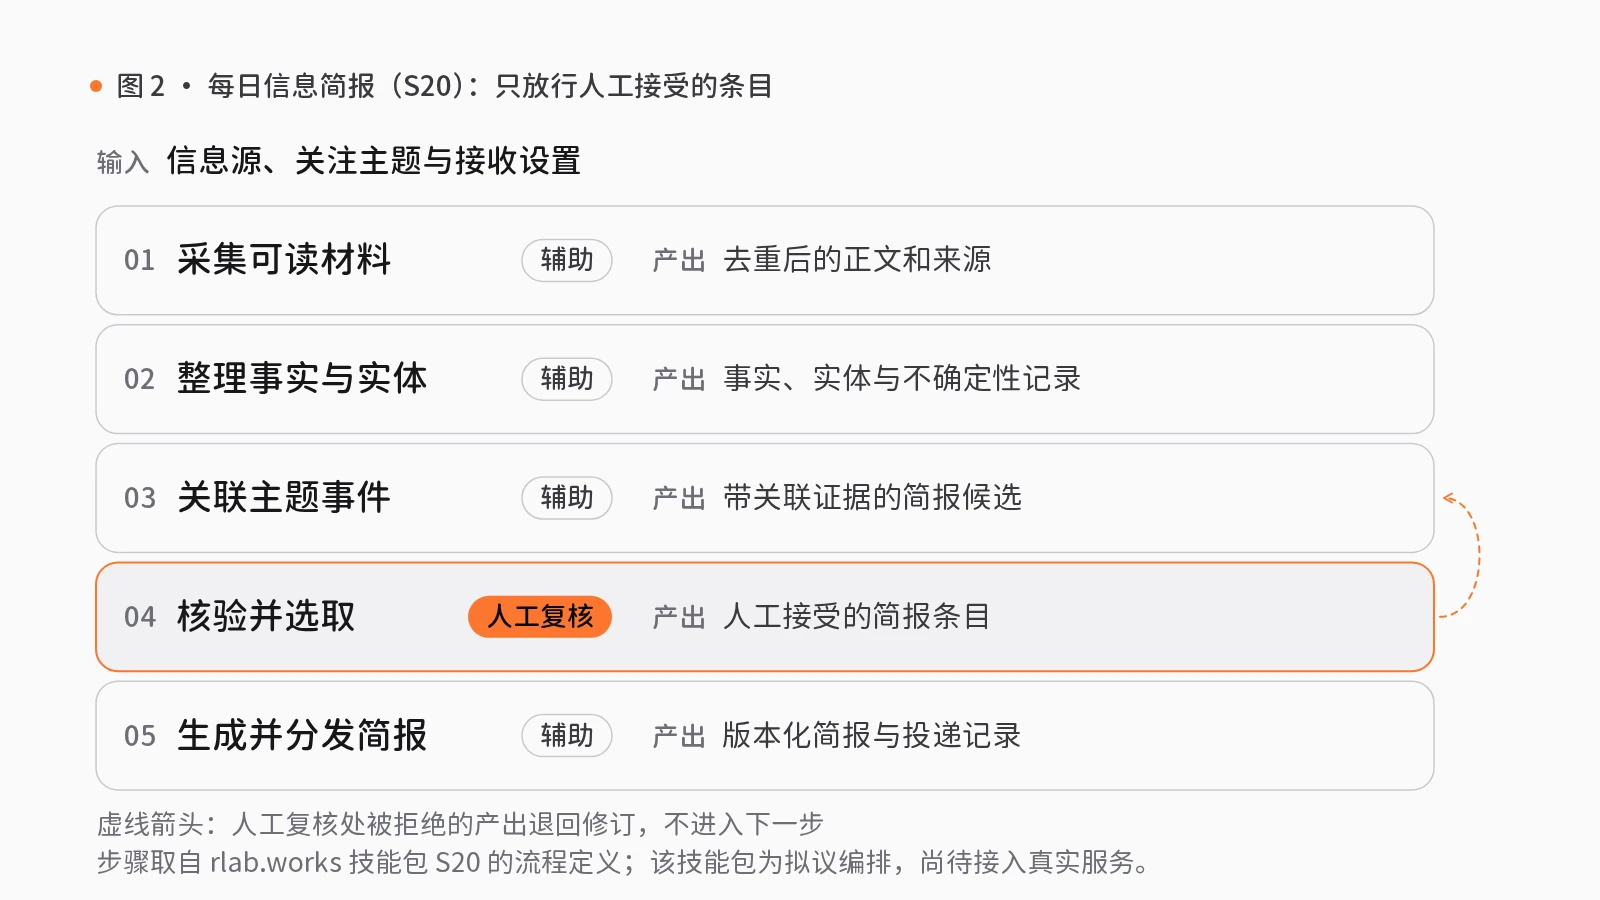
在工程边界上须如实说明:站点上述技能包均为拟议编排,仅通过合成数据走查演示,尚未接入真实服务;组件成熟度均基于静态源码检查而非生产部署。即便每日信息简报(S20)在媒体内容行业为源数据有行业依据,也仅表示源数据有显式行业关联,不代表客户案例、部署或传播效果。
媒体技术负责人启动试点前的三项检验
媒体机构总编辑或技术负责人在批准编务自动化试点前,可依据以下三项具体标准检验系统设计:
- 核查信源与剪辑的溯源契约:检查简报条目是否强制绑定去重后的原文出处与不确定性记录,解说视频是否保留源时间映射;没有出处锚定的生成文本不得进入审校队列。
- 核查多语种版本的单一事实基准:确认多语种编译流程是否以人工核验过的事实为唯一输入,且在发布前设有人工审阅关口;任何被拒绝的译本必须退回修订,防止不同语种渠道出现口径分裂。
- 核查归因复盘的事件口径与人工决策权:确认数据复盘能否严格区分浅层阅读、订阅登记与实际付费,并将渠道调整建议交由责任编辑审批,避免把短期点击相关性直接当作自动排期指令。
觉得有用?分享给需要的人。
参考文献
- [1]
Diakopoulos, N. (2019). Automating the News: How Algorithms Are Rewriting the Media. Harvard University Press. doi.org/10.4159/9780674239302
- [2]
Simon, H. A. (1971). Designing Organizations for an Information-Rich World. In M. Greenberger (Ed.), Computers, Communications, and the Public Interest (pp. 37–72). Johns Hopkins Press. gwern.net ↗
- [3]
Newman, N., Fletcher, R., Robertson, C. T., Arguedas, A. R., & Nielsen, R. K. (2024). Reuters Institute Digital News Report 2024. Reuters Institute for the Study of Journalism, University of Oxford. reutersinstitute.politics.ox.ac.uk ↗
相关能力
技能包
S20 · 智能感知
每日信息简报
每天需查阅数十个信息源,重复多、有效少,转述时还常遗漏出处。
自动采集并去重,提取事实与相关事件,经人工核实筛选后,生成可订阅的每日简报。
- 采集并去重
- 提取事实
- 关联相关事件
- 核实并筛选人工复核
- 生成并发送
5 步1 处人工复核9 个组件
S31 · 智能感知
解说视频制作
一条讲解视频需剪辑画面、配置旁白、对齐时间,修改一处便需全部重新对齐。
按脚本制作画面并剪辑,配上旁白与音乐并对齐时间,最后经人工试听验收。
- 准备场景画面
- 剪辑成片
- 配旁白与音乐
- 试听并验收人工复核
4 步1 处人工复核7 个组件
S38 · 智能商务
多语言内容发布
一篇内容需翻译成多种语言并发布到网页和社交渠道,版本一多便难以对应。
依据核实的事实撰稿,翻译后逐一语种校对,事实与措辞经人工审批,再发布至网页与选定渠道。
- 撰写内容草稿
- 翻译并校对
- 审阅事实与措辞人工复核
- 发布至网页与渠道
- 优化搜索与分享
5 步1 处人工复核8 个组件
S39 · 智能商务
营销活动复盘
活动结束后只看总数,难以判断哪条内容、哪个渠道表现更好。
将访问与转化记录对应到来源,比较各条内容的表现,起草下一轮调整方案,由人工确定排期。
- 对应来源与转化
- 比较表现
- 起草调整方案
- 选定下一轮人工复核
- 排期并存档
5 步1 处人工复核9 个组件