【媒體內容】從資訊過載到可溯源編務:每日簡報圖譜、多語種編譯審校與跨渠道歸因
生成內容氾濫後,信源可追溯與編輯問責比發稿速度更為稀缺;媒體工作流需在每日簡報、解説影片合成、多語種編譯與跨渠道歸因中植入原文出處錨定與責任編輯複核。

稿件供給氾濫之後,為何編輯部反而面臨信任赤字
設想一家國際商業資訊機構的日常編務場景:編輯部接入生成式大模型與多語種自動改寫腳本後,每日抓取的行業快訊、編譯稿件與短影片解説詞產量大幅增加。然而上線不久,值班主編卻發現審校負擔不降反升——自動聚合的晨報混入了未經核實的二手傳聞且缺失原始出處,多語種渠道發佈的編譯稿在關鍵表述上與母本出現偏差,而合成短影片的旁白時間軸與畫面出處也難以逐一核對。
這一困境揭示了內容機構在算法時代的工程癥結。生成內容氾濫後,單純的文本與音影片產能已不再構成壁壘,信源可追溯與編輯問責反而更加稀缺。媒體與內容團隊要將大模型引入生產流程,不能依賴缺乏依據的自動改寫,而必須在系統架構中強制要求簡報附帶原文出處,並讓多語種改寫、解説影片合成與分發效果復盤經過責任編輯審校與實驗驗證。
注意力稀缺、算法新聞與受眾信任邊界
資訊供給的膨脹為何會加劇編輯部的篩選與核驗壓力?赫伯特·西蒙(Herbert A. Simon, 1971)在探討資訊富足世界的組織設計時指出,當資訊本身變得充裕時,必然導致另一種要素的匱乏,即資訊接收者的注意力——正如其研究所表述的,“a wealth of information creates a poverty of attention”[2]。基於這一機制,西蒙指出資訊系統的設計重點應當是節約並保護受眾的注意力,即承擔過濾職能,而不是向系統內盲目供給更多資訊[2]。對於媒體組織而言,如果自動化工具只是在製造更多缺乏出處過濾的快訊與改寫稿,實質上是在透支讀者的注意力與信任。
進入算法深度介入傳媒業的階段,尼古拉斯·迪亞科波洛斯(Nicholas Diakopoulos, 2019)在其關於算法如何改寫媒體的專著中進一步剖析了算法如何改變新聞的生產、傳播與接收方式[1]。從大數據中的隱藏關聯到傳播虛假新聞的自動程式,新聞業正越來越多地由計算機生成;但迪亞科波洛斯同時闡明,新聞工作者及其所秉持的專業價值幾乎沒有被算法取代的風險[1]。算法可以輔助線索挖掘、文本生成與分發編排,但核實事實、權衡公共利益與承擔差錯責任的價值判斷,依然必須留在人類編輯手中。
受眾側的經驗證據同樣印證了這一邊界。牛津大學路透新聞研究所發佈的 2024 年度數字新聞報告(Newman et al., 2024)是一項覆蓋 47 個市場、約 95,000 名受訪者[3]的年度數字新聞消費調查報告。該報告發現,公眾對於主要由人工智能生成、僅配備少量人工監督的新聞普遍感到不安;相比之下,當人工智能在幕後用於輔助新聞工作者時,受眾的接受度明顯更高;同時,公眾對於網絡資訊真偽的擔憂持續存在[3]。我們據此認為,將人工智能置於幕後承擔去重、關聯與對齊,將把關權交還責任編輯,是兼顧編務效率與公信力的制度前提。
可溯源編務的工程映射:簡報圖譜、多語審校與跨渠道復盤
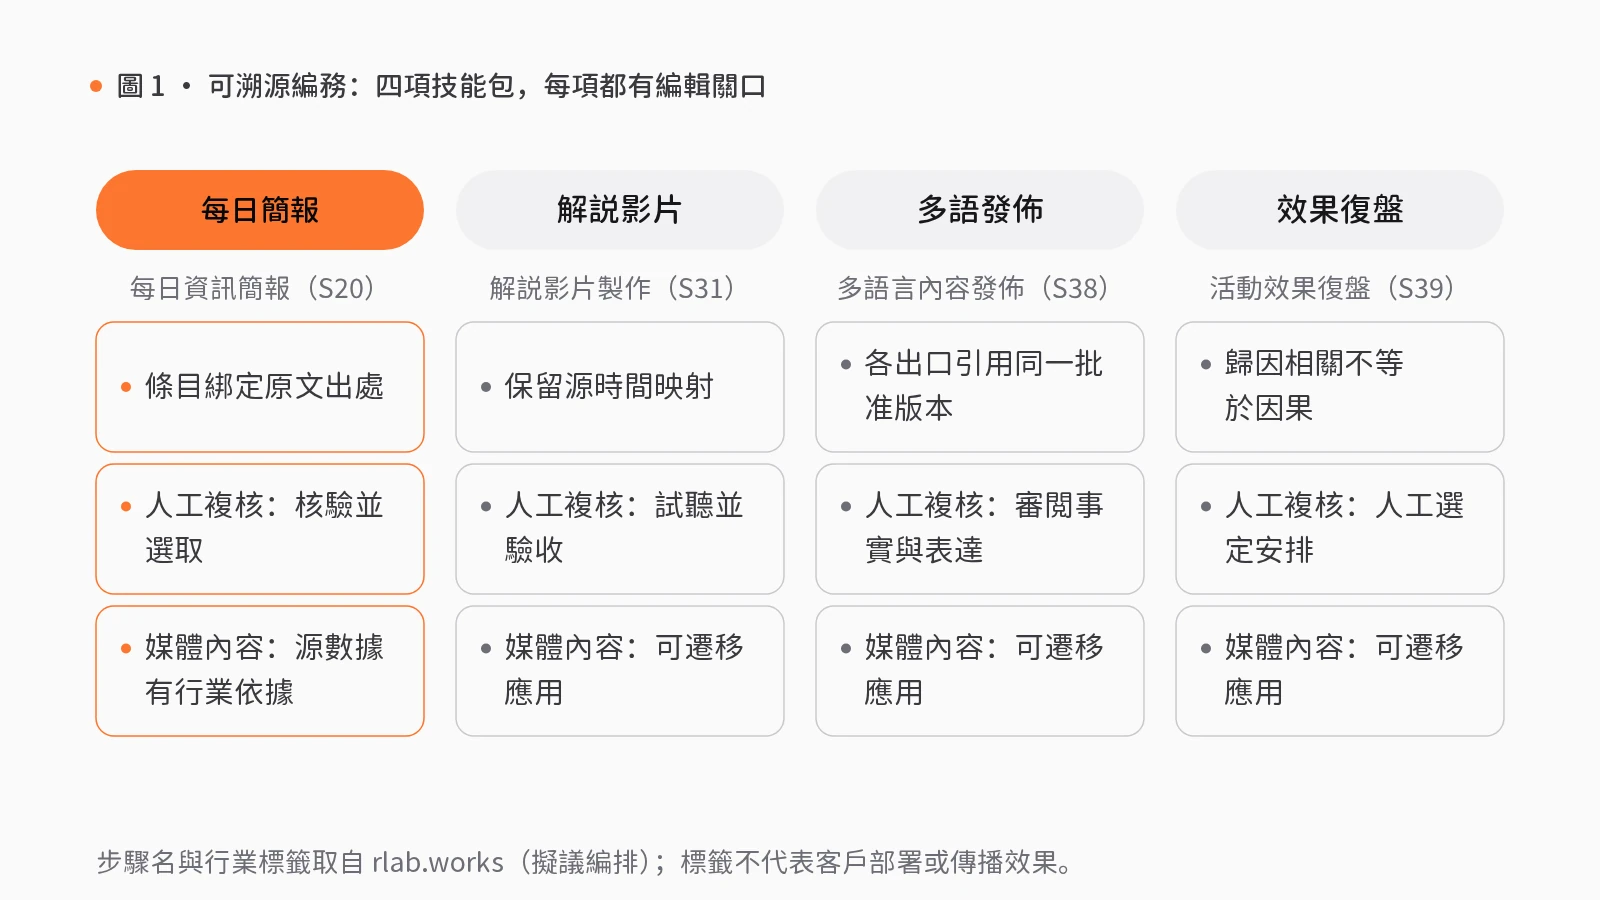
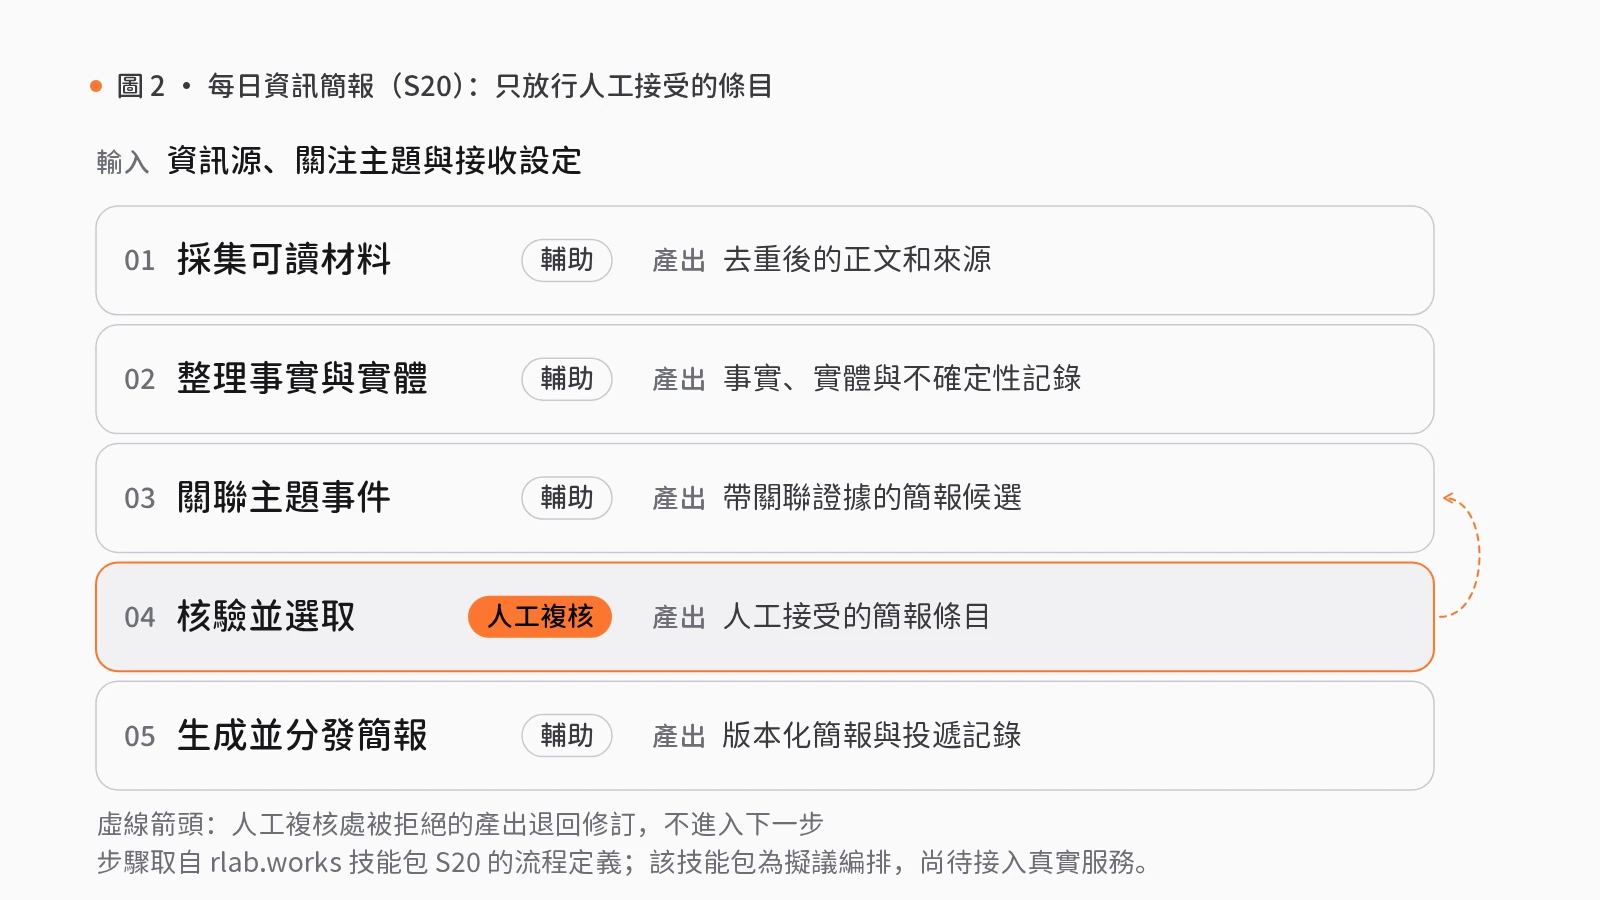
將上述理論轉化為媒體工程實踐,核心在於用帶證據鏈的工作流替代無約束的直接發佈。在 rlab.works 的智能感知與智能商務模組中,這一編務流程被拆解為四個相互銜接的組合技能包。
進入跨語種分發階段,智能商務模組下的多語言內容發佈(S38)技能包以已接受事實、受眾、語言與目標渠道為輸入,執行撰寫內容草稿(輔助)、翻譯並校對(輔助)、審閲事實與措辭(人工複核)、發佈至網頁與渠道(輔助)及優化搜尋與分享(輔助)。它在媒體內容與公共服務行業均為可遷移應用:翻譯組件原有的酒店欄位需適配通用稿件,不同出口必須引用同一批准版本,使同一份事實在不同語言和渠道保持一致。
發佈後的效果評估由營銷活動復盤(S39)技能包承接。工作流以已發佈內容、許可統計與活動目標為輸入,通過對應來源與轉化(輔助,結合「歸因與轉化反饋」組件關聯追蹤連結與註冊及轉化數據)、比較表現(輔助)、起草調整方案(輔助)、選定下一輪(人工複核)及排期並存檔(輔助),將文章來源連結、閲讀與訂閲行動對齊,供編輯選擇下一輪選題和渠道。該技能包在媒體內容行業為可遷移應用,需區分閲讀、訂閲和實際付費事件,且歸因相關性不證明傳播因果。
在工程邊界上須如實説明:站點上述技能包均為擬議編排,僅通過合成數據走查演示,尚未接入真實服務;組件成熟度均基於靜態源碼檢查而非生產部署。即便每日資訊簡報(S20)在媒體內容行業為源數據有行業依據,也僅表示源數據有顯式行業關聯,不代表客戶案例、部署或傳播效果。
媒體技術負責人啓動試點前的三項檢驗
媒體機構總編輯或技術負責人在批准編務自動化試點前,可依據以下三項具體標準檢驗系統設計:
- 核查信源與剪輯的溯源契約:檢查簡報條目是否強制綁定去重後的原文出處與不確定性記錄,解説影片是否保留源時間映射;沒有出處錨定的生成文本不得進入審校隊列。
- 核查多語種版本的單一事實基準:確認多語種編譯流程是否以人工核驗過的事實為唯一輸入,且在發佈前設有人工審閲關口;任何被拒絕的譯本必須退回修訂,防止不同語種渠道出現口徑分裂。
- 核查歸因復盤的事件口徑與人工決策權:確認數據復盤能否嚴格區分淺層閲讀、訂閲登記與實際付費,並將渠道調整建議交由責任編輯審批,避免把短期點擊相關性直接當作自動排期指令。
覺得有用?分享給需要的人。
參考文獻
- [1]
Diakopoulos, N. (2019). Automating the News: How Algorithms Are Rewriting the Media. Harvard University Press. doi.org/10.4159/9780674239302
- [2]
Simon, H. A. (1971). Designing Organizations for an Information-Rich World. In M. Greenberger (Ed.), Computers, Communications, and the Public Interest (pp. 37–72). Johns Hopkins Press. gwern.net ↗
- [3]
Newman, N., Fletcher, R., Robertson, C. T., Arguedas, A. R., & Nielsen, R. K. (2024). Reuters Institute Digital News Report 2024. Reuters Institute for the Study of Journalism, University of Oxford. reutersinstitute.politics.ox.ac.uk ↗
相關能力
技能包
S20 · 智能感知
每日資訊簡報
每天需查閲數十個資訊源,重複多、有效少,轉述時還常遺漏出處。
自動採集並去重,提取事實與相關事件,經人工核實篩選後,生成可訂閲的每日簡報。
- 採集並去重
- 提取事實
- 關聯相關事件
- 核實並篩選人工複核
- 生成並發送
5 步1 處人工複核9 個組件
S31 · 智能感知
解説影片製作
一條講解影片需剪輯畫面、配置旁白、對齊時間,修改一處便需全部重新對齊。
按腳本製作畫面並剪輯,配上旁白與音樂並對齊時間,最後經人工試聽驗收。
- 準備場景畫面
- 剪輯成片
- 配旁白與音樂
- 試聽並驗收人工複核
4 步1 處人工複核7 個組件
S38 · 智能商務
多語言內容發佈
一篇內容需翻譯成多種語言並發布到網頁和社交渠道,版本一多便難以對應。
依據核實的事實撰稿,翻譯後逐一語種校對,事實與措辭經人工審批,再發布至網頁與選定渠道。
- 撰寫內容草稿
- 翻譯並校對
- 審閲事實與措辭人工複核
- 發佈至網頁與渠道
- 優化搜尋與分享
5 步1 處人工複核8 個組件
S39 · 智能商務
營銷活動復盤
活動結束後只看總數,難以判斷哪條內容、哪個渠道表現更好。
將訪問與轉化記錄對應到來源,比較各條內容的表現,起草下一輪調整方案,由人工確定排期。
- 對應來源與轉化
- 比較表現
- 起草調整方案
- 選定下一輪人工複核
- 排期並存檔
5 步1 處人工複核9 個組件