【法律】当“虚构判例”成为执业红线:原典检索锚定、受控桌面操作与可核对的案源证据备忘
实证研究显示,即便引入检索增强生成的商用法律检索工具仍会以不可忽视的比例产生幻觉;法律研究工作台应当把每条摘要与争点论据逐句锚定于获准原典,并在检索、操作与备忘归档环节设置强制人工复核关口,绝不自动出具法律意见。

格式逼真的引文草稿,为何成为法律执业的合规红线
设想这样一种办案场景:诉讼团队在庭审准备期内,借助生成式问答工具起草抗辩备忘录。工具很快给出了结构完整、逻辑连贯的法律检索初稿,列明了案号、法院名称与核心说理段落。然而当主办律师将引文逐一放到官方裁判文书库与法规库中核对时,却发现若干关键判例根本不存在,或者真实判决的裁判主旨与草稿结论截然相反。一旦这类未经核实的文本流入正式文书,执业律师面对的不仅是返工成本,更是直接触及法庭诚信与执业纪律的合规红线。
这一风险并不能靠简单更换专用检索产品来消除。实证研究显示,即使使用检索增强生成(RAG)的商用法律检索工具仍会虚构判例;法律工作台应做到逐句绑定原文,并由律师逐条批注签字,不出具自动法律意见。
从通用模型到专用法律检索:实证研究揭示的幻觉机制与监督责任
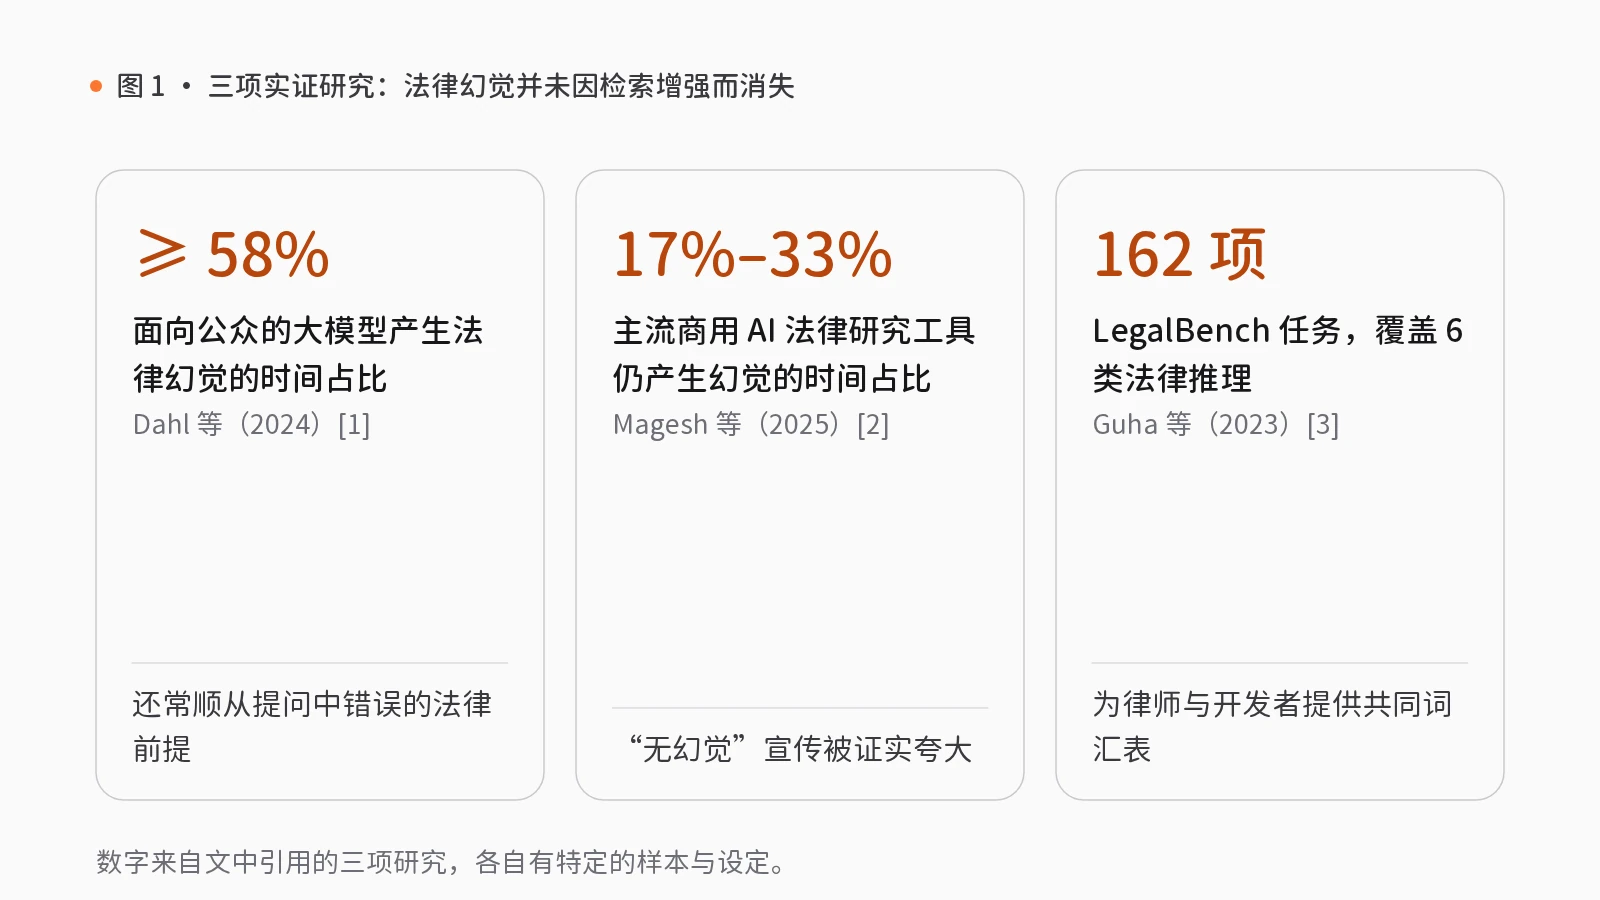
大模型在法律实务、法学教育与研究中的应用日益广泛,但其潜力正受到“法律幻觉”(即与法律事实不一致的文本输出)的直接威胁[1]。Dahl、Magesh、Suzgun 与 Ho(2024)针对面向公众的大模型开展了系统性实证检验,跨法域、法院层级、时间跨度与案件类型刻画了法律幻觉的分布特征[1]。研究发现,这类面向公众的大模型在至少 58% 的时间里会产生法律幻觉[1];更棘手的是,模型难以预测自身何时正在产生幻觉,并且常常不加批判地顺从用户在提问中暗含的错误法律前提[1]。作者据此建立了一套法律幻觉分类学,并明确警告不应在缺乏监督的情况下将通用大模型快速接入法律任务[1]。
面对通用模型的缺陷,部分法律检索供应商宣称检索增强生成(RAG)技术能够“消除”或“避免”幻觉,甚至承诺提供“无幻觉”(“hallucination-free”)的法律引证[2]。由于商用系统高度封闭,独立验证这类宣传颇具挑战[2]。Magesh、Surani、Dahl、Suzgun、Manning 与 Ho(2025)设计并报告了首个预先注册的商用 AI 法律研究工具实证评估,专门检验基于 RAG 的专有法律检索系统的真实表现[2]。评估证实供应商的宣传存在夸大:尽管幻觉比例较通用聊天模型有所下降,但主流法律信息供应商旗下的商用 AI 法律研究工具仍会在 17% 至 33% 的时间里产生幻觉,且各系统在响应性与准确率上差异显著[2]。该研究不仅提出了区分幻觉与准确法律回答的清晰分类标准及预注册评测数据集,更提供实证证据表明:法律专业人士在监督与核验 AI 输出上的职责,依然是负责任地将 AI 引入法律领域的核心未决问题[2]。
至于模型在底层究竟能执行何种类型的法律推理,Guha 等人(2023)构建了跨学科协作基准 LegalBench[3]。该基准由法律专业人士主导设计与手工编写,包含 162 项任务,覆盖 6 类不同的法律推理,并展示了常见的法律推理框架如何与具体任务对应,为律师与模型开发者提供共同词汇表[3]。研究团队据此对 20 个开源与商用大模型开展了实证评估[3]。综合上述研究可见,无论是通用对话模型还是接入专有数据库的 RAG 法律检索系统,都无法仅凭模型自身保证引证零差错。在法律场景中,原文锚定与执业人员的逐条核验是不可省略的制度约束。
原典锚定、受控操作与证据备忘:法律工作台的工程映射
将上述结论转化为系统架构,意味着法律研究工作台不能是直接吐出“法律意见书”的黑盒问答框,而应拆解为受权限约束的原文检索、争点比对与强制人工复核关口。在 rlab.works 的能力体系中,这一过程对应智能感知、模型网关与智能中枢模块下的相关组合技能包。
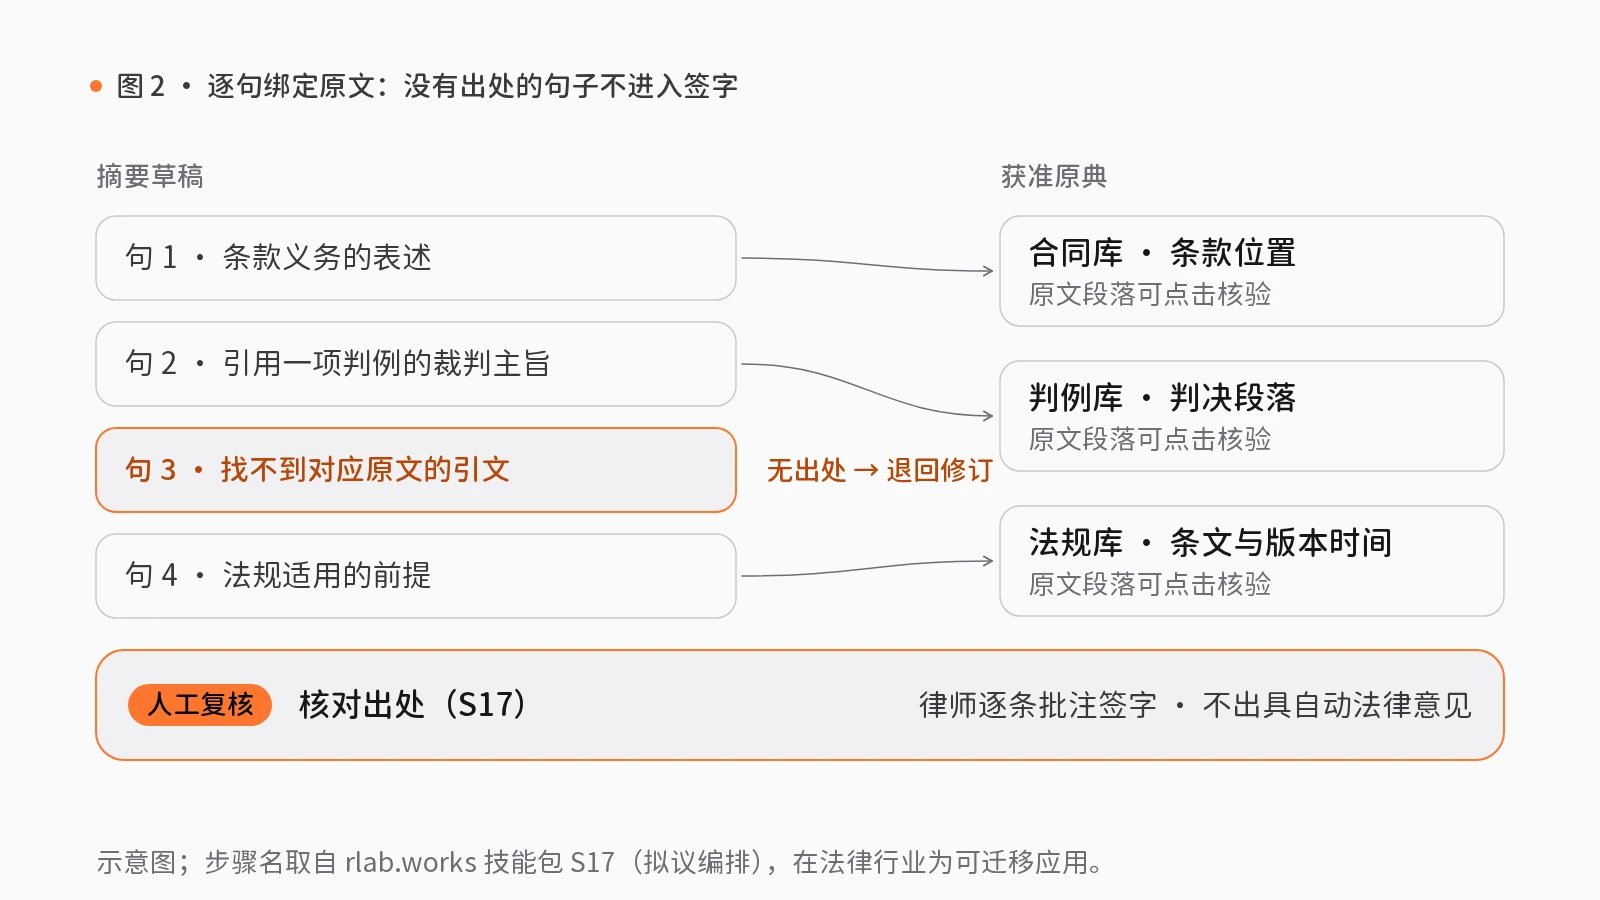
在条款与法规检索层,模型网关模块下的带出处的资料检索(S17)技能包以“问题、授权资料入口与搜索范围”为初始输入,先收集带来源的可用片段并建立按相关性排序的检索候选,再整理带片段引用的摘要草稿,最后停在“核对出处”人工复核关口,由复核人确认摘要与证据包,被拒绝的产出退回修订且不进入下一步。在法律场景中,该流程可将授权合同库接入条款检索,让摘要保留原文位置供法务逐条检查出处。
在桌面案卷整理环节,智能中枢模块下的经审批的电脑操作(S03)技能包以“操作目标、账号和允许修改的资料”为输入,检查会话就绪后在“审批操作清单”人工关口等待批准;获批后通过带权限门槛的原生电脑控制组件执行动作并保留截图、文件差异与执行回执,最后在“检查改动”关口由人工复核变更与异常记录。
需如实说明能力边界与适配要求。在 rlab.works 目录中,法律行业目前没有任何“源数据有行业依据”的技能包,上述技能包在法律行业均属“可迁移应用”,且站点所有技能包均为拟议编排,仅以合成数据走查演示,尚未接入真实服务;组件成熟度来自静态源码检查而非生产部署。将其迁移到法律场景须完成以下领域适配:
- 在「带出处的资料检索(S17)」中,须接入文档权限与条款位置,摘要服务的输出不可自行充当法律意见;
- 在「研究报告撰写(S24)」中,需替换论文入口与新闻主题模型,核对法规效力和案件适用性,不自动作法律结论;
- 在「正反证据备忘(S25)」中,须把原有的披露、行情和公司模型整体替换成案卷、法条、当事方与时间线,原评分不可移作法律判断;
- 在「经审批的电脑操作(S03)」中,须逐项限制读取与修改目录,对外提交不在本流程默认权限内。
律所与企业法务部门在启动试点前的管理检验
律所合伙人、企业总法律顾问(GC)或合规负责人在批准法律 AI 试点前,可以用以下几项具体标准检验系统设计是否越过了执业安全线:
- 引文是否强绑定到获准原典的具体位置? 检查系统是否限制在获准的法规库、判例库与内部合同库内检索,且每句摘要都附带可点击核验的原文段落与版本时间戳,拒绝任何无法回溯出处的自由生成文本。
- 是否将支持证据、反证与未决前提显式并列? 鉴于模型倾向于顺从提问者暗含的错误法律前提[1],工作台应强制区分支持材料、反对材料与待查清事实,防止单边迎合式的检索报告误导办案方向。
- 签字复核与外部提交的阻断机制是否真实有效? 确认每一份检索摘要、案卷文件改动与证据备忘都必须经持证律师或指定法务人工复核签字后才能归档,且系统在架构层面上禁止自动对外发送或提交任何法律意见。
觉得有用?分享给需要的人。
参考文献
- [1]
Dahl, M., Magesh, V., Suzgun, M., & Ho, D. E. (2024). Large Legal Fictions: Profiling Legal Hallucinations in Large Language Models. Journal of Legal Analysis, 16(1), 64–93. doi.org/10.1093/jla/laae003
- [2]
Magesh, V., Surani, F., Dahl, M., Suzgun, M., Manning, C. D., & Ho, D. E. (2025). Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools. Journal of Empirical Legal Studies, 22(2), 216–242 (arXiv:2405.20362, 2024). doi.org/10.1111/jels.12413
- [3]
Guha, N., Nyarko, J., Ho, D. E., Ré, C., Chilton, A., Narayana, A., Chohlas-Wood, A., Peters, A., Waldon, B., Rockmore, D. N., Zambrano, D., Talisman, D., Hoque, E., Surani, F., Fagan, F., Sarfaty, G., Dickinson, G. M., Porat, H., Hegland, J., … Li, Z. (2023). LegalBench: A Collaboratively Built Benchmark for Measuring Legal Reasoning in Large Language Models. Advances in Neural Information Processing Systems, 36 (Datasets and Benchmarks Track). arxiv.org ↗
相关能力
技能包
S24 · 智能感知
研究报告撰写
撰写研究报告时,大量时间用于查找资料、核对引用,仍难以说清每句话的出处。
先拆解研究问题,收集材料并标注出处,撰写带引用的草稿,论据经人工核对后排版导出。
- 拆解问题与范围
- 收集材料
- 撰写引用草稿
- 核对论据人工复核
- 排版并导出
5 步1 处人工复核8 个组件
S17 · 模型网关
带出处的资料检索
AI 的回答看似完整,却说不清出处,难以直接采用。
仅从授权资料中检索相关段落,摘要标明所引用的段落,经人工核对出处后使用。
- 收集可查资料
- 检索相关段落
- 撰写摘要
- 核对出处人工复核
4 步1 处人工复核5 个组件

S03 · 智能中枢
经审批的电脑操作
后台录入、填表、修改文件等重复操作希望交由 AI 执行,又担心误操作。
AI 先列出操作位置与修改内容,经批准后执行;每一步均保留截图与改动记录。
- 准备账号与登录
- 审批操作清单人工复核
- 执行并截图
- 检查改动人工复核
4 步2 处人工复核8 个组件
S25 · 智能感知
正反证据备忘
研究判断只记录结论,一段时间后难以说清当初的依据与反对意见。
将资料、论点与反证集中记录,标明支持、反对与存疑,经人工复核后存为可追溯的备忘。
- 收集证据
- 梳理对象与关系
- 对照正反证据
- 定稿备忘人工复核
4 步1 处人工复核8 个组件