【法律】當「虛構判例」成為執業紅線:原典檢索錨定、受控桌面操作與可核對的案源證據備忘
實證研究顯示,即便引入檢索增強生成的商用法律檢索工具仍會以不可忽視的比例產生幻覺;法律研究工作台應當把每條摘要與爭點論據逐句錨定於獲准原典,並在檢索、操作與備忘歸檔環節設定強制人工複核關口,絕不自動出具法律意見。

格式逼真的引文草稿,為何成為法律執業的合規紅線
設想這樣一種辦案場景:訴訟團隊在庭審準備期內,藉助生成式問答工具起草抗辯備忘錄。工具很快給出了結構完整、邏輯連貫的法律檢索初稿,列明瞭案號、法院名稱與核心説理段落。然而當主辦律師將引文逐一放到官方裁判文書庫與法規庫中核對時,卻發現若干關鍵判例根本不存在,或者真實判決的裁判主旨與草稿結論截然相反。一旦這類未經核實的文本流入正式文書,執業律師面對的不僅是返工成本,更是直接觸及法庭誠信與執業紀律的合規紅線。
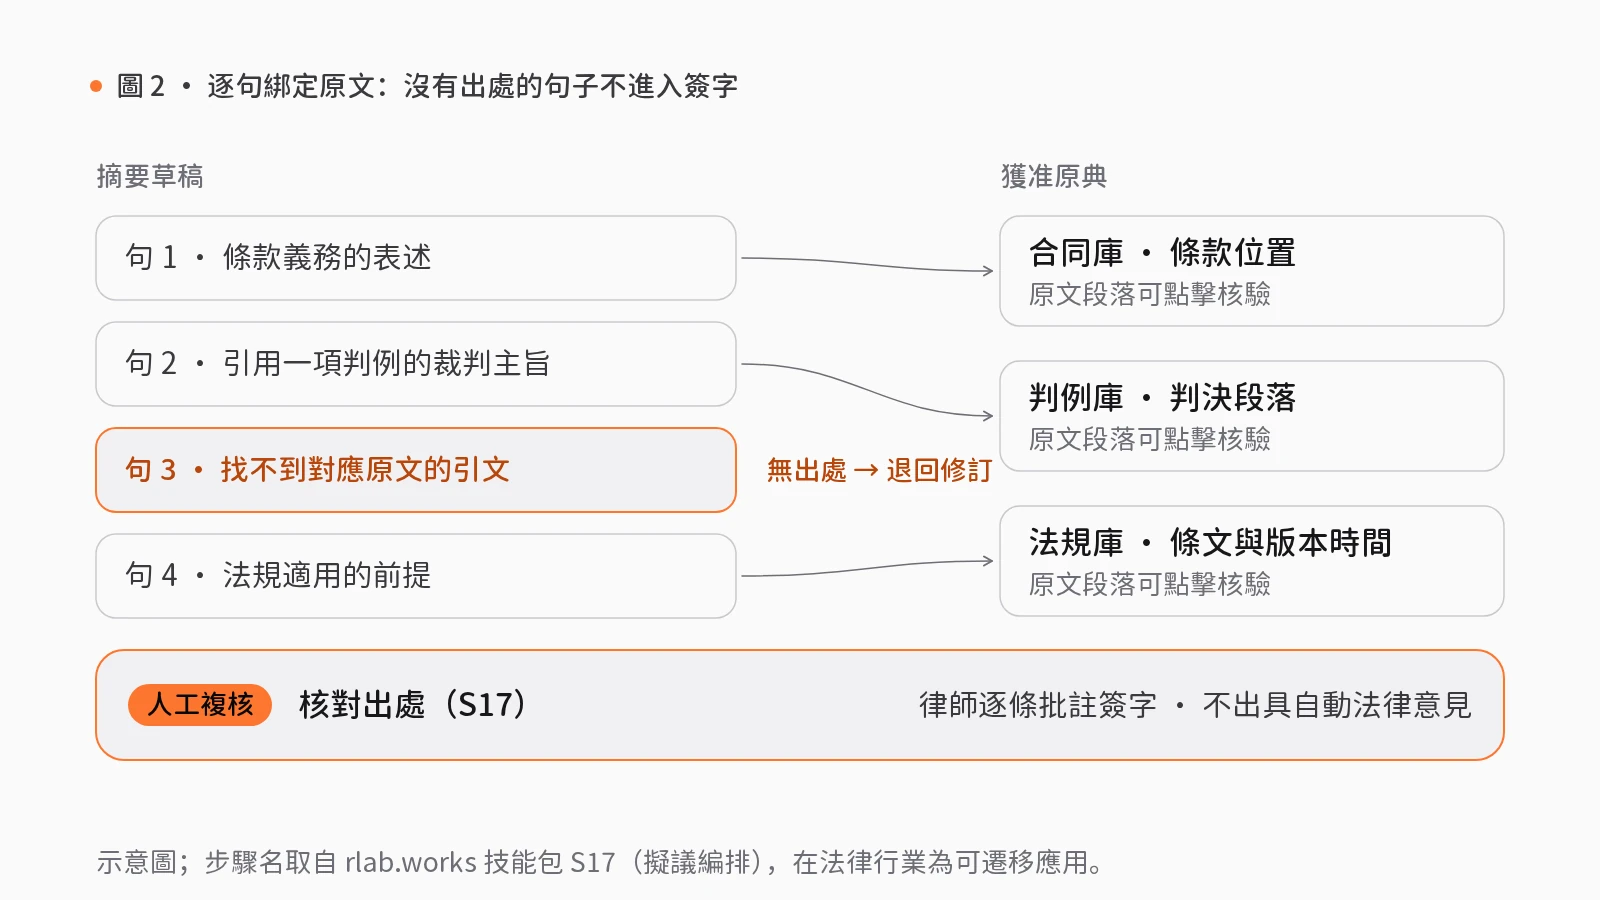
這一風險並不能靠簡單更換專用檢索產品來消除。實證研究顯示,即使使用檢索增強生成(RAG)的商用法律檢索工具仍會虛構判例;法律工作台應做到逐句綁定原文,並由律師逐條批註簽字,不出具自動法律意見。
從通用模型到專用法律檢索:實證研究揭示的幻覺機制與監督責任
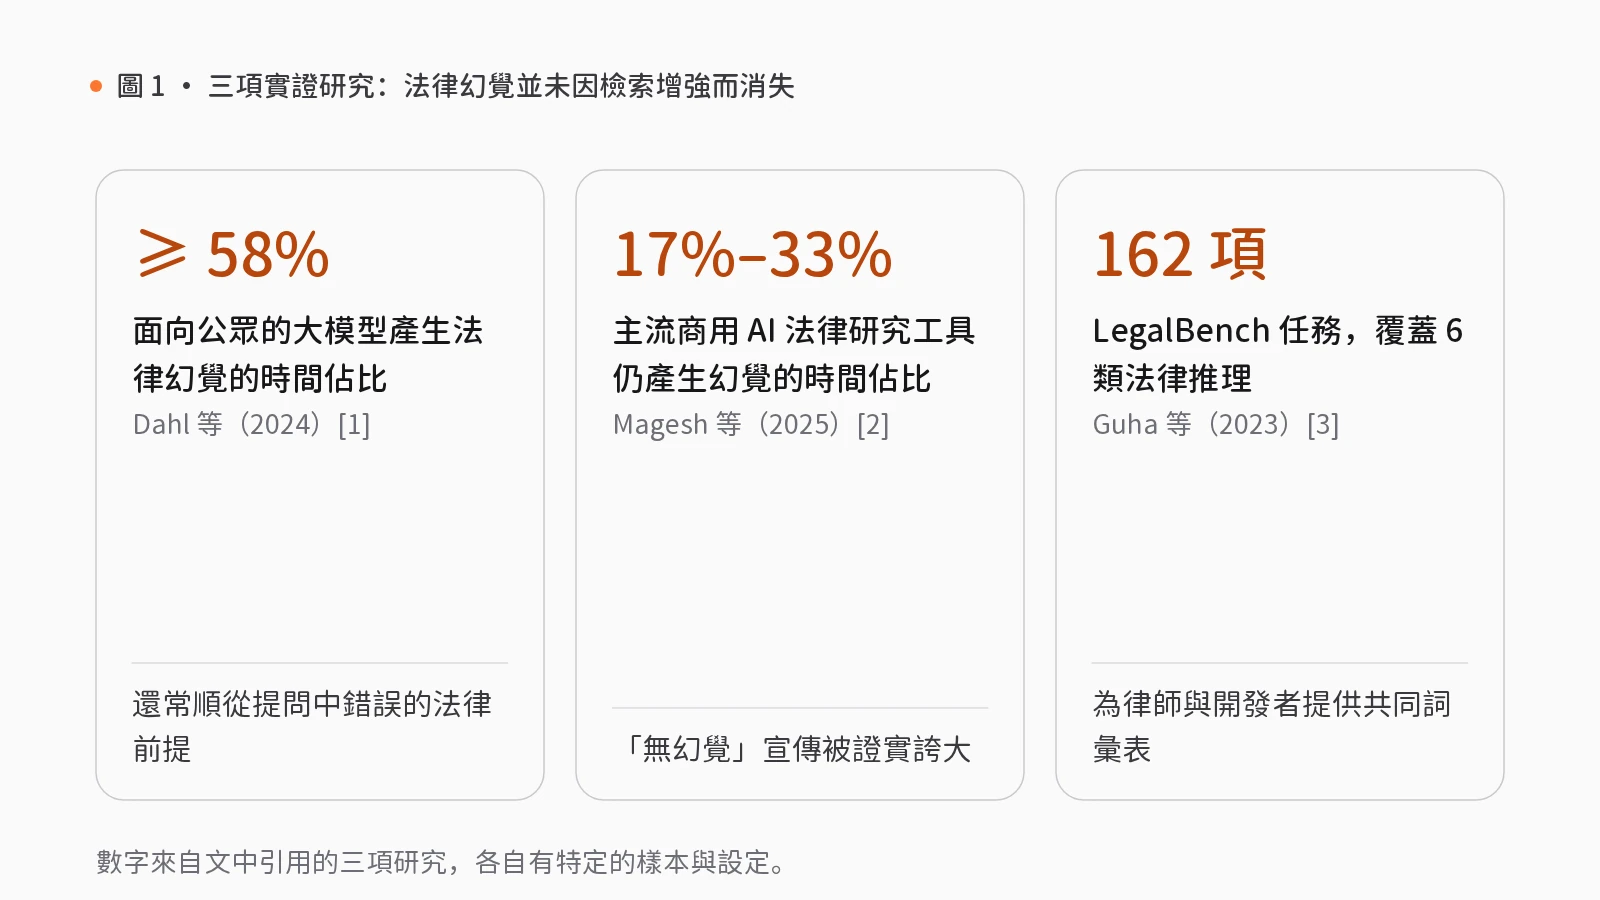
大模型在法律實務、法學教育與研究中的應用日益廣泛,但其潛力正受到「法律幻覺」(即與法律事實不一致的文本輸出)的直接威脅[1]。Dahl、Magesh、Suzgun 與 Ho(2024)針對面向公眾的大模型開展了系統性實證檢驗,跨法域、法院層級、時間跨度與案件類型刻畫了法律幻覺的分佈特徵[1]。研究發現,這類面向公眾的大模型在至少 58% 的時間裏會產生法律幻覺[1];更棘手的是,模型難以預測自身何時正在產生幻覺,並且常常不加批判地順從用戶在提問中暗含的錯誤法律前提[1]。作者據此建立了一套法律幻覺分類學,並明確警告不應在缺乏監督的情況下將通用大模型快速接入法律任務[1]。
面對通用模型的缺陷,部分法律檢索供應商宣稱檢索增強生成(RAG)技術能夠「消除」或「避免」幻覺,甚至承諾提供「無幻覺」(“hallucination-free”)的法律引證[2]。由於商用系統高度封閉,獨立驗證這類宣傳頗具挑戰[2]。Magesh、Surani、Dahl、Suzgun、Manning 與 Ho(2025)設計並報告了首個預先註冊的商用 AI 法律研究工具實證評估,專門檢驗基於 RAG 的專有法律檢索系統的真實表現[2]。評估證實供應商的宣傳存在誇大:儘管幻覺比例較通用聊天模型有所下降,但主流法律資訊供應商旗下的商用 AI 法律研究工具仍會在 17% 至 33% 的時間裏產生幻覺,且各系統在響應性與準確率上差異顯著[2]。該研究不僅提出了區分幻覺與準確法律回答的清晰分類標準及預註冊評測數據集,更提供實證證據表明:法律專業人士在監督與核驗 AI 輸出上的職責,依然是負責任地將 AI 引入法律領域的核心未決問題[2]。
至於模型在底層究竟能執行何種類型的法律推理,Guha 等人(2023)構建了跨學科協作基準 LegalBench[3]。該基準由法律專業人士主導設計與手工編寫,包含 162 項任務,覆蓋 6 類不同的法律推理,並展示了常見的法律推理框架如何與具體任務對應,為律師與模型開發者提供共同詞彙表[3]。研究團隊據此對 20 個開源與商用大模型開展了實證評估[3]。綜合上述研究可見,無論是通用對話模型還是接入專有數據庫的 RAG 法律檢索系統,都無法僅憑模型自身保證引證零差錯。在法律場景中,原文錨定與執業人員的逐條核驗是不可省略的制度約束。
原典錨定、受控操作與證據備忘:法律工作台的工程映射
將上述結論轉化為系統架構,意味着法律研究工作台不能是直接吐出「法律意見書」的黑盒問答框,而應拆解為受權限約束的原文檢索、爭點比對與強制人工複核關口。在 rlab.works 的能力體系中,這一過程對應智能感知、模型網關與智能中樞模組下的相關組合技能包。
在條款與法規檢索層,模型網關模組下的帶出處的資料檢索(S17)技能包以「問題、授權資料入口與搜尋範圍」為初始輸入,先收集帶來源的可用片段並建立按相關性排序的檢索候選,再整理帶片段引用的摘要草稿,最後停在「核對出處」人工複核關口,由複核人確認摘要與證據包,被拒絕的產出退回修訂且不進入下一步。在法律場景中,該流程可將授權合同庫接入條款檢索,讓摘要保留原文位置供法務逐條檢查出處。
在桌面案卷整理環節,智能中樞模組下的經審批的電腦操作(S03)技能包以「操作目標、帳戶和允許修改的資料」為輸入,檢查會話就緒後在「審批操作清單」人工關口等待批准;獲批後通過帶權限門檻的原生電腦控制組件執行動作並保留截圖、文件差異與執行回執,最後在「檢查改動」關口由人工複核變更與異常記錄。
需如實説明能力邊界與適配要求。在 rlab.works 目錄中,法律行業目前沒有任何「源數據有行業依據」的技能包,上述技能包在法律行業均屬「可遷移應用」,且站點所有技能包均為擬議編排,僅以合成數據走查演示,尚未接入真實服務;組件成熟度來自靜態源碼檢查而非生產部署。將其遷移到法律場景須完成以下領域適配:
- 在「帶出處的資料檢索(S17)」中,須接入文檔權限與條款位置,摘要服務的輸出不可自行充當法律意見;
- 在「研究報告撰寫(S24)」中,需替換論文入口與新聞主題模型,核對法規效力和案件適用性,不自動作法律結論;
- 在「正反證據備忘(S25)」中,須把原有的披露、行情和公司模型整體替換成案卷、法條、當事方與時間線,原評分不可移作法律判斷;
- 在「經審批的電腦操作(S03)」中,須逐項限制讀取與修改目錄,對外提交不在本流程預設權限內。
律所與企業法務部門在啓動試點前的管理檢驗
律所合夥人、企業總法律顧問(GC)或合規負責人在批准法律 AI 試點前,可以用以下幾項具體標準檢驗系統設計是否越過了執業安全線:
- 引文是否強綁定到獲准原典的具體位置? 檢查系統是否限制在獲准的法規庫、判例庫與內部合同庫內檢索,且每句摘要都附帶可點擊核驗的原文段落與版本時間戳,拒絕任何無法回溯出處的自由生成文本。
- 是否將支援證據、反證與未決前提顯式並列? 鑑於模型傾向於順從提問者暗含的錯誤法律前提[1],工作台應強制區分支援材料、反對材料與待查清事實,防止單邊迎合式的檢索報告誤導辦案方向。
- 簽字複核與外部提交的阻斷機制是否真實有效? 確認每一份檢索摘要、案卷文件改動與證據備忘都必須經持證律師或指定法務人工複核簽字後才能歸檔,且系統在架構層面上禁止自動對外發送或提交任何法律意見。
覺得有用?分享給需要的人。
參考文獻
- [1]
Dahl, M., Magesh, V., Suzgun, M., & Ho, D. E. (2024). Large Legal Fictions: Profiling Legal Hallucinations in Large Language Models. Journal of Legal Analysis, 16(1), 64–93. doi.org/10.1093/jla/laae003
- [2]
Magesh, V., Surani, F., Dahl, M., Suzgun, M., Manning, C. D., & Ho, D. E. (2025). Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools. Journal of Empirical Legal Studies, 22(2), 216–242 (arXiv:2405.20362, 2024). doi.org/10.1111/jels.12413
- [3]
Guha, N., Nyarko, J., Ho, D. E., Ré, C., Chilton, A., Narayana, A., Chohlas-Wood, A., Peters, A., Waldon, B., Rockmore, D. N., Zambrano, D., Talisman, D., Hoque, E., Surani, F., Fagan, F., Sarfaty, G., Dickinson, G. M., Porat, H., Hegland, J., … Li, Z. (2023). LegalBench: A Collaboratively Built Benchmark for Measuring Legal Reasoning in Large Language Models. Advances in Neural Information Processing Systems, 36 (Datasets and Benchmarks Track). arxiv.org ↗
相關能力
技能包
S24 · 智能感知
研究報告撰寫
撰寫研究報告時,大量時間用於查找資料、核對引用,仍難以説清每句話的出處。
先拆解研究問題,收集材料並標註出處,撰寫帶引用的草稿,論據經人工核對後排版匯出。
- 拆解問題與範圍
- 收集材料
- 撰寫引用草稿
- 核對論據人工複核
- 排版並匯出
5 步1 處人工複核8 個組件
S17 · 模型網關
帶出處的資料檢索
AI 的回答看似完整,卻説不清出處,難以直接採用。
僅從授權資料中檢索相關段落,摘要標明所引用的段落,經人工核對出處後使用。
- 收集可查資料
- 檢索相關段落
- 撰寫摘要
- 核對出處人工複核
4 步1 處人工複核5 個組件

S03 · 智能中樞
經審批的電腦操作
後台錄入、填表、修改文件等重複操作希望交由 AI 執行,又擔心誤操作。
AI 先列出操作位置與修改內容,經批准後執行;每一步均保留截圖與改動記錄。
- 準備帳戶與登入
- 審批操作清單人工複核
- 執行並截圖
- 檢查改動人工複核
4 步2 處人工複核8 個組件
S25 · 智能感知
正反證據備忘
研究判斷只記錄結論,一段時間後難以説清當初的依據與反對意見。
將資料、論點與反證集中記錄,標明支援、反對與存疑,經人工複核後存為可追溯的備忘。
- 收集證據
- 梳理對象與關係
- 對照正反證據
- 定稿備忘人工複核
4 步1 處人工複核8 個組件