超越刷榜评测:从静态基准(Benchmarks)到生产环境影子评测与任务级校验
公开榜单分数不能代表企业私有任务上的表现;选型应把多维评测、影子流量对比与按任务路由结合起来,用固定评分标准验收。
榜单高分与私有任务失灵:模型选型的常见落差
设想这样一种情形:某企业技术团队依据公开评测榜单的综合排名,采购并替换了内部知识检索与工单结构化抽取接口。在演示环境中,新模型的自由问答流畅自然;然而一旦切入生产流量,涉及企业私有接口格式、多轮追问抗干扰以及特定否定句式的抽取任务便频繁报错,同时响应延迟与调用成本也超出预期,团队不得不紧急回滚配置。
这一落差揭示了企业选型中的核心方法论问题:公开榜单分数不能代表企业私有任务上的表现;选型应把多维评测、影子流量对比与按任务路由结合起来,用固定评分标准验收。把单一静态基准上的准确率排名直接等同于生产就绪度,往往会掩盖可靠性、成本与特定任务边界上的短板。
为什么静态单一准确率不足以支撑选型:多维衡量、偏好评审与行为测试
围绕语言模型评测的学术研究,从场景覆盖、开放式偏好与细粒度行为边界等维度揭示了静态单一指标的局限。
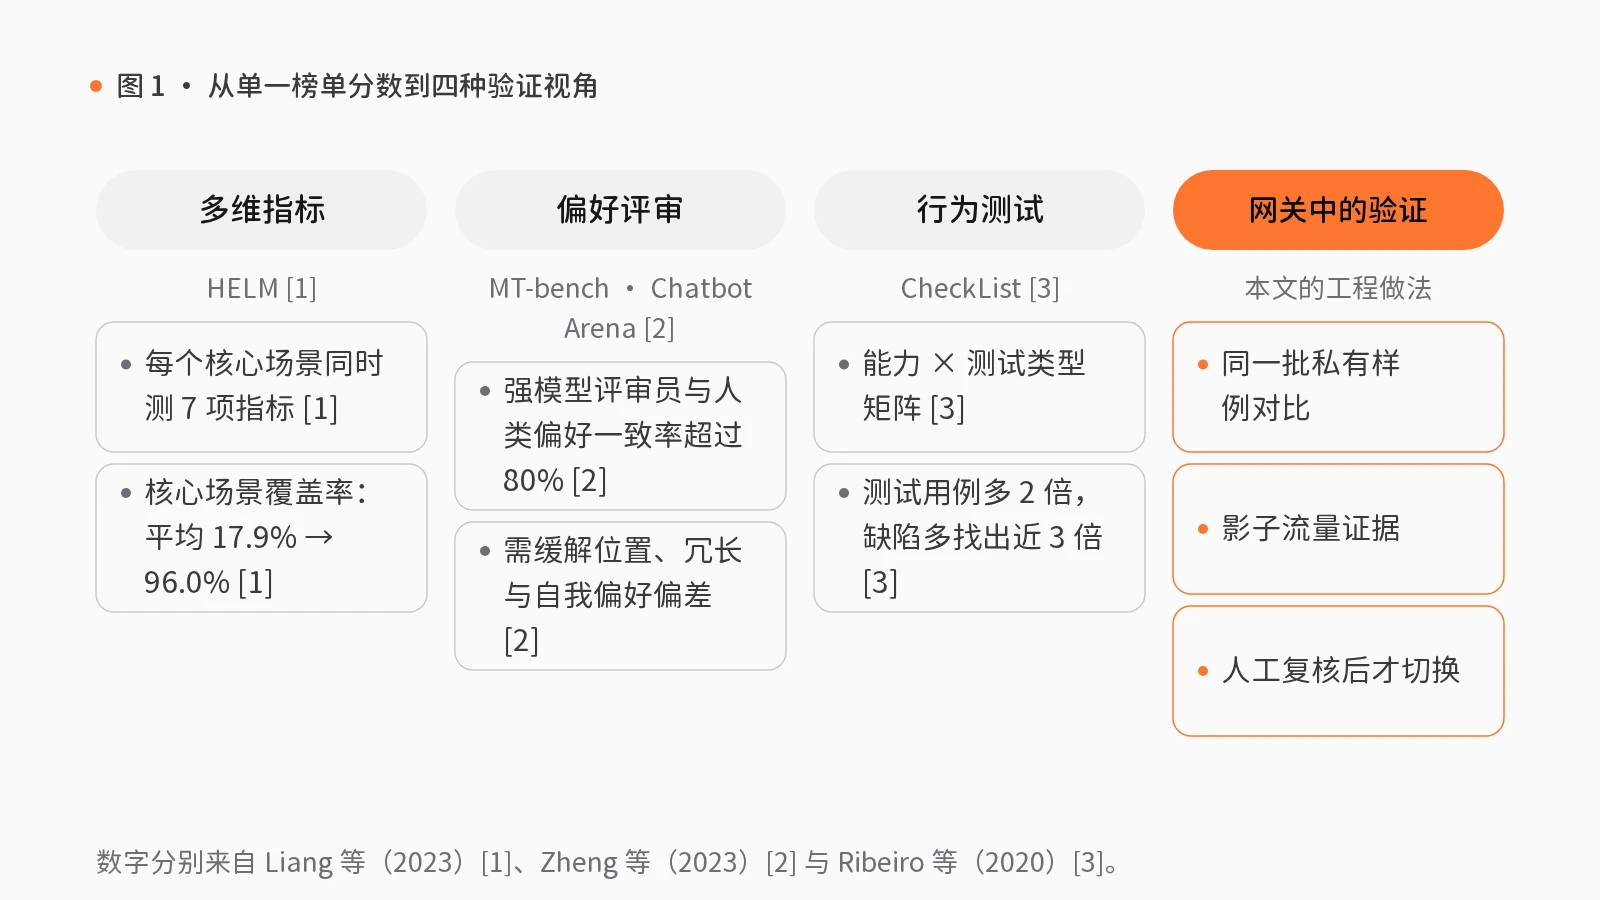
首先是评测场景稀疏与多维权衡缺失。Liang 等人(2023)提出语言模型整体评测框架(HELM)以提升模型透明度[1]。在 HELM 之前,主流模型平均仅在核心场景的 17.9% 上接受过评测,部分重要模型之间甚至没有任何共同评测场景[1]。为此,研究者对潜在场景与指标进行分类筛选,并在尽可能的情况下(占 87.5% 的情形)对 16 个核心场景同时测量 7 项指标(准确率、校准度、鲁棒性、公平性、偏见、毒性与效率)[1],确保准确率之外的指标不被忽视,并清晰暴露权衡关系[1]。他们还基于 26 个专项场景开展 7 项专项评估(分析推理、虚假信息等特定方面)[1],并在统一标准下对 30 个代表性语言模型(含开放、受限访问与封闭模型)在全部 42 个场景上进行密集基准测试——其中 21 个场景此前未用于主流评测——将核心场景覆盖率提升至 96.0%,提炼出 25 项核心发现[1]。这表明脱离多维指标的单一准确率,无法反映具体场景中的真实权衡。
其次是开放式任务与人类偏好的对齐难题。Zheng 等人(2023)指出,由于基于大模型的对话助手能力广泛,现有基准在衡量人类偏好上存在不足[2]。研究者探索用强语言模型作为评审员(LLM-as-a-judge)评估开放式问题,考察了位置偏差、冗长偏差、自我偏好偏差及有限推理能力等局限并提出缓解方案[2]。通过引入两项基准——多轮问题集 MT-bench 与众包对战平台 Chatbot Arena——并公开 3K 专家投票与 30K 含人类偏好的对话数据[2],他们验证了模型评审员与人类偏好的一致性:强语言模型评审员能较好匹配受控与众包下的人类偏好,达成超过 80% 的一致率,与人类评估者之间的一致水平相当[2]。对多个模型变体的评估同时表明,开放式偏好基准与传统基准互为补充[2]。
最后是留出集准确率(held-out accuracy)对泛化能力的高估。Ribeiro 等人(2020)借鉴软件工程行为测试原则,提出任务无关的测试方法论 CheckList[3]。研究者指出,留出集准确率常高估模型表现,而其他方法往往只关注单一任务或特定行为[3]。CheckList 构建通用语言能力与测试类型矩阵并配套用例生成工具,在涵盖 3 项任务的测试中识别出商用与前沿模型的关键失效[3];在一项用户研究中,某商用情感分析模型团队借此在已广泛测试的模型中发现了新的可修复缺陷[3];在另一项用户研究中,使用 CheckList 的从业者比未使用者多创建 2 倍测试用例,找出近 3 倍缺陷[3]。
把评测嵌入网关工程:样例契约、影子比对与人工复核关口
上述研究共同指向一个工程结论:模型选型与切换须转化为持续验证的网关流程。在 rlab.works 的模型网关模块中,这一方法论落地为明确契约、辅助评测与人工关口。
在模型接入阶段,技能包新服务试运行接入(S18)以“服务地址、授权信息与接口约定”为初始输入:
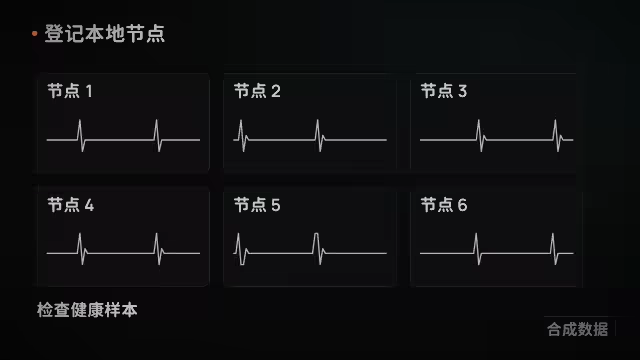
- 登记服务节点(辅助执行):登记服务节点,输出已登记节点和健康状态。
- 配置调用方式(辅助执行):生成待验收的客户端和接口配置。
- 少量试运行(辅助执行):发送有界测试请求,记录响应和类型化错误。
- 接入或回退(人工复核):由指定复核人或请求用户审阅;被拒绝的输出退回修订且不进入下一步,通过后留存人工确认的接入版本与发布记录。
候选服务通过验收后,技能包模型对比与切换(S12)以“任务样例、可用服务和选择标准”为输入执行对比与切换:
- 检查可选模型(辅助执行):核验可调用服务与测试配置。
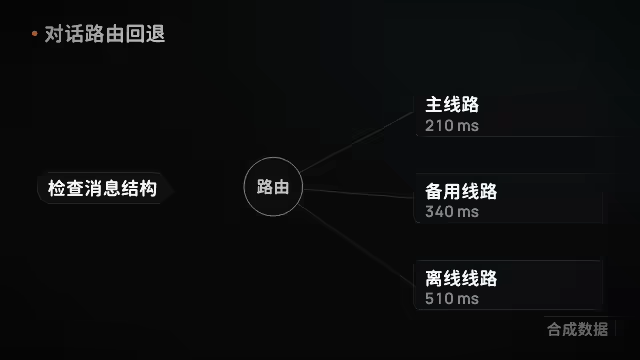
- 样例对比(辅助执行):依托模型对比与影子评估(在数据集上比较主模型与候选模型,可选用模型评审,收集影子流量和路由反馈证据)与任务感知的模型路由与结构化评测(按顺序回退,选择已配置的任务档位,并用确定性测试样本校验结构化输出),产出质量、错误与费用比较记录。
- 审阅切换建议(人工复核):经路由建议审阅列出已保存的路由建议供人工复核;被拒绝的输出退回修订且不进入下一步,通过后形成人工接受的路由草案。
- 设定主备模型(辅助执行):配置主备路由和额度规则。
- 切换后抽查(人工复核):切换后人工复核样例,留存比较证据与保留决定。
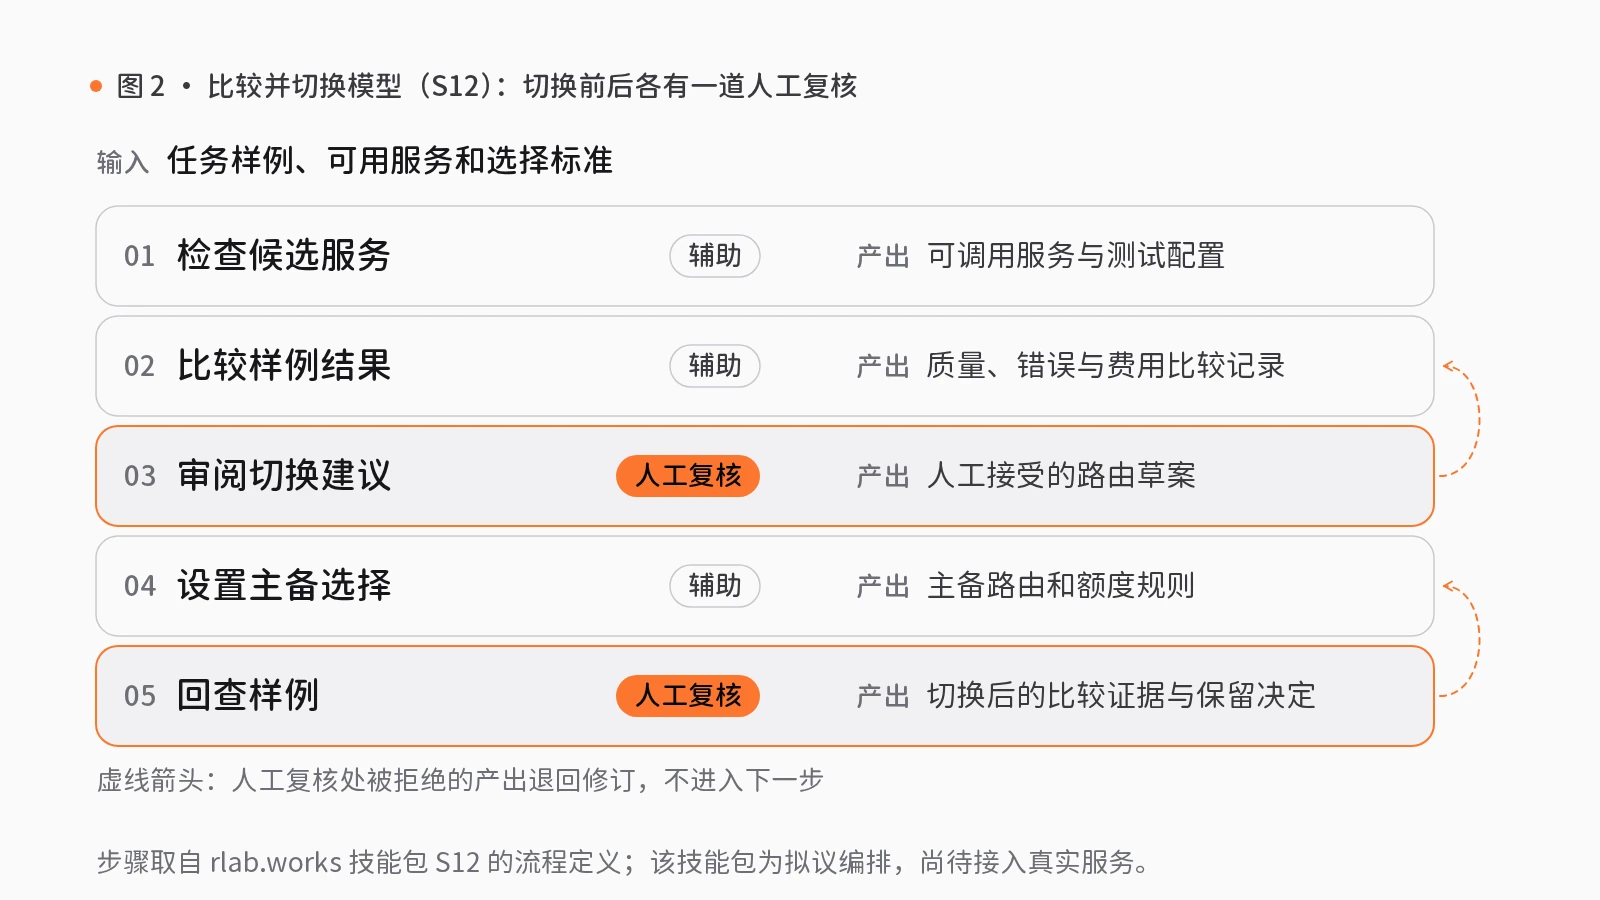
此外,站点所有技能包目前均为拟议编排,仅通过合成数据演示,尚未接入真实服务。文中涉及的原子组件虽为可运行代码,但成熟度仅基于静态源码检查而非生产部署:任务感知的模型路由与结构化评测仅将逻辑档位映射到已配置模型,并非多供应商计费网关;路由建议审阅仅支持将已保存建议应用到策略草稿或忽略,所检查的服务中未确认存在自动生成建议的功能。
资助模型选型与替换试点前的管理检验
企业负责人或首席架构师在批准模型替换或路由试点前,可按以下标准检验方案:
- 是否以多维指标与行为清单替代单一榜单排名? 检查是否针对私有任务定义了涵盖准确率、效率、鲁棒性与结构化格式的固定评分标准,并构建边界测试用例集。
- 切换前是否具备同源样例与影子流量证据? 要求候选服务与现有主模型在同一批私有样例或影子流量上对比,输出质量、类型化错误与费用记录。
- 接入验收与路由切换是否设有具阻断权的人工关口? 确认新节点放行与主备切换均经人工复核并留存回查证据,未经接受的建议不得自动生效。
觉得有用?分享给需要的人。
参考文献
- [1]
Liang, P., Bommasani, R., Lee, T., Tsipras, D., Soylu, D., Yasunaga, M., Zhang, Y., Narayanan, D., Wu, Y., Kumar, A., Newman, B., Yuan, B., Yan, B., Zhang, C., Cosgrove, C., Manning, C. D., Ré, C., Acosta-Navas, D., Hudson, D. A., ... Koreeda, Y. (2023). Holistic Evaluation of Language Models. Transactions on Machine Learning Research (TMLR). arxiv.org ↗
- [2]
Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., Lin, Z., Li, Z., Li, D., Xing, E. P., Zhang, H., Gonzalez, J. E., & Stoica, I. (2023). Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. Advances in Neural Information Processing Systems (NeurIPS), 36. arxiv.org ↗
- [3]
Ribeiro, M. T., Wu, T., Guestrin, C., & Singh, S. (2020). Beyond Accuracy: Behavioral Testing of NLP Models with CheckList. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics (ACL), 4902–4912. doi.org/10.18653/v1/2020.acl-main.442