超越刷榜評測:從靜態基準(Benchmarks)到生產環境影子評測與任務級校驗
公開榜單分數不能代表企業私有任務上的表現;選型應把多維評測、影子流量對比與按任務路由結合起來,用固定評分標準驗收。
榜單高分與私有任務失靈:模型選型的常見落差
設想這樣一種情形:某企業技術團隊依據公開評測榜單的綜合排名,採購並替換了內部知識檢索與工單結構化抽取接口。在演示環境中,新模型的自由問答流暢自然;然而一旦切入生產流量,涉及企業私有接口格式、多輪追問抗干擾以及特定否定句式的抽取任務便頻繁報錯,同時響應延遲與調用成本也超出預期,團隊不得不緊急回滾配置。
這一落差揭示了企業選型中的核心方法論問題:公開榜單分數不能代表企業私有任務上的表現;選型應把多維評測、影子流量對比與按任務路由結合起來,用固定評分標準驗收。把單一靜態基準上的準確率排名直接等同於生產就緒度,往往會掩蓋可靠性、成本與特定任務邊界上的短板。
為什麼靜態單一準確率不足以支撐選型:多維衡量、偏好評審與行為測試
圍繞語言模型評測的學術研究,從場景覆蓋、開放式偏好與細粒度行為邊界等維度揭示了靜態單一指標的侷限。
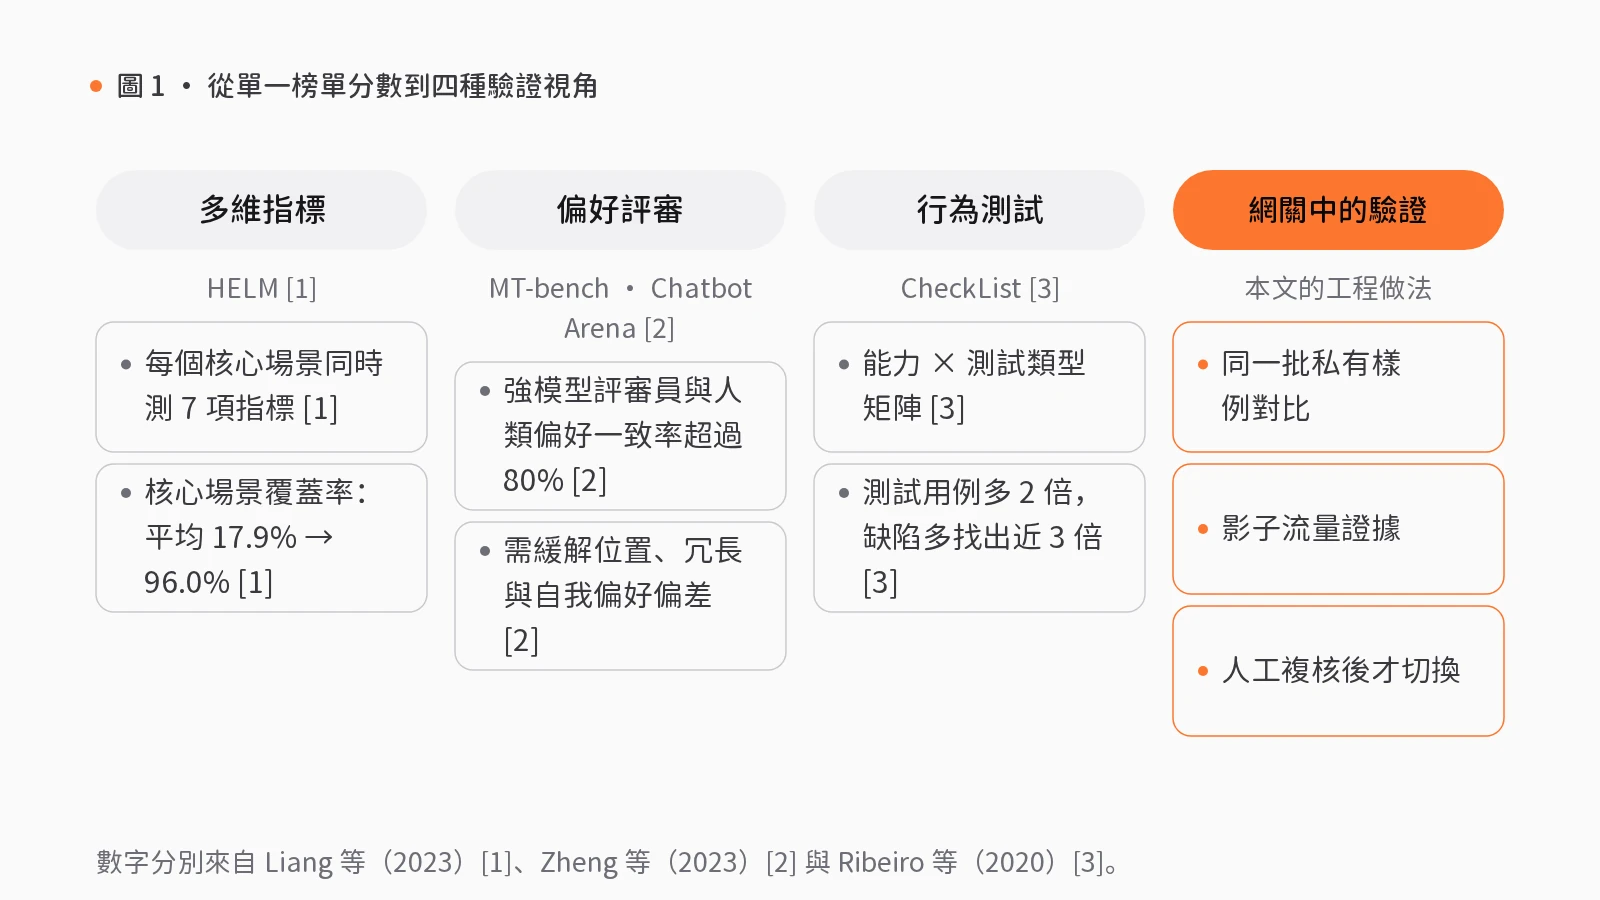
首先是評測場景稀疏與多維權衡缺失。Liang 等人(2023)提出語言模型整體評測框架(HELM)以提升模型透明度[1]。在 HELM 之前,主流模型平均僅在核心場景的 17.9% 上接受過評測,部分重要模型之間甚至沒有任何共同評測場景[1]。為此,研究者對潛在場景與指標進行分類篩選,並在儘可能的情況下(佔 87.5% 的情形)對 16 個核心場景同時測量 7 項指標(準確率、校準度、魯棒性、公平性、偏見、毒性與效率)[1],確保準確率之外的指標不被忽視,並清晰暴露權衡關係[1]。他們還基於 26 個專項場景開展 7 項專項評估(分析推理、虛假資訊等特定方面)[1],並在統一標準下對 30 個代表性語言模型(含開放、受限訪問與封閉模型)在全部 42 個場景上進行密集基準測試——其中 21 個場景此前未用於主流評測——將核心場景覆蓋率提升至 96.0%,提煉出 25 項核心發現[1]。這表明脱離多維指標的單一準確率,無法反映具體場景中的真實權衡。
其次是開放式任務與人類偏好的對齊難題。Zheng 等人(2023)指出,由於基於大模型的對話助手能力廣泛,現有基準在衡量人類偏好上存在不足[2]。研究者探索用強語言模型作為評審員(LLM-as-a-judge)評估開放式問題,考察了位置偏差、冗長偏差、自我偏好偏差及有限推理能力等侷限並提出緩解方案[2]。通過引入兩項基準——多輪問題集 MT-bench 與眾包對戰平台 Chatbot Arena——並公開 3K 專家投票與 30K 含人類偏好的對話數據[2],他們驗證了模型評審員與人類偏好的一致性:強語言模型評審員能較好匹配受控與眾包下的人類偏好,達成超過 80% 的一致率,與人類評估者之間的一致水平相當[2]。對多個模型變體的評估同時表明,開放式偏好基準與傳統基準互為補充[2]。
最後是留出集準確率(held-out accuracy)對泛化能力的高估。Ribeiro 等人(2020)借鑑軟件工程行為測試原則,提出任務無關的測試方法論 CheckList[3]。研究者指出,留出集準確率常高估模型表現,而其他方法往往只關注單一任務或特定行為[3]。CheckList 構建通用語言能力與測試類型矩陣並配套用例生成工具,在涵蓋 3 項任務的測試中識別出商用與前沿模型的關鍵失效[3];在一項用戶研究中,某商用情感分析模型團隊藉此在已廣泛測試的模型中發現了新的可修復缺陷[3];在另一項用戶研究中,使用 CheckList 的從業者比未使用者多創建 2 倍測試用例,找出近 3 倍缺陷[3]。
把評測嵌入網關工程:樣例契約、影子比對與人工複核關口
上述研究共同指向一個工程結論:模型選型與切換須轉化為持續驗證的網關流程。在 rlab.works 的模型網關模組中,這一方法論落地為明確契約、輔助評測與人工關口。
在模型接入階段,技能包新服務試運行接入(S18)以「服務地址、授權資訊與接口約定」為初始輸入:
- 登記服務節點(輔助執行):登記服務節點,輸出已登記節點和健康狀態。
- 配置調用方式(輔助執行):生成待驗收的客戶端和接口配置。
- 少量試運行(輔助執行):發送有界測試請求,記錄響應和類型化錯誤。
- 接入或回退(人工複核):由指定複核人或請求用戶審閲;被拒絕的輸出退回修訂且不進入下一步,通過後留存人工確認的接入版本與發佈記錄。
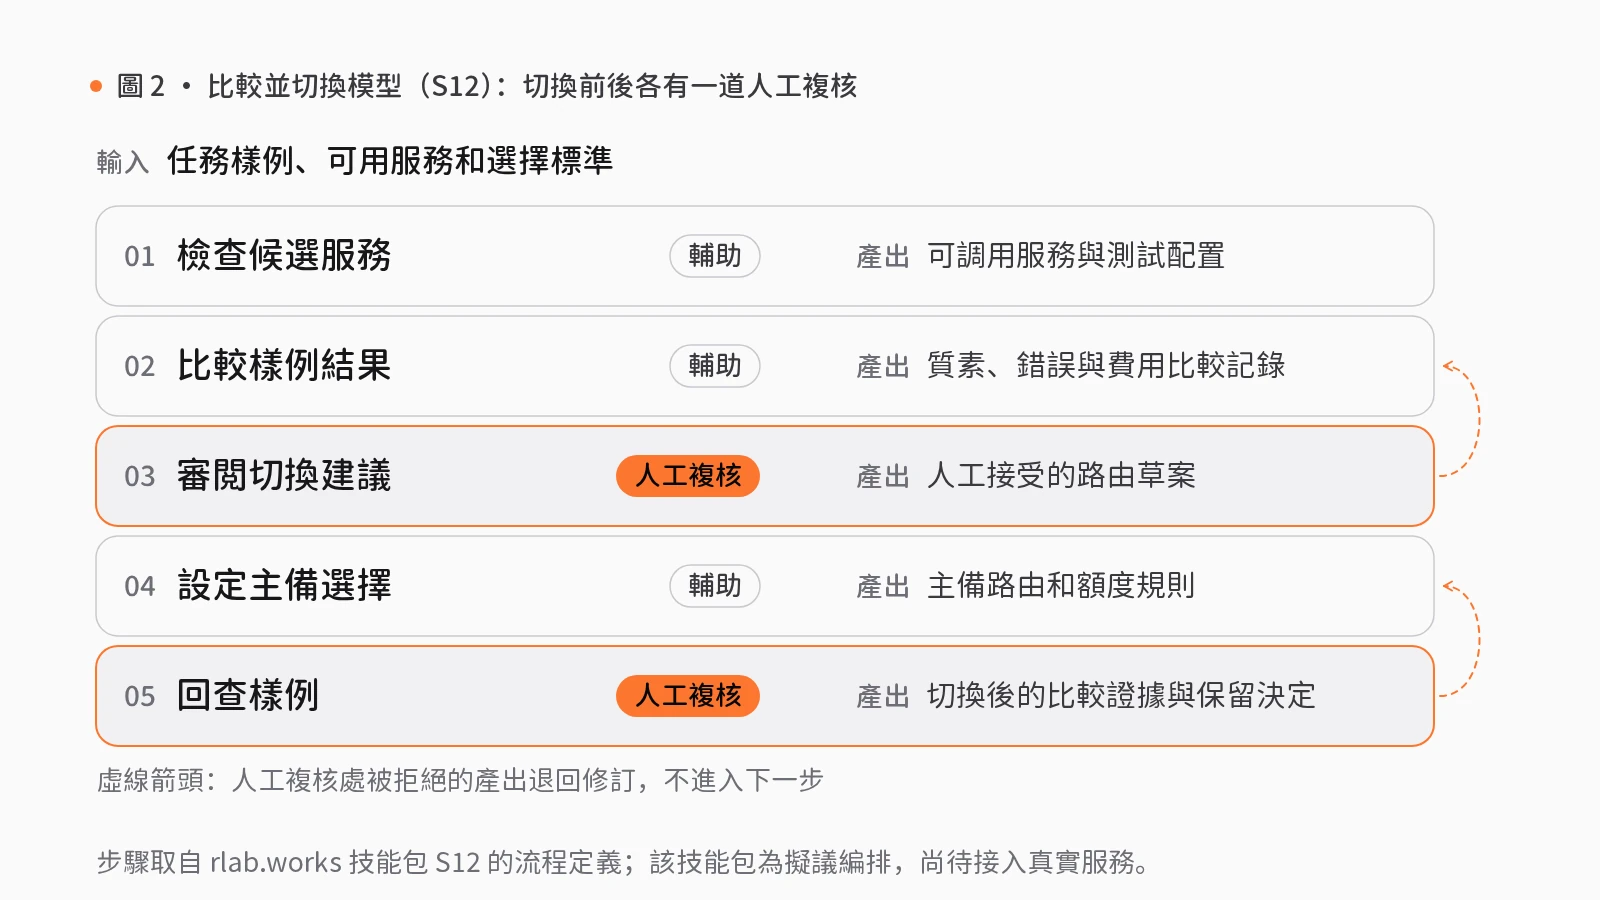
候選服務通過驗收後,技能包模型對比與切換(S12)以「任務樣例、可用服務和選擇標準」為輸入執行對比與切換:
- 檢查可選模型(輔助執行):核驗可調用服務與測試配置。
- 樣例對比(輔助執行):依託模型對比與影子評估(在數據集上比較主模型與候選模型,可選用模型評審,收集影子流量和路由反饋證據)與任務感知的模型路由與結構化評測(按順序回退,選擇已配置的任務檔位,並用確定性測試樣本校驗結構化輸出),產出質素、錯誤與費用比較記錄。
- 審閲切換建議(人工複核):經路由建議審閲列出已保存的路由建議供人工複核;被拒絕的輸出退回修訂且不進入下一步,通過後形成人工接受的路由草案。
- 設定主備模型(輔助執行):配置主備路由和額度規則。
- 切換後抽查(人工複核):切換後人工複核樣例,留存比較證據與保留決定。
此外,站點所有技能包目前均為擬議編排,僅通過合成數據演示,尚未接入真實服務。文中涉及的原子組件雖為可運行代碼,但成熟度僅基於靜態源碼檢查而非生產部署:任務感知的模型路由與結構化評測僅將邏輯檔位映射到已配置模型,並非多供應商計費網關;路由建議審閲僅支援將已保存建議應用到策略草稿或忽略,所檢查的服務中未確認存在自動生成建議的功能。
資助模型選型與替換試點前的管理檢驗
企業負責人或首席架構師在批准模型替換或路由試點前,可按以下標準檢驗方案:
- 是否以多維指標與行為清單替代單一榜單排名? 檢查是否針對私有任務定義了涵蓋準確率、效率、魯棒性與結構化格式的固定評分標準,並構建邊界測試用例集。
- 切換前是否具備同源樣例與影子流量證據? 要求候選服務與現有主模型在同一批私有樣例或影子流量上對比,輸出質素、類型化錯誤與費用記錄。
- 接入驗收與路由切換是否設有具阻斷權的人工關口? 確認新節點放行與主備切換均經人工複核並留存回查證據,未經接受的建議不得自動生效。
覺得有用?分享給需要的人。
參考文獻
- [1]
Liang, P., Bommasani, R., Lee, T., Tsipras, D., Soylu, D., Yasunaga, M., Zhang, Y., Narayanan, D., Wu, Y., Kumar, A., Newman, B., Yuan, B., Yan, B., Zhang, C., Cosgrove, C., Manning, C. D., Ré, C., Acosta-Navas, D., Hudson, D. A., ... Koreeda, Y. (2023). Holistic Evaluation of Language Models. Transactions on Machine Learning Research (TMLR). arxiv.org ↗
- [2]
Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., Lin, Z., Li, Z., Li, D., Xing, E. P., Zhang, H., Gonzalez, J. E., & Stoica, I. (2023). Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. Advances in Neural Information Processing Systems (NeurIPS), 36. arxiv.org ↗
- [3]
Ribeiro, M. T., Wu, T., Guestrin, C., & Singh, S. (2020). Beyond Accuracy: Behavioral Testing of NLP Models with CheckList. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics (ACL), 4902–4912. doi.org/10.18653/v1/2020.acl-main.442