【旅游酒店之一】多源主数据归一(Entity Resolution):为什么智能行程编排的底座是枯燥的目录清洗
可靠的行程编排以多源目录去重归一与记录链接为底座,再在真实库存与营业时间内做约束规划;未经清洗的主数据只会让规划算法把多条件冲突包装成通顺却难以执行的草案。

通顺的行程文案背后,为何常藏着难以兑现的预订冲突
设想一种常见的业务情形:旅行服务团队将多渠道供应商名录接入对话式规划工具,要求按家庭预算、同行人构成与交通衔接生成跨城行程。模型很快输出了一份图文并茂的方案,但进入人工核价与锁房环节时,计调人员却发现方案中容易出现已停业或无房的酒店、拼写相近却位于不同城区的同名场馆,或把同一邮轮在不同批发商处的别名当成不同的备选方案。
这种落差并非仅靠调整提示词就能消除。在复杂旅行服务中,可靠的行程编排以多源目录去重归一与记录链接为底座,再在真实库存与营业时间内做约束规划。跳过底层枯燥的目录清洗,直接让模型在杂乱数据上做自由生成,往往只能得到表面通顺却无法落地的文本。
从记录链接理论到多约束规划评测:数据底座与规划能力的双重挑战
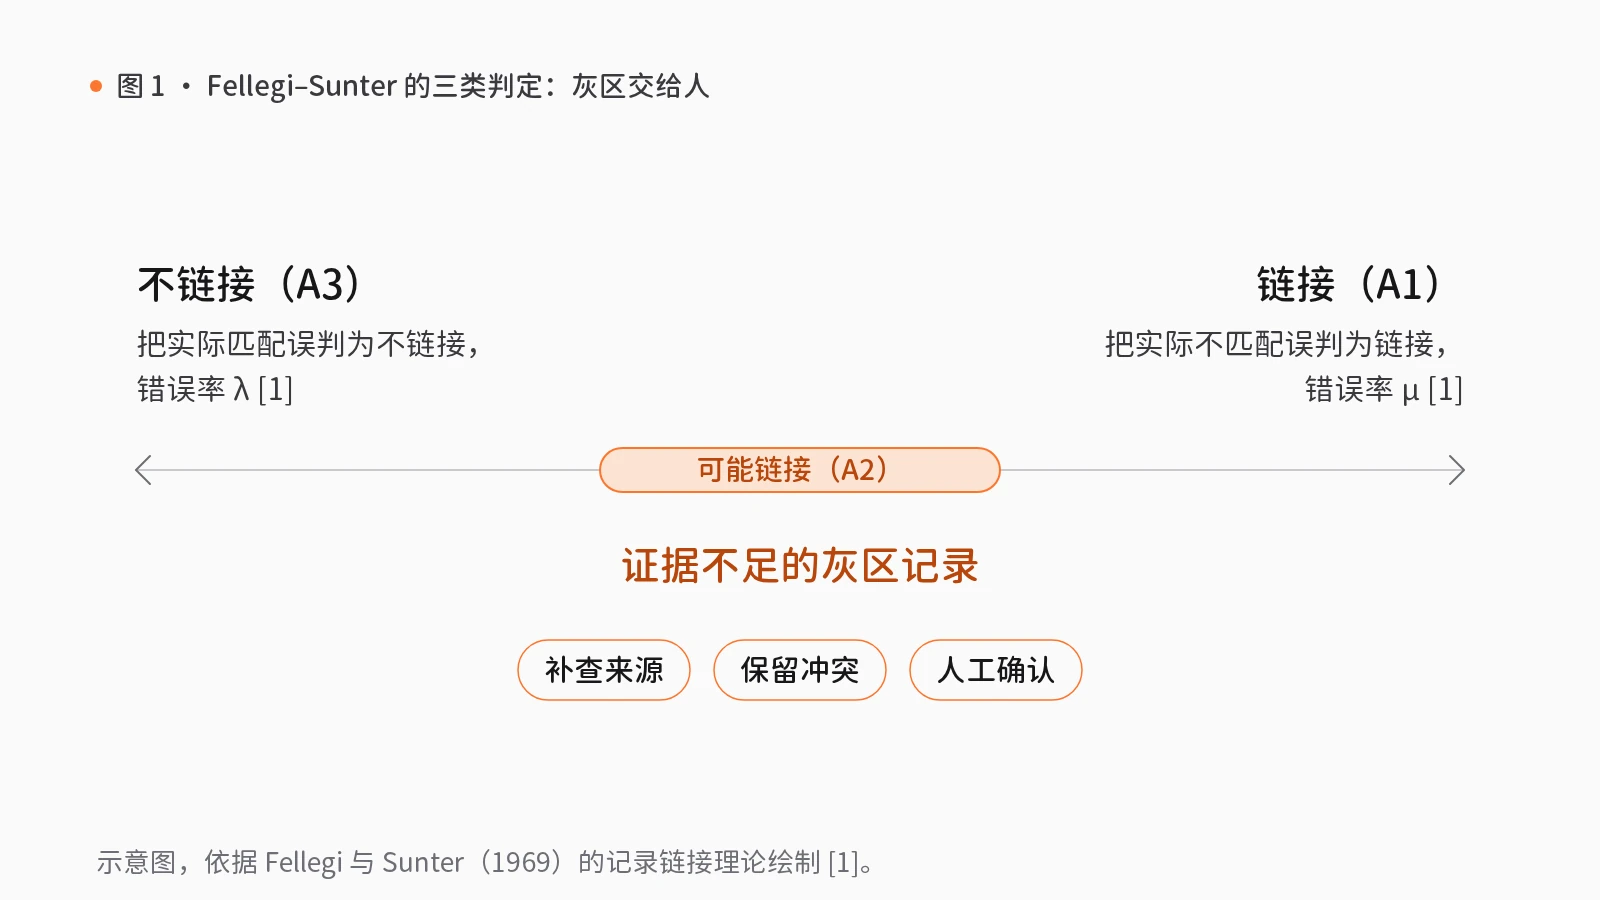
为什么将多源记录对齐到同一真实实体如此困难?早在电子数据处理初期,Fellegi 与 Sunter(1969)便在记录链接理论中为这一问题建立了数学框架[1]。该模型比较来自两个文件的记录特征向量 γ,以识别指向同一人、物体或事件的记录对,并在给定错误水平下将判定分为三类:链接(A1)、不链接(A3)与因证据不足而无法作出明确判定的“可能链接”(A2)[1]。其中前两类明确处置伴随两类错误概率——将实际不匹配记录误判为链接(错误率 μ),或将实际匹配记录误判为不链接(错误率 λ)[1]。最优链接规则的核心性质,是在固定错误率(μ, λ)的前提下,最小化落入“可能链接”(A2)的概率[1]。这一经典结论揭示了一个工程事实:只要存在数据噪声与错误容忍边界,通常就会留下无法仅靠自动阈值消化的灰区记录(A2),需要进入补查与人工复核通道。
即便底层提供了结构化检索环境,仅靠语言智能体直接拼装多约束行程依然极为脆弱。Xie 等人(2024)提出的 TravelPlanner 基准测试,专门评估语言智能体在真实世界复杂旅行规划中的表现[2]。该基准构建了包含近 400 万条数据记录的沙盒环境与配套检索工具,并整理了 1,225 条规划意图与参考方案[2]。评测结果显示,现有语言智能体尚不具备处理此类复杂规划任务的能力——即便是评测中表现领先的商用大模型,最终成功率也仅为 0.6%[2]。研究者指出,智能体往往难以持续聚焦任务、难以正确调用工具收集信息,也难以同时追踪多项约束条件[2]。当多约束追踪本身的容错率已经极低时,倘若上游目录还充斥着未归一的重复实体与过期状态,规划结果就会偏离实际可预订范围。
目录归一与约束编排的工程解耦:从主数据清洗到版本化行程
将上述文献机制转化为系统架构,意味着必须把“主数据目录归一”与“多约束行程编排”拆分为职责分明、带有显式人工关口的工作流,而不是混入单次对话生成中。在 rlab.works 的能力版图中,这一分层横跨智能感知与智能中枢模块,并在旅游酒店行业下具备明确的源数据对应关系。
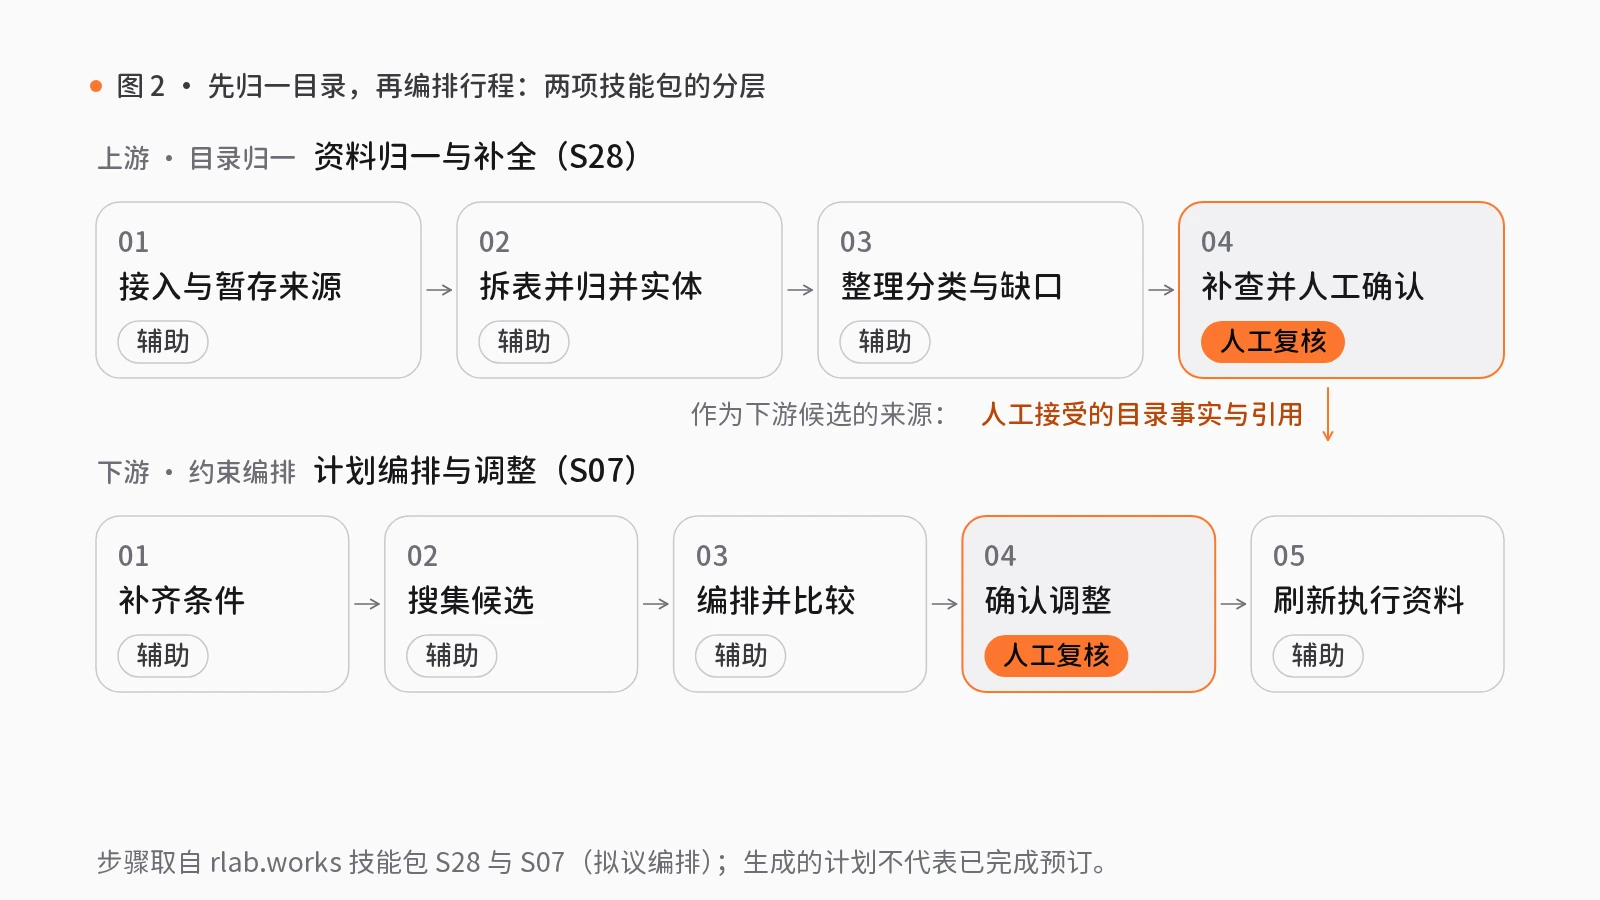
上游层负责目录去重与补全。在智能感知模块中,「多源资料合并(S28)」技能包以“授权来源、旧资料与目标目录字段”为初始输入契约,依次推进:
- 导入各方资料(辅助):导入不同渠道记录,输出带出处的暂存资料和缺失记录。
- 合并同一对象(辅助):可结合规范化的地理、酒店与 POI 实体及多供应商邮轮目录标准化等能力拆解异构结构,输出统一实体、明细关系与别名。
- 分类并标明缺口(辅助):对齐分类体系,输出分类结果和待补事实清单。
- 补查并确认(人工复核):对应 Fellegi-Sunter 模型中的灰区处置,将冲突记录与待补事实交由流程指定的复核人或提出请求的用户审阅,输出人工接受的目录事实与引用;被拒绝的产出退回修订,不进入下一步。
在旅游酒店行业,S28 的源数据有行业依据,设计用于把不同供应商的目的地、酒店和航次资料归并,补齐缺失事实后再进入目录;其适配边界在于不同供应入口需要独立字段契约以保留冲突和来源差异,且真实目录接线仍待实施。
下游层是在干净目录之上做受控规划。在智能中枢模块中,「计划制定与调整(S07)」技能包以“自然语言目标、时间与资源限制”为输入,依次执行:明确条件(辅助,输出已澄清的硬条件和偏好)、查找候选项(辅助,输出带来源的候选清单与约束)、生成计划(辅助,可借助版本化行程规划与重规划能力生成计划草案及与前版的差异)、选定方案(人工复核,输出人工选定的计划版本)与更新执行资料(辅助,输出已刷新资料、任务状态和待决变化)。S07 在旅游酒店行业同样属于源数据有行业依据,可将出行时间、预算和偏好转成可比较行程,经旅客确认后再刷新报价与候选;但刷新后的冲突需重新确认,且生成的计划不代表已完成预订。至于涉及地理坐标与路网计算的「地址核对与路线规划(S27)」技能包(定位地址、补充天气与时间、计算候选路线、在地图上确认),在站点目录中仅标注为物流行业的可迁移应用,并无旅游酒店行业标签,因此只能作为地址消歧与看图复核的通用工作流模式参考,不承诺最优路线或实时可通行。
启动智能行程项目前的管理检验
在批准旅游或酒店场景的智能规划研发预算前,业务负责人与首席数据官可开展以下前置检验:
- 检验上游目录是否设立了灰区复核队列:不要只看演示环境中的成团方案,应检查多供应商酒店、航次与景点接入时,是否区分了高置信归并记录与待人工确认的冲突记录,以及是否保留了字段级来源出处。
- 检验约束校验是否与文本生成解耦:核实预算上限、同行人房型要求、营业时间窗等硬约束是否由结构化状态机与版本比对逻辑显式追踪,而非依赖大模型在长文本生成中自行记忆。
- 检验计划确认与库存锁定的责任边界:确认人工选定行程版本后,价格与库存刷新引发的冲突是否能强制触发重审,避免将未经核实的规划草案直接当成对客承诺。
觉得有用?分享给需要的人。
参考文献
- [1]
Fellegi, I. P., & Sunter, A. B. (1969). A Theory for Record Linkage. Journal of the American Statistical Association, 64(328), 1183–1210. doi.org/10.1080/01621459.1969.10501049
- [2]
Xie, J., Zhang, K., Chen, J., Zhu, T., Lou, R., Tian, Y., Xiao, Y., & Su, Y. (2024). TravelPlanner: A Benchmark for Real-World Planning with Language Agents. Proceedings of the 41st International Conference on Machine Learning (ICML 2024). arxiv.org ↗
- [3]
Christophides, V., Efthymiou, V., Palpanas, T., Papadakis, G., & Stefanidis, K. (2020). An Overview of End-to-End Entity Resolution for Big Data. ACM Computing Surveys, 53(6), Article 127. doi.org/10.1145/3418896
相关能力
技能包
S28 · 智能感知
多源资料合并
同一对象在多个系统中各有一份资料,名称不一、字段不全,越用越混乱。
将多方资料合并为统一目录并标明缺失项,补查到的新事实经人工确认后方可写入。
- 导入各方资料
- 合并同一对象
- 分类并标明缺口
- 补查并确认人工复核
4 步1 处人工复核10 个组件
S07 · 智能中枢
计划制定与调整
计划制定后,时间、预算或资源一旦变化,就需重新手工调整。
先明确硬性条件与偏好,生成计划并标明与上一版的差异;经人工选定后更新,各版本均留存。
- 明确条件
- 查找候选项
- 生成计划
- 选定方案人工复核
- 更新执行资料
5 步1 处人工复核6 个组件
S27 · 智能感知
地址核对与路线规划
地址写法不一、同名地点众多,规划路线前仅核对位置就十分耗时。
先准确定位地址并标出存在歧义的地址,补充天气与活动时间,计算候选路线,由人工在地图上确认。
- 定位地址
- 补充天气与时间
- 计算候选路线
- 在地图上确认人工复核
4 步1 处人工复核9 个组件