【旅遊酒店之一】多源主數據歸一(Entity Resolution):為什麼智能行程編排的底座是枯燥的目錄清洗
可靠的行程編排以多源目錄去重歸一與記錄連結為底座,再在真實庫存與營業時間內做約束規劃;未經清洗的主數據只會讓規劃算法把多條件衝突包裝成通順卻難以執行的草案。

通順的行程文案背後,為何常藏着難以兑現的預訂衝突
設想一種常見的業務情形:旅行服務團隊將多渠道供應商名錄接入對話式規劃工具,要求按家庭預算、同行人構成與交通銜接生成跨城行程。模型很快輸出了一份圖文並茂的方案,但進入人工核價與鎖房環節時,計調人員卻發現方案中容易出現已停業或無房的酒店、拼寫相近卻位於不同城區的同名場館,或把同一郵輪在不同批發商處的別名當成不同的備選方案。
這種落差並非僅靠調整提示詞就能消除。在複雜旅行服務中,可靠的行程編排以多源目錄去重歸一與記錄連結為底座,再在真實庫存與營業時間內做約束規劃。跳過底層枯燥的目錄清洗,直接讓模型在雜亂數據上做自由生成,往往只能得到表面通順卻無法落地的文本。
從記錄連結理論到多約束規劃評測:數據底座與規劃能力的雙重挑戰
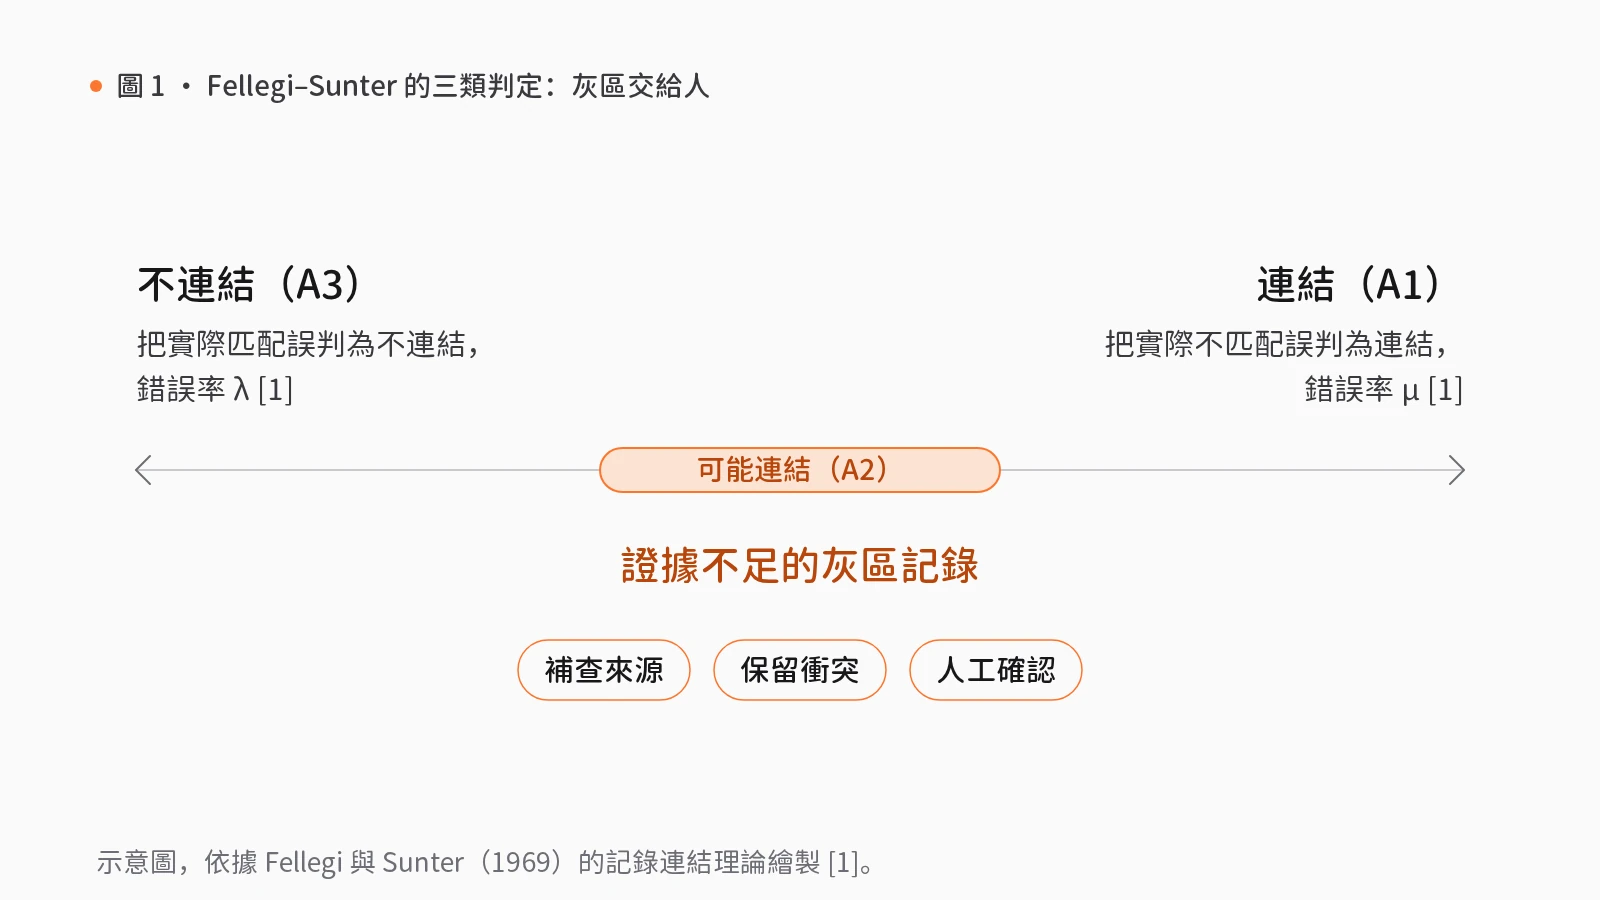
為什麼將多源記錄對齊到同一真實實體如此困難?早在電子數據處理初期,Fellegi 與 Sunter(1969)便在記錄連結理論中為這一問題建立了數學框架[1]。該模型比較來自兩個文件的記錄特徵向量 γ,以識別指向同一人、物體或事件的記錄對,並在給定錯誤水平下將判定分為三類:連結(A1)、不連結(A3)與因證據不足而無法作出明確判定的「可能連結」(A2)[1]。其中前兩類明確處置伴隨兩類錯誤概率——將實際不匹配記錄誤判為連結(錯誤率 μ),或將實際匹配記錄誤判為不連結(錯誤率 λ)[1]。最優連結規則的核心性質,是在固定錯誤率(μ, λ)的前提下,最小化落入「可能連結」(A2)的概率[1]。這一經典結論揭示了一個工程事實:只要存在數據噪聲與錯誤容忍邊界,通常就會留下無法僅靠自動閾值消化的灰區記錄(A2),需要進入補查與人工複核通道。
即便底層提供了結構化檢索環境,僅靠語言智能體直接拼裝多約束行程依然極為脆弱。Xie 等人(2024)提出的 TravelPlanner 基準測試,專門評估語言智能體在真實世界複雜旅行規劃中的表現[2]。該基準構建了包含近 400 萬條數據記錄的沙盒環境與配套檢索工具,並整理了 1,225 條規劃意圖與參考方案[2]。評測結果顯示,現有語言智能體尚不具備處理此類複雜規劃任務的能力——即便是評測中表現領先的商用大模型,最終成功率也僅為 0.6%[2]。研究者指出,智能體往往難以持續聚焦任務、難以正確調用工具收集資訊,也難以同時追蹤多項約束條件[2]。當多約束追蹤本身的容錯率已經極低時,倘若上游目錄還充斥着未歸一的重複實體與過期狀態,規劃結果就會偏離實際可預訂範圍。
目錄歸一與約束編排的工程解耦:從主數據清洗到版本化行程
將上述文獻機制轉化為系統架構,意味着必須把「主數據目錄歸一」與「多約束行程編排」拆分為職責分明、帶有顯式人工關口的工作流,而不是混入單次對話生成中。在 rlab.works 的能力版圖中,這一分層橫跨智能感知與智能中樞模組,並在旅遊酒店行業下具備明確的源數據對應關係。
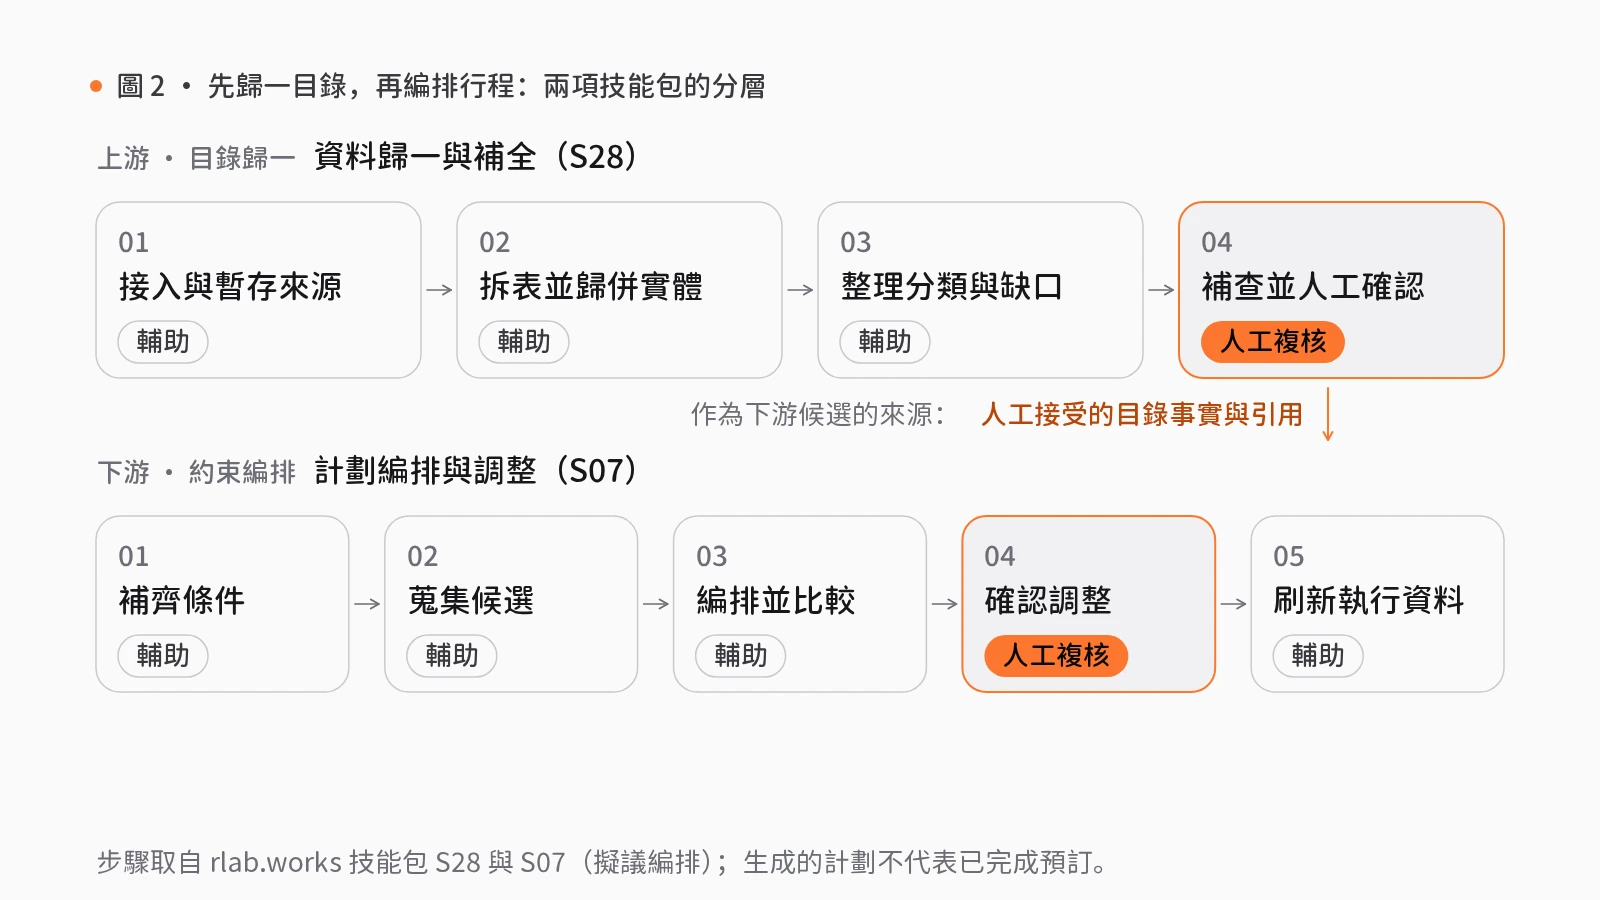
上游層負責目錄去重與補全。在智能感知模組中,「多源資料合併(S28)」技能包以「授權來源、舊資料與目標目錄欄位」為初始輸入契約,依次推進:
- 匯入各方資料(輔助):匯入不同渠道記錄,輸出帶出處的暫存資料和缺失記錄。
- 合併同一對象(輔助):可結合規範化的地理、酒店與 POI 實體及多供應商郵輪目錄標準化等能力拆解異構結構,輸出統一實體、明細關係與別名。
- 分類並標明缺口(輔助):對齊分類體系,輸出分類結果和待補事實清單。
- 補查並確認(人工複核):對應 Fellegi-Sunter 模型中的灰區處置,將衝突記錄與待補事實交由流程指定的複核人或提出請求的用戶審閲,輸出人工接受的目錄事實與引用;被拒絕的產出退回修訂,不進入下一步。
在旅遊酒店行業,S28 的源數據有行業依據,設計用於把不同供應商的目的地、酒店和航次資料歸併,補齊缺失事實後再進入目錄;其適配邊界在於不同供應入口需要獨立欄位契約以保留衝突和來源差異,且真實目錄接線仍待實施。
下游層是在乾淨目錄之上做受控規劃。在智能中樞模組中,「計劃制定與調整(S07)」技能包以「自然語言目標、時間與資源限制」為輸入,依次執行:明確條件(輔助,輸出已澄清的硬條件和偏好)、查找候選項(輔助,輸出帶來源的候選清單與約束)、生成計劃(輔助,可藉助版本化行程規劃與重規劃能力生成計劃草案及與前版的差異)、選定方案(人工複核,輸出人工選定的計劃版本)與更新執行資料(輔助,輸出已刷新資料、任務狀態和待決變化)。S07 在旅遊酒店行業同樣屬於源數據有行業依據,可將出行時間、預算和偏好轉成可比較行程,經旅客確認後再刷新報價與候選;但刷新後的衝突需重新確認,且生成的計劃不代表已完成預訂。至於涉及地理座標與路網計算的「地址核對與路線規劃(S27)」技能包(定位地址、補充天氣與時間、計算候選路線、在地圖上確認),在站點目錄中僅標註為物流行業的可遷移應用,並無旅遊酒店行業標籤,因此只能作為地址消歧與看圖複核的通用工作流模式參考,不承諾最優路線或實時可通行。
啓動智能行程項目前的管理檢驗
在批准旅遊或酒店場景的智能規劃研發預算前,業務負責人與首席數據官可開展以下前置檢驗:
- 檢驗上游目錄是否設立了灰區複核隊列:不要只看演示環境中的成團方案,應檢查多供應商酒店、航次與景點接入時,是否區分了高置信歸併記錄與待人工確認的衝突記錄,以及是否保留了欄位級來源出處。
- 檢驗約束校驗是否與文本生成解耦:核實預算上限、同行人房型要求、營業時間窗等硬約束是否由結構化狀態機與版本比對邏輯顯式追蹤,而非依賴大模型在長文本生成中自行記憶。
- 檢驗計劃確認與庫存鎖定的責任邊界:確認人工選定行程版本後,價格與庫存刷新引發的衝突是否能強制觸發重審,避免將未經核實的規劃草案直接當成對客承諾。
覺得有用?分享給需要的人。
參考文獻
- [1]
Fellegi, I. P., & Sunter, A. B. (1969). A Theory for Record Linkage. Journal of the American Statistical Association, 64(328), 1183–1210. doi.org/10.1080/01621459.1969.10501049
- [2]
Xie, J., Zhang, K., Chen, J., Zhu, T., Lou, R., Tian, Y., Xiao, Y., & Su, Y. (2024). TravelPlanner: A Benchmark for Real-World Planning with Language Agents. Proceedings of the 41st International Conference on Machine Learning (ICML 2024). arxiv.org ↗
- [3]
Christophides, V., Efthymiou, V., Palpanas, T., Papadakis, G., & Stefanidis, K. (2020). An Overview of End-to-End Entity Resolution for Big Data. ACM Computing Surveys, 53(6), Article 127. doi.org/10.1145/3418896
相關能力
技能包
S28 · 智能感知
多源資料合併
同一對象在多個系統中各有一份資料,名稱不一、欄位不全,越用越混亂。
將多方資料合併為統一目錄並標明缺失項,補查到的新事實經人工確認後方可寫入。
- 匯入各方資料
- 合併同一對象
- 分類並標明缺口
- 補查並確認人工複核
4 步1 處人工複核10 個組件
S07 · 智能中樞
計劃制定與調整
計劃制定後,時間、預算或資源一旦變化,就需重新手工調整。
先明確硬性條件與偏好,生成計劃並標明與上一版的差異;經人工選定後更新,各版本均留存。
- 明確條件
- 查找候選項
- 生成計劃
- 選定方案人工複核
- 更新執行資料
5 步1 處人工複核6 個組件
S27 · 智能感知
地址核對與路線規劃
地址寫法不一、同名地點眾多,規劃路線前僅核對位置就十分耗時。
先準確定位地址並標出存在歧義的地址,補充天氣與活動時間,計算候選路線,由人工在地圖上確認。
- 定位地址
- 補充天氣與時間
- 計算候選路線
- 在地圖上確認人工複核
4 步1 處人工複核9 個組件