【教育】認知腳手架還是思維枴杖?成人學習服務中的記憶跟進、課件製作與教師審核關口
在成人學習服務中,人工智能適合承擔助教後台職責:在學習者授權下記錄練習偏好並提醒複習、協助製作講義與課程資料更新,並在發佈與下發前由講師或學習者本人複核;相關技能包在教育行業均屬於可遷移應用。

直接給答案的對話界面,為何難以沉澱真實教學效果
設想一種常見的情形:某成人職業培訓機構上線了開放式問答助手,學員遇到習題或概念疑問時直接向對話框索取現成解答,講師也嘗試讓模型直接生成配圖課件並自動推送給學員。運行一段時間後,教學團隊卻發現了明顯隱患:一方面,未經講師核對的自動合成課件混入了失真的概念示意圖,誤導了學員對專業術語的理解;另一方面,系統在缺乏明確邊界的情況下隨意記錄對話並推送消息,既未讓學習者確認哪些偏好應當保留,也把本應輔助消化的練習過程變成了直接代寫答案的捷徑。
這一困境揭示了教育場景中技術定位的偏差。在成人學習服務中,人工智能並不適合充當越過教師的台前主講,而適合作為受控的助教後台:在學習者授權下記錄進度並提醒複習、協助製作講義,並在發佈前由講師複核。在當前能力體系中,教育相關的技能包均屬於需經領域適配的可遷移應用。
從輔導效應爭議到生成式工具的治理邊界
理解助教後台的合理邊界,需要回到教育學對一對一輔導與計算輔導系統的實證檢驗。Bloom(1984)在《The 2 Sigma Problem: The Search for Methods of Group Instruction as Effective as One-to-One Tutoring》一文中,梳理了芝加哥大學教育學博士生 Anania(1982, 1983)與 Burke(1984)的學位論文實驗,對比了 3 種教學條件下的學生學習情況:常規教學(每名教師面對約 30 名學生的班級,定期測試以評定成績)、掌握學習(同樣是每名教師面對約 30 名學生的班級,教學相同,但通過形成性測試提供反饋,輔以糾錯程式與平行形成性測試以確認掌握程度),以及輔導(每名學生或同時 2 至 3 名學生配備 1 名優秀輔導者,同樣定期開展形成性測試、反饋糾錯與平行形成性測試,且輔導條件下所需的糾錯工作量非常小)[1]。
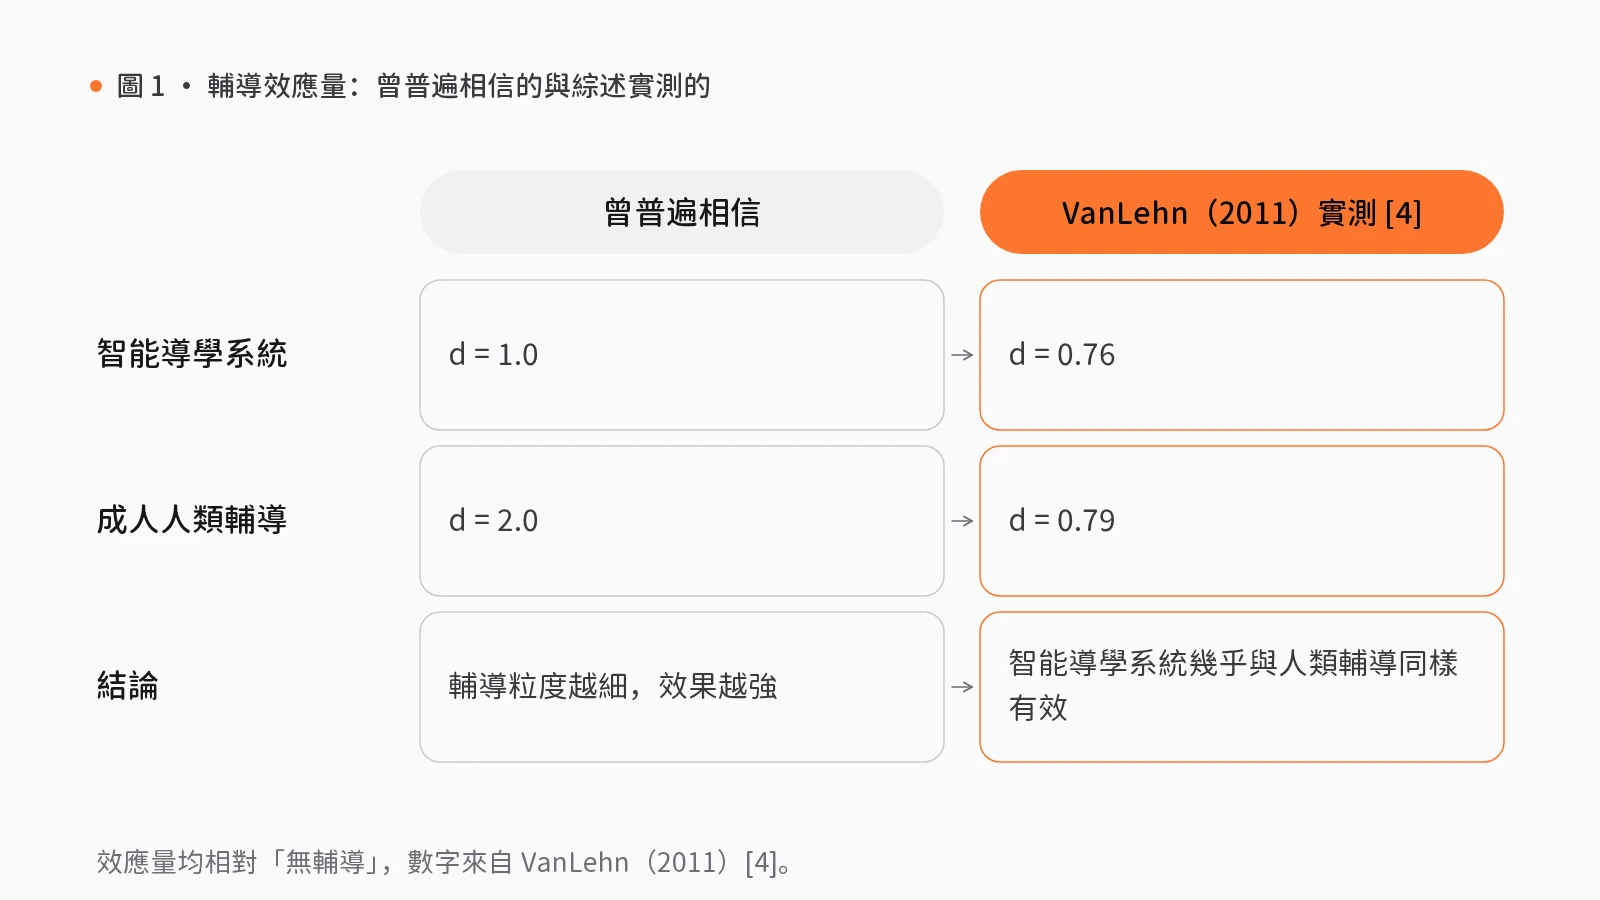
然而,早期文獻中對人類輔導效應量的預期在後續系統綜述中受到了修正。VanLehn(2011)對比較人類輔導、計算機輔導與“No tutoring”(無輔導,即教授相同內容但不含輔導)的實驗研究進行了綜述,按界面交互粒度將計算機輔導劃分為基於答案、基於步驟和基於子步驟的系統[4]。大多數智能導學系統採用基於步驟或子步驟的交互粒度,而其他常見計算機輔助教學系統多采用基於答案的界面[4]。學界曾普遍認為輔導粒度越細效果越強,相信與無輔導相比,基於答案的系統、智能導學系統與成人人類輔導者的效應量分別為 d = 0.3、1.0 與 2.0[4]。但該綜述並未證實這一信念:實測發現人類輔導的效應量要低得多,為 d = 0.79,而智能導學系統的效應量為 0.76,幾乎與人類輔導同樣有效[4]。我們據此推斷(並非該綜述的直接結論):在輔導中,按步驟展開的反饋與核驗,可能比模仿人類導師的外在形式更關鍵。
助教後台的工程拆解:偏好授權、講義複核與訂閲隔離
將上述文獻結論轉化為系統架構,意味着應將學習跟進、課件製作與資料訂閲拆解為帶有人為複核關口的後台工作流。在 rlab.works 站點的教育行業視圖中,目前沒有任何技能包帶有「源數據有行業依據」標籤,所涉技能包均為「可遷移應用」,上線前須完成教育領域的合規改造與接口適配。
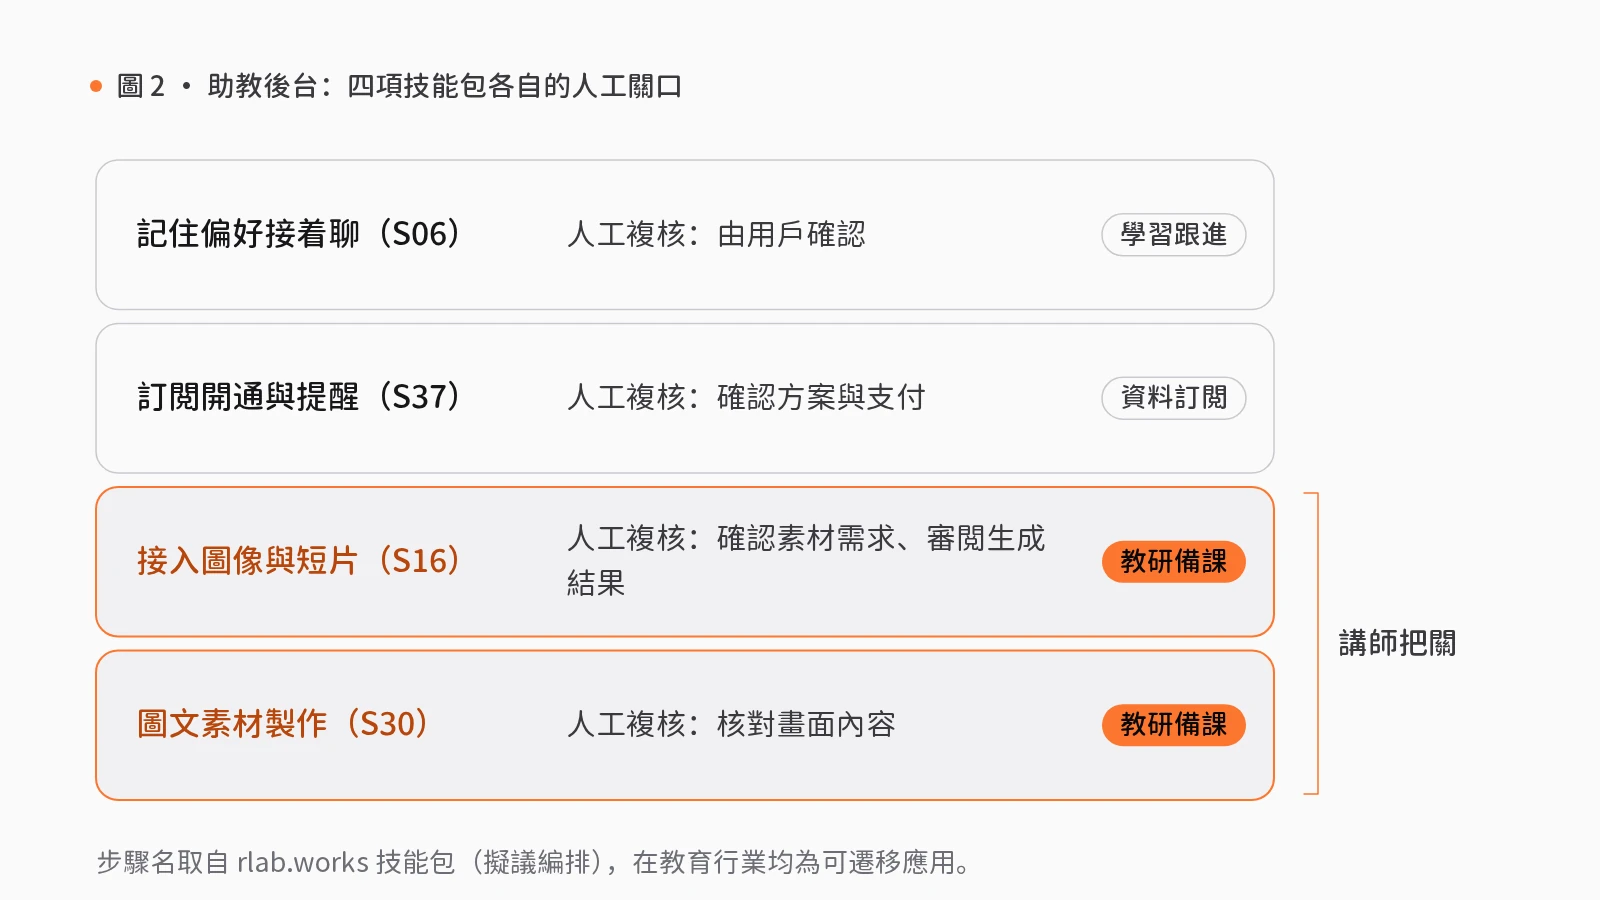
在學習跟進與訂閲觸達層面,智能中樞模組下的用戶偏好記憶與回訪(S06)技能包以「用戶同意、偏好與對話記錄」為輸入,收集自願提供的偏好、整理去重脱敏的候選記憶,隨後暫停在人工複核關口——由學習者本人確認並保留可改可刪的已接受記憶,再據此繼續對話或按意願安排簽到與可關閉的提醒。其底層可調用個人記憶檢索與生命週期組件(靜態檢查為可運行代碼),從對話和簽到中提取記憶候選、應用時間窗與保留上限並支援手動編輯和刪除。遷移至成人學習服務時,須替換原陪伴主題與固定資料;系統不判斷學習能力或心理狀況,也不把求助草稿自動發送。與之配合,智能商務模組的訂閲開通與提醒(S37)藉助「託管訂閲計費演練」(原型成熟度)先在隔離環境中演練訂閲流程並輸出對賬結果,經人工複核「用戶確認並付款」、再「開通權益與額度」後,才按確認的偏好發送可退訂的資料更新。教育場景適配時,課程權益與消息同意須分別維護,演練事件不能開通真實權益。
在教研備課層面,智能感知模組的演示圖文素材製作(S30)與模型網關模組的圖片與短片生成審核(S16)構成了受講師把關的後台鏈路。「圖片與短片生成審核(S16)」先確認可用格式,在人工複核關口由教師確認生成需求,取回候選圖片或短片後再經人工複核審閲輸出是否適合課堂。「演示圖文素材製作(S30)」以「已審文字、參考素材與使用許可」為輸入,整理參考素材並生成帶文字和來源記錄的候選圖文,在人工複核關口由講師核對示意圖是否把概念講對(被拒絕的產出退回修訂且不進入下一步),通過後才由「可搜尋的演示文稿封裝」(靜態檢查為可運行代碼)等組件匯出為帶可檢索文字的演示資料。在教育行業遷移時,概念準確性須由教師檢查,生成圖片只作示意,不能作為實驗結果或歷史實物證據,且需替換原人物資產與模板。
成人學習服務試點的管理檢驗清單
教育機構負責人或教研主管在資助人工智能助教試點前,可依據以下具體標準開展上線前核查:
- 學習記憶是否具備顯式授權與可擦除機制? 檢查系統是否在記錄進度與練習偏好前徵得成年學習者同意,並提供確認、修改與刪除候選記憶的人工關口,杜絕靜默畫像或能力評判。
- 課件圖文是否在匯出前經過講師概念核驗? 確認生圖與排版工作流嵌有阻斷式複核節點,確保生成圖像與實驗數據、歷史實物嚴格區分,未經講師核准的示意圖不得流入講義。
- 資料訂閲是否完成了計費演練與同意解耦? 核實訂閲鏈路是否將賬單演練與真實權益開通隔離,確保學習者可隨時關閉複習提醒或退訂更新,而不影響已購課程訪問。
覺得有用?分享給需要的人。
參考文獻
- [1]
Bloom, B. S. (1984). The 2 Sigma Problem: The Search for Methods of Group Instruction as Effective as One-to-One Tutoring. Educational Researcher, 13(6), 4–16. doi.org/10.3102/0013189X013006004
- [2]
Kasneci, E., Sessler, K., Küchemann, S., Bannert, M., Dementieva, D., Fischer, F., Gasser, U., Groh, G., Günnemann, S., Hüllermeier, E., Krusche, S., Kutyniok, G., Michaeli, T., Nerdel, C., Pfeffer, J., Poquet, O., Sailer, M., Schmidt, A., Seidel, T., ... Kasneci, G. (2023). ChatGPT for good? On opportunities and challenges of large language models for education. Learning and Individual Differences, 103, 102274. doi.org/10.1016/j.lindif.2023.102274
- [3]
UNESCO. (2023). Guidance for generative AI in education and research. United Nations Educational, Scientific and Cultural Organization. unesdoc.unesco.org ↗
- [4]
VanLehn, K. (2011). The Relative Effectiveness of Human Tutoring, Intelligent Tutoring Systems, and Other Tutoring Systems. Educational Psychologist, 46(4), 197–221. doi.org/10.1080/00461520.2011.611369
相關能力
平台模組
技能包
S06 · 智能中樞
用戶偏好記憶與回訪
每次對話都需重新詢問,用戶體驗不佳;記錄過多,又會引發隱私顧慮。
經用戶同意後記錄偏好,用戶可隨時修改或刪除;按用戶約定的頻率回訪,可隨時停止。
- 收集自願提供的偏好
- 整理待記錄內容
- 用戶確認記錄項人工複核
- 繼續對話或轉介
- 按約回訪
5 步1 處人工複核10 個組件
S30 · 智能感知
演示圖文素材製作
製作路演或宣傳材料時,找圖、配文、排版反覆修改,事實也容易出錯。
整理有授權的參考素材,生成候選圖文,畫面與事實經人工核對後,組合為文字可檢索的演示資料。
- 整理參考素材
- 製作候選圖文
- 核對畫面內容人工複核
- 組合並匯出
4 步1 處人工複核8 個組件
S37 · 智能商務
訂閲開通與提醒
付款後權益未開通、退訂後仍收到消息,都會引起用戶不滿。
先以測試事件演練訂閲流程;付款回調核驗通過後開通權益,提醒僅在用戶二次確認後按約發送。
- 演練訂閲流程
- 用戶確認並付款人工複核
- 開通權益與額度
- 確認偏好後提醒
4 步1 處人工複核4 個組件
S16 · 模型網關
圖片與短片生成審核
AI 生成圖片速度快,但尺寸、風格或授權不符時,返工成本反而更高。
先確認可生成的格式與尺寸,素材需求經批准後生成,成品逐一審閲,不合格的列入返修清單。
- 確認可用格式
- 確認生成需求人工複核
- 生成並取回
- 逐一審閲人工複核
4 步2 處人工複核3 個組件