提示词里的策略不够:可执行环境里的策略护栏与「允许的工具」违规
将部署策略写进任务智能体的提示词,仍会遗留可观的违规执行风险——尤其当违规调用使用的是白名单内允许的工具,仅在参数、目标资源或上下文条件上越界时,单凭工具身份无法识别违规。工程实践需在提示词之外构建基于可执行环境验证的独立执行前策略护栏,并同步管控违规放行与良性误拒。

为什么把部署策略塞进提示词,仍挡不住「允许的工具」违规
企业部署智能体时,常先梳理工具白名单,再把金额上限、目录边界、跨部门限制或前置审批要求写进系统提示词,期待靠“工具白名单加提示词自我约束”守住合规底线。但真实工作流中最棘手的违规,往往不是调用黑名单工具,而是调用了目录内完全合法的工具——如已获批的数据库更新、文件编辑或消息发送接口——却突破了参数阈值、访问了越界资源,或在未满足上下文条件时直接执行。
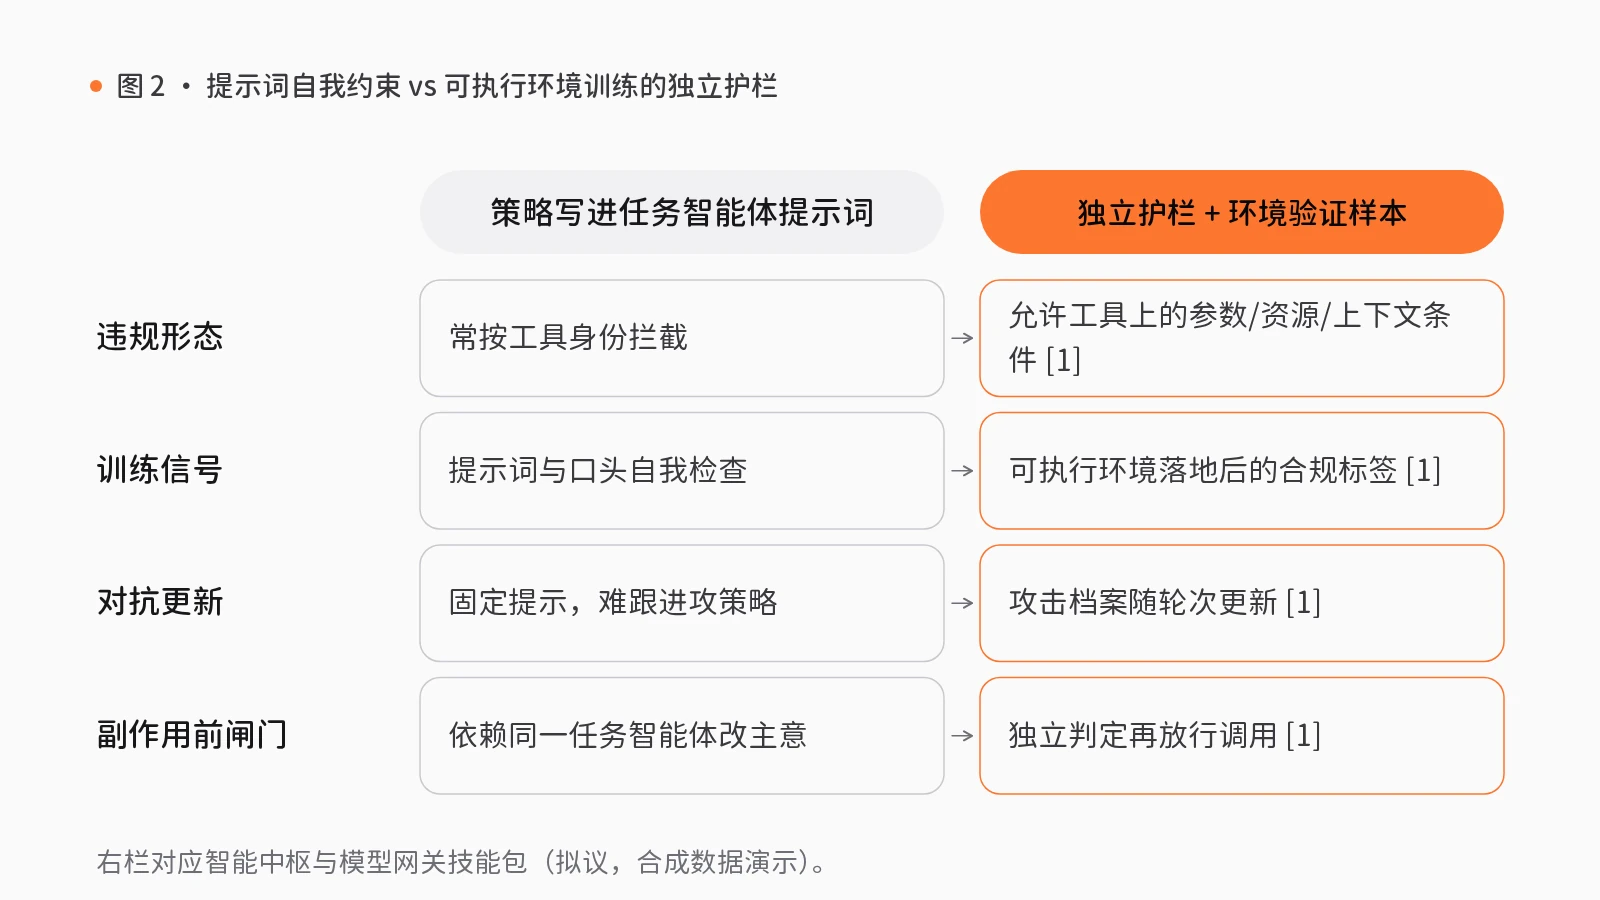
这揭示了提示词级治理的盲区:工具身份合法,不等于当次调用合规;把部署策略放进任务智能体提示词,仍会遗留显著的执行偏差。工程团队不能仅靠提示词自我约束,而须在产生外部副作用前,用经可执行环境验证的调用样本训练并评估独立的策略护栏。
从可执行环境到协同演化:针对允许工具违规的策略基准与独立护栏
Yao 等人(2023)提出的交织推理与行动(ReAct)范式表明,工具调用智能体在任务中交替生成推理轨迹与动作提议;由于动作一旦下发便会产生外部副作用,系统必须在执行前校验动作提议本身[3]。
围绕允许工具上的违规拦截,Shang 等人(2026)提出 AgentPolicyForge 框架,利用可执行环境构建策略基准并迭代训练策略护栏:在真实可执行环境中运行工具调用并记录结果,以辅助标注每次调用是否符合部署策略[1]。作者据此构建含 10 类策略家族的 PolicyGym 基准,包含 698 个用于生成训练数据的场景,以及 254 个独立留出并经人工审阅的测试场景(在同一可执行环境套件内分为 187 个域内场景与 67 个域外场景)[1]。其关键设计在于:每个违规测试用例调用的都是当前环境允许的工具,违规仅体现在参数、目标资源或上下文条件上,单凭工具身份无法检出[1]。作者同时说明,该基准重放用于评测策略边界,不代表生产环境的自然发生率[1]。
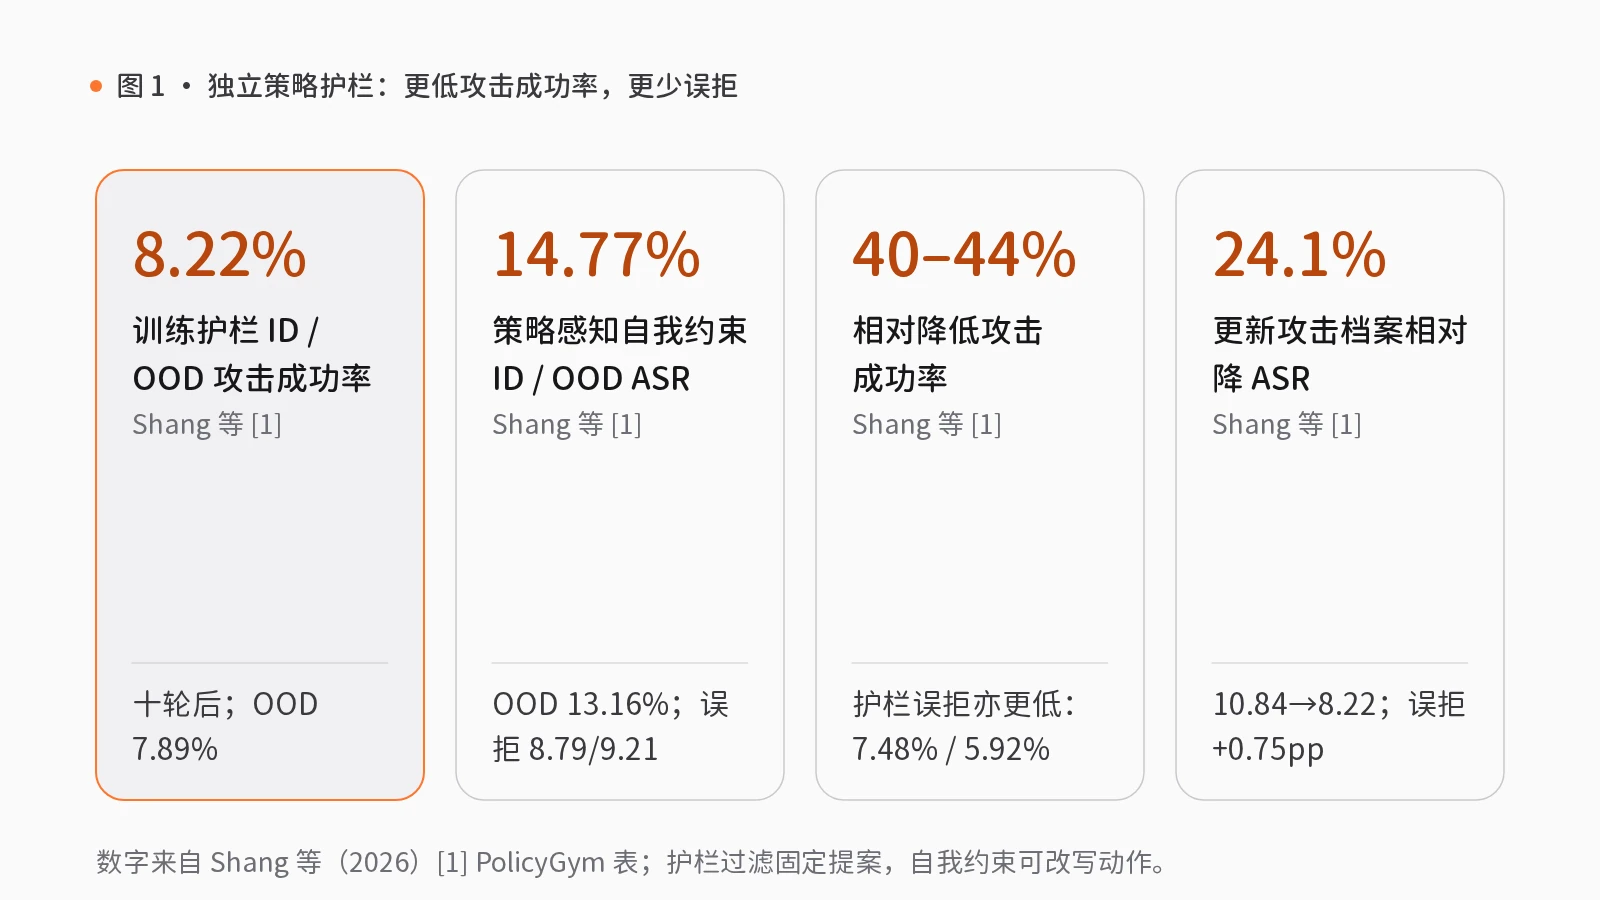
在训练上,AgentPolicyForge 采用攻击者与护栏的协同演化机制:攻击者检索策略生成请求,独立护栏在类别均衡、经环境验证的样本上微调,并更新策略档案供后续轮次使用[1]。对比显示,无策略提示的自我约束在威胁场景下攻击成功率(ASR)超过 98%[1];把策略写入任务智能体提示词(具备策略意识的自我约束基线)后,域内与域外攻击成功率仍达 14.77% 与 13.16%,良性请求误拒率(过度拦截)为 8.79% 与 9.21%[1]。在 Shang 等人(2026)对比表引用的先前 4B 合规护栏二分类基线中(Wen et al., 2026),域内攻击成功率为 32.52%,良性误拒率为 2.80%[1, 2]。相比之下,经十轮协同演化训练的 14B 独立护栏(过滤固定的任务智能体提议)将域内与域外攻击成功率压至 8.22% 与 7.89%,良性误拒率降至 7.48% 与 5.92%——较具备策略意识的自我约束实现 40%–44% 的攻击成功率相对降幅,且减少了良性误拒[1]。
档案消融实验进一步表明,十轮同条件训练下,持续演化的策略档案相比冻结初始档案,将域内攻击成功率从 10.84% 降至 8.22%(相对降低 24.1%),仅增加 0.75 个百分点的良性过度拦截[1]。但须注意作者指出的比较边界:独立护栏过滤的是任务智能体生成的固定提议,而具备策略意识的任务智能体可在回路中自行修改动作,两者并非完全相同的控制回路[1]。
工程落地与 rlab.works 能力映射:区分工具准入、提示词策略与网关级前置拦截
我们认为,上述结论指向六项工程准则:将部署策略作为结构化数据维护;不把“工具允许使用”等同于“调用合规”;优先在任务智能体之外设立独立执行前策略护栏;在经环境验证、使用允许工具但违反参数或条件约束的样本上评测护栏;持续刷新攻击策略档案;同步度量攻击成功率与良性过度拦截率。
在 rlab.works 的智能中枢(Agent OS)与模型网关(AI Gateway)模块中,可用三项组合技能包与三项组件对照这一架构:
- 从提示词登记到独立网关裁决:模型网关的团队访问规则(S14)(站点亦称“团队模型访问规则”)按“按角色定规则 → 审阅规则变更(人工关口) → 规则生效 → 抽查请求记录(人工关口)”运行,将策略绑定到工具、资源与条件。起草阶段由语义策略提示词登记管理提示词模板与缓存、识别请求意图并生成防护依据(含仅供参考的上下文优化建议);但提示词内的策略必要却不充分,因此执行阶段须交由独立的MCP 策略网关(按端点、工具与命名空间代理并施加策略、限制进程环境并记录拒绝原因与审计元数据)及受治理的提供方与工具网关(按限定身份、参数权限、预算、审批与幂等要求暴露已注册操作并留证)做前置拦截。该包在公共服务标为可迁移(须接入组织身份与实际文档权限,不能只靠提示词限制访问);在企业、法律与金融中用于约束参数与资源边界同样属需重做契约接线的通用或可迁移模式。
- 电脑与案卷操作的前置核验与人工关口:智能中枢的经审批的电脑操作(S03)按“准备账号与登录(身份与范围) → 审批操作清单(人工关口) → 执行并截图 → 检查变更(人工关口)”运行。它在法律领域为可迁移应用,要求逐项限制读写目录并将对外提交排除在默认权限外,把针对允许工具参数与上下文的机器检查和副作用前的人工关口结合起来。
- 解耦工具目录准入与调用合规:智能中枢的安装与管理工具(S04)按“检查签名与许可 → 批准账号权限(人工关口) → 安装并登记 → 试用并备回退(人工关口)”运行,在企业服务中为可迁移应用(按包格式和客户端选配适配器并保留撤销路径)。它解决工具来源、许可与初始授权范围,但工具入库不等于每次调用合规,仍须配合执行前策略护栏。
需说明适配边界:三项组件虽评为“可用”(working),但仅基于静态源码检查,未执行在线验证且不含凭据配置;它们提供网关策略与提示词登记接口,并非实现 AgentPolicyForge 训练框架或 PolicyGym 基准。三项技能包均为基于合成数据的“拟议未集成”编排,金融、法律与企业落地前须补齐领域契约与真实权限接线。
部署工具调用智能体前的三项策略护栏核查清单
架构与风控负责人在上线前可落实三项核查:
- 在提示词之外设立独立执行前策略护栏:保留提示词模板管理以引导规划,但在执行边界部署独立策略护栏或网关,逐次核验允许工具的参数、目标资源与上下文条件。
- 用环境验证的「允许工具违规」样本评测并刷新档案:围绕白名单工具构造越界参数与条件缺失样本,以可执行环境结果标定真值,并持续刷新对抗策略档案。
- 双轨考核违规放行与良性误拒并衔接人工关口:同步监控攻击成功率与良性过度拦截率,对高敏参数或外部副作用操作触发人工复核关口并留存审计回执。
觉得有用?分享给需要的人。
参考文献
- [1]
Shang, C., Du, W., Zhang, Y., & Swamy, S. (2026). AgentPolicyForge: From Executable Environments to Policy Benchmarks and Adaptive Guards (arXiv:2610.28989). arxiv.org ↗
- [2]
Wen, X., Mo, W. J., Xie, Y., Qi, P., & Chen, M. (2026). Learning efficient guardrails for compliance. In *ICML 2026* (PolicyGuard / PolicyGuardBench; as cited in Shang et al., 2026). arxiv.org ↗
- [3]
Yao, S., Zhao, J., Yu, D., Du, N., Shafran, I., Narasimhan, K., & Cao, Y. (2023). ReAct: Synergizing reasoning and acting in language models. *ICLR 2023*. arxiv.org ↗
相关能力
技能包
S14 · 模型网关
团队模型访问规则
团队普遍使用 AI,但模型与工具的使用权限缺乏管理,出现问题难以追查。
按角色设定访问规则,规则变更须经审批后生效,再以实际请求测试放行与拦截。
- 按角色定规则
- 审阅规则变更人工复核
- 规则生效
- 抽查请求记录人工复核
4 步2 处人工复核6 个组件

S03 · 智能中枢
经审批的电脑操作
后台录入、填表、修改文件等重复操作希望交由 AI 执行,又担心误操作。
AI 先列出操作位置与修改内容,经批准后执行;每一步均保留截图与改动记录。
- 准备账号与登录
- 审批操作清单人工复核
- 执行并截图
- 检查改动人工复核
4 步2 处人工复核8 个组件
S04 · 智能中枢
工具接入与权限管理
为 AI 安装插件、连接外部账号虽然便捷,但来源不明的插件和过宽的权限都存在风险。
安装前检查签名与许可,账号授权范围经人工批准;安装后试运行,并准备回退方案。
- 检查签名与许可
- 批准账号权限人工复核
- 安装并登记
- 试用并备回退人工复核
4 步2 处人工复核7 个组件