提示詞裏的策略不夠:可執行環境裏的策略護欄與「允許的工具」違規
將部署策略寫進任務智能體的提示詞,仍會遺留可觀的違規執行風險——尤其當違規調用使用的是白名單內允許的工具,僅在參數、目標資源或上下文條件上越界時,單憑工具身份無法識別違規。工程實踐需在提示詞之外構建基於可執行環境驗證的獨立執行前策略護欄,並同步管控違規放行與良性誤拒。

為什麼把部署策略塞進提示詞,仍擋不住「允許的工具」違規
企業部署智能體時,常先梳理工具白名單,再把金額上限、目錄邊界、跨部門限制或前置審批要求寫進系統提示詞,期待靠「工具白名單加提示詞自我約束」守住合規底線。但真實工作流中最棘手的違規,往往不是調用黑名單工具,而是調用了目錄內完全合法的工具——如已獲批的數據庫更新、文件編輯或消息發送接口——卻突破了參數閾值、訪問了越界資源,或在未滿足上下文條件時直接執行。
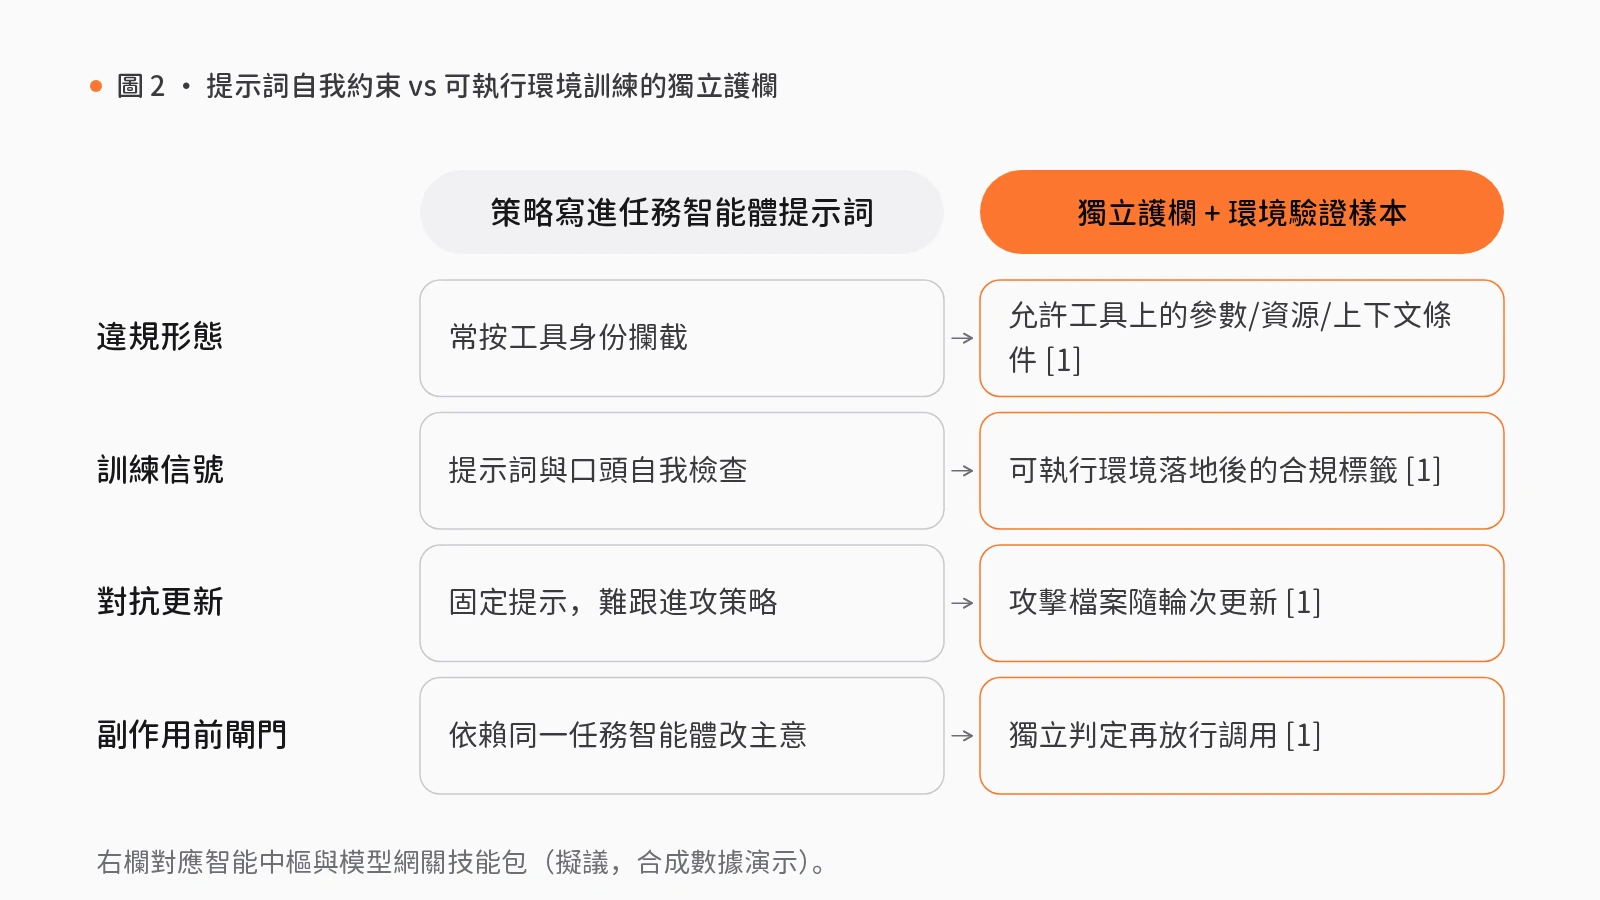
這揭示了提示詞級治理的盲區:工具身份合法,不等於當次調用合規;把部署策略放進任務智能體提示詞,仍會遺留顯著的執行偏差。工程團隊不能僅靠提示詞自我約束,而須在產生外部副作用前,用經可執行環境驗證的調用樣本訓練並評估獨立的策略護欄。
從可執行環境到協同演化:針對允許工具違規的策略基準與獨立護欄
Yao 等人(2023)提出的交織推理與行動(ReAct)範式表明,工具調用智能體在任務中交替生成推理軌跡與動作提議;由於動作一旦下發便會產生外部副作用,系統必須在執行前校驗動作提議本身[3]。
圍繞允許工具上的違規攔截,Shang 等人(2026)提出 AgentPolicyForge 框架,利用可執行環境構建策略基準並迭代訓練策略護欄:在真實可執行環境中運行工具調用並記錄結果,以輔助標註每次調用是否符合部署策略[1]。作者據此構建含 10 類策略家族的 PolicyGym 基準,包含 698 個用於生成訓練數據的場景,以及 254 個獨立留出並經人工審閲的測試場景(在同一可執行環境套件內分為 187 個域內場景與 67 個域外場景)[1]。其關鍵設計在於:每個違規測試用例調用的都是當前環境允許的工具,違規僅體現在參數、目標資源或上下文條件上,單憑工具身份無法檢出[1]。作者同時説明,該基準重放用於評測策略邊界,不代表生產環境的自然發生率[1]。
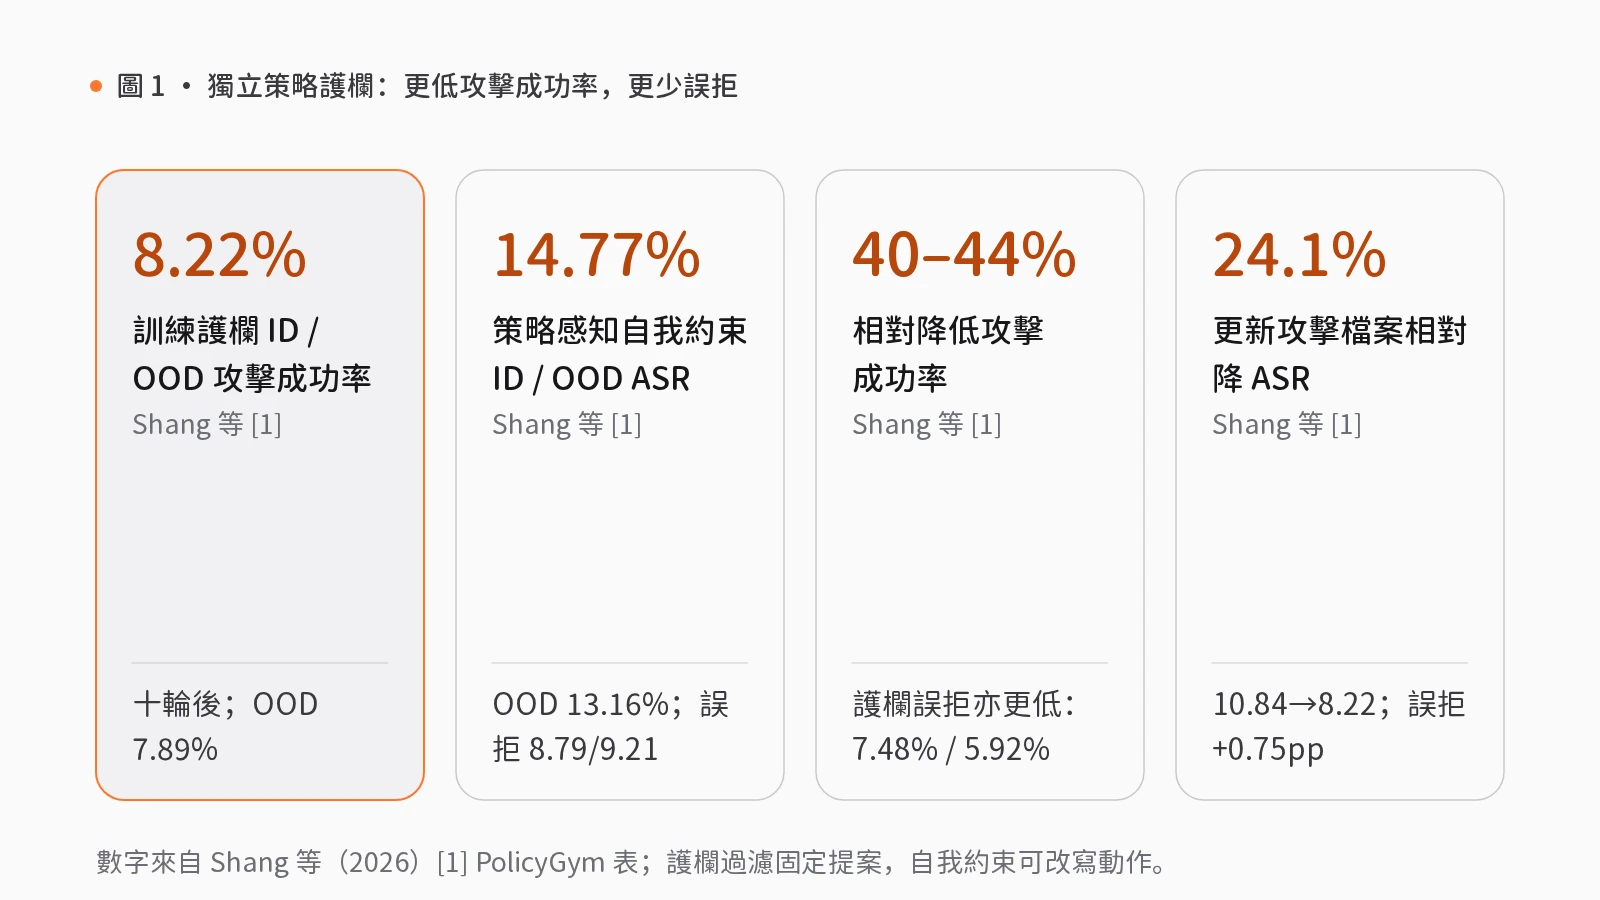
在訓練上,AgentPolicyForge 採用攻擊者與護欄的協同演化機制:攻擊者檢索策略生成請求,獨立護欄在類別均衡、經環境驗證的樣本上微調,並更新策略檔案供後續輪次使用[1]。對比顯示,無策略提示的自我約束在威脅場景下攻擊成功率(ASR)超過 98%[1];把策略寫入任務智能體提示詞(具備策略意識的自我約束基線)後,域內與域外攻擊成功率仍達 14.77% 與 13.16%,良性請求誤拒率(過度攔截)為 8.79% 與 9.21%[1]。在 Shang 等人(2026)對比表引用的先前 4B 合規護欄二分類基線中(Wen et al., 2026),域內攻擊成功率為 32.52%,良性誤拒率為 2.80%[1, 2]。相比之下,經十輪協同演化訓練的 14B 獨立護欄(過濾固定的任務智能體提議)將域內與域外攻擊成功率壓至 8.22% 與 7.89%,良性誤拒率降至 7.48% 與 5.92%——較具備策略意識的自我約束實現 40%–44% 的攻擊成功率相對降幅,且減少了良性誤拒[1]。
檔案消融實驗進一步表明,十輪同條件訓練下,持續演化的策略檔案相比凍結初始檔案,將域內攻擊成功率從 10.84% 降至 8.22%(相對降低 24.1%),僅增加 0.75 個百分點的良性過度攔截[1]。但須注意作者指出的比較邊界:獨立護欄過濾的是任務智能體生成的固定提議,而具備策略意識的任務智能體可在迴路中自行修改動作,兩者並非完全相同的控制迴路[1]。
工程落地與 rlab.works 能力映射:區分工具准入、提示詞策略與網關級前置攔截
我們認為,上述結論指向六項工程準則:將部署策略作為結構化數據維護;不把「工具允許使用」等同於「調用合規」;優先在任務智能體之外設立獨立執行前策略護欄;在經環境驗證、使用允許工具但違反參數或條件約束的樣本上評測護欄;持續刷新攻擊策略檔案;同步度量攻擊成功率與良性過度攔截率。
在 rlab.works 的智能中樞(Agent OS)與模型網關(AI Gateway)模組中,可用三項組合技能包與三項組件對照這一架構:
- 從提示詞登記到獨立網關裁決:模型網關的團隊訪問規則(S14)(站點亦稱「團隊模型訪問規則」)按「按角色定規則 → 審閲規則變更(人工關口) → 規則生效 → 抽查請求記錄(人工關口)」運行,將策略綁定到工具、資源與條件。起草階段由語義策略提示詞登記管理提示詞模板與緩存、識別請求意圖並生成防護依據(含僅供參考的上下文優化建議);但提示詞內的策略必要卻不充分,因此執行階段須交由獨立的MCP 策略網關(按端點、工具與命名空間代理並施加策略、限制進程環境並記錄拒絕原因與審計元數據)及受治理的提供方與工具網關(按限定身份、參數權限、預算、審批與冪等要求暴露已註冊操作並留證)做前置攔截。該包在公共服務標為可遷移(須接入組織身份與實際文檔權限,不能只靠提示詞限制訪問);在企業、法律與金融中用於約束參數與資源邊界同樣屬需重做契約接線的通用或可遷移模式。
- 電腦與案卷操作的前置核驗與人工關口:智能中樞的經審批的電腦操作(S03)按「準備帳戶與登入(身份與範圍) → 審批操作清單(人工關口) → 執行並截圖 → 檢查變更(人工關口)」運行。它在法律領域為可遷移應用,要求逐項限制讀寫目錄並將對外提交排除在預設權限外,把針對允許工具參數與上下文的機器檢查和副作用前的人工關口結合起來。
- 解耦工具目錄准入與調用合規:智能中樞的安裝與管理工具(S04)按「檢查簽名與許可 → 批准帳戶權限(人工關口) → 安裝並登記 → 試用並備回退(人工關口)」運行,在企業服務中為可遷移應用(按包格式和客戶端選配適配器並保留撤銷路徑)。它解決工具來源、許可與初始授權範圍,但工具入庫不等於每次調用合規,仍須配合執行前策略護欄。
需説明適配邊界:三項組件雖評為「可用」(working),但僅基於靜態源碼檢查,未執行在線驗證且不含憑據配置;它們提供網關策略與提示詞登記接口,並非實現 AgentPolicyForge 訓練框架或 PolicyGym 基準。三項技能包均為基於合成數據的「擬議未集成」編排,金融、法律與企業落地前須補齊領域契約與真實權限接線。
部署工具調用智能體前的三項策略護欄核查清單
架構與風控負責人在上線前可落實三項核查:
- 在提示詞之外設立獨立執行前策略護欄:保留提示詞模板管理以引導規劃,但在執行邊界部署獨立策略護欄或網關,逐次核驗允許工具的參數、目標資源與上下文條件。
- 用環境驗證的「允許工具違規」樣本評測並刷新檔案:圍繞白名單工具構造越界參數與條件缺失樣本,以可執行環境結果標定真值,並持續刷新對抗策略檔案。
- 雙軌考核違規放行與良性誤拒並銜接人工關口:同步監控攻擊成功率與良性過度攔截率,對高敏參數或外部副作用操作觸發人工複核關口並留存審計回執。
覺得有用?分享給需要的人。
參考文獻
- [1]
Shang, C., Du, W., Zhang, Y., & Swamy, S. (2026). AgentPolicyForge: From Executable Environments to Policy Benchmarks and Adaptive Guards (arXiv:2610.28989). arxiv.org ↗
- [2]
Wen, X., Mo, W. J., Xie, Y., Qi, P., & Chen, M. (2026). Learning efficient guardrails for compliance. In *ICML 2026* (PolicyGuard / PolicyGuardBench; as cited in Shang et al., 2026). arxiv.org ↗
- [3]
Yao, S., Zhao, J., Yu, D., Du, N., Shafran, I., Narasimhan, K., & Cao, Y. (2023). ReAct: Synergizing reasoning and acting in language models. *ICLR 2023*. arxiv.org ↗
相關能力
技能包
S14 · 模型網關
團隊模型訪問規則
團隊普遍使用 AI,但模型與工具的使用權限缺乏管理,出現問題難以追查。
按角色設定訪問規則,規則變更須經審批後生效,再以實際請求測試放行與攔截。
- 按角色定規則
- 審閲規則變更人工複核
- 規則生效
- 抽查請求記錄人工複核
4 步2 處人工複核6 個組件

S03 · 智能中樞
經審批的電腦操作
後台錄入、填表、修改文件等重複操作希望交由 AI 執行,又擔心誤操作。
AI 先列出操作位置與修改內容,經批准後執行;每一步均保留截圖與改動記錄。
- 準備帳戶與登入
- 審批操作清單人工複核
- 執行並截圖
- 檢查改動人工複核
4 步2 處人工複核8 個組件
S04 · 智能中樞
工具接入與權限管理
為 AI 安裝插件、連接外部帳戶雖然便捷,但來源不明的插件和過寬的權限都存在風險。
安裝前檢查簽名與許可,帳戶授權範圍經人工批准;安裝後試運行,並準備回退方案。
- 檢查簽名與許可
- 批准帳戶權限人工複核
- 安裝並登記
- 試用並備回退人工複核
4 步2 處人工複核7 個組件