【金融之一】研报洪流中的“原典锚定”:为什么投研备忘录不能自动越界为交易指令
投研的核心价值在于投资论点与原始披露之间可追溯的证据链;即便大模型能捕捉快讯情绪,开放式财务问答仍受困于检索漏损与幻觉,生成正反证据备忘与投委会决策、交易执行必须在架构上严格隔离。
快讯情绪评分与深度公告核验之间的鸿沟
设想一家资管机构的投研团队在财报季面临密集的定期报告与市场快讯。为了缓解阅读压力,团队尝试将公告与新闻流接入大模型生成投资摘要,甚至讨论把模型输出的看多或看空评分直接连入交易指令接口。但在内部复核中,研究员很快遇到瓶颈:模型固然能从新闻标题中提取短期情绪方向,可一旦投委会追问某项资本开支、表外负债或盈利指引在长篇年报中的具体出处,自动生成的段落往往缺失可核对的原始证据链,或把常规财务科目误判为负面信号。若未经核验的摘要直接触发下单,上游文本解析偏差就会转化为真实头寸风险。
这一困境揭示了金融投研智能化的核心原则:投研的价值在于论点与原始披露之间可追溯的证据链;生成正反证据备忘与投委会决策、交易执行必须在架构上严格隔离。
情绪预测力、金融语境错配与开放式财务问答的局限
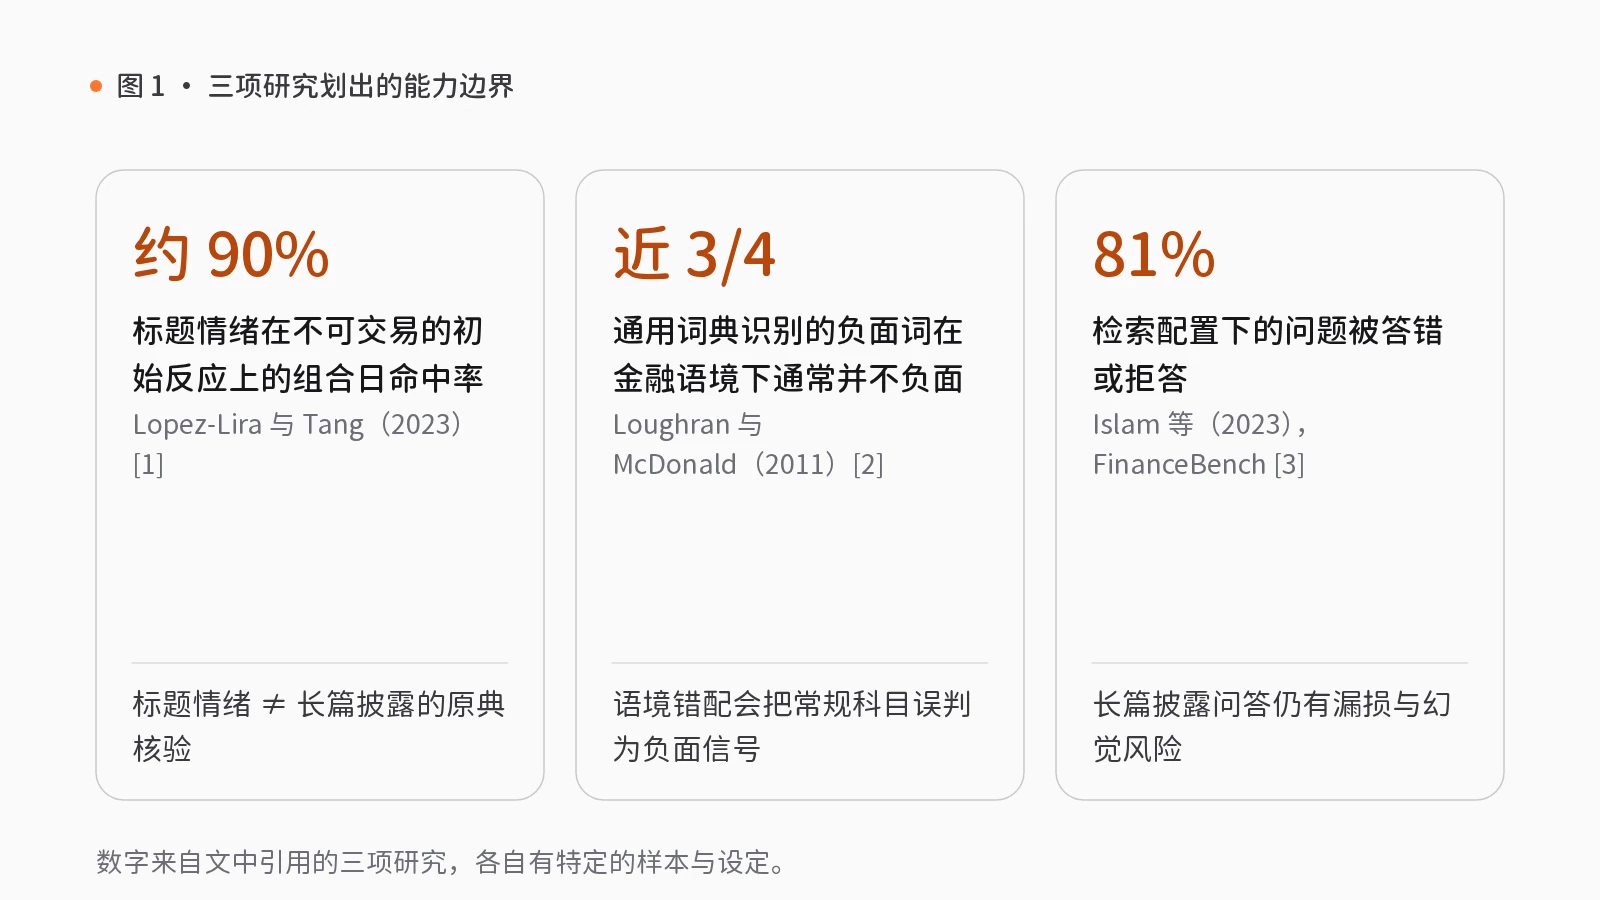
为何不能因为大模型具备市场情绪捕捉能力,就放任其越过人工复核直接驱动交易?金融文本分析与大模型评测研究界定了其中的能力边界与机制差异。
首先,大模型在处理新闻标题时的确展现出情绪归纳与收益预测能力。Lopez-Lira 与 Tang(2023)记录了大模型在未经直接金融训练的情况下,仅凭新闻标题预测股市反应的能力[1]。在使用知识截止日期之后的新闻标题测试时,受测前沿模型捕捉到了市场初始反应,在不可交易的初始反应上取得了约 90% 的组合日命中率[1];其情绪评分还能显著预测随后的价格漂移,在小盘股与负面新闻中尤为明显[1]。研究显示,预测能力总体随模型规模扩大而增强,表明金融推理是复杂大模型的涌现能力;随着大模型采纳率上升,策略收益呈下降趋势,与市场价格效率改善一致[1]。作者通过构建包含大模型技术、信息处理能力约束、反应不足与套利限制的理论模型解释了上述发现[1]。
但架构设计必须区分新闻标题情绪打分与深度披露原典核验。标题情绪捕捉的是市场对快讯的短期反应不足与漂移,而投研备忘录处理的是复杂的法定披露文件。Loughran 与 McDonald(2011)针对 10-K 年报的研究指出,早期研究常以负面词计数衡量语调,但为其他学科开发的词表在金融文本中会误判常见词汇[2]。在对 1994 年至 2008 年的大样本年报的分析中,一套广泛使用的通用学科词典识别出的负面词里,近四分之三在金融语境下通常并不负面[2](如负债在资产负债表中只是常规科目)。作者为此开发了替代性金融负面词表及其余五类专项词表以反映金融语调,并将词表与年报披露期收益、交易量、收益波动率、欺诈、重大内部控制缺陷及未预期盈余建立了关联[2]。
当通用大模型配合检索系统面对上市公司财务披露文档时,能否胜任精确问答与核验?Islam 等(2023)发布了评估大模型开卷金融问答表现的基准测试集 FinanceBench,包含关于上市公司的 10,231 个问题及对应答案与证据字符串[3]。这些问题具备生态效度、覆盖多样场景且明确直接,旨在作为最低表现标准[3]。研究团队在抽样的 150 个案例上测试了 16 种结合向量库或长上下文提示词的前沿模型配置,并人工审阅了 2,400 条回答,发现现有大模型存在明显局限:配合检索系统的前沿模型配置对 81% 的问题回答错误或拒绝回答[3]。虽用更长上下文窗口输入相关证据能改善表现,但因延迟增加且无法支持更大体量的金融文档,在企业环境中并不现实;所有受测模型均暴露出幻觉等弱点,限制了企业适用性[3]。
由此可见,大模型虽能辅助提炼文本信号,但在长篇披露的精确问答中仍存漏损与幻觉风险;投研系统的职责不是替基金经理下单,而是把披露原文、正反论据与人工复核组装成可追查的证据账本。
工程映射:从证据备忘录到跨周跟进的受控流水线
在 rlab.works 体系中,原典锚定与研究交易隔离被具象化为契约流程。在智能感知模块下,「正反证据备忘(S25)」技能包以研究对象、论点和已有证据为初始输入,分步推进:
- 收集证据(辅助):调用「信息披露采集与文本提取」,获取美股、A 股和港股公告元数据,从 JSON、HTML 和含文本层的 PDF 中清理出公告正文,产出带日期与出处的材料包。
- 梳理对象与关系(辅助):在统一标的代码与时间口径下整理实体关系与证据索引。
- 对照正反证据(辅助):借助「投资论点证据与结论跟踪」,校验跨多周的论点证据,为来源评级,区分支持、反对与复杂化因素,推导可人工覆盖的每周结论,产出支持、反对与不确定性记录。
- 定稿备忘(人工复核):由流程指定的复核人或提出请求的用户审阅证据链;通过后由「投资备忘录生成」基于市场与披露上下文及既有研究或回测产物,保存人工接受的研究备忘与证据链接;被拒绝的产出退回修订,不进入下一步。
「正反证据备忘(S25)」在金融行业标为源数据有行业依据:可把披露、市场序列和论点反证放进同一本研究备忘,方便复核每条判断的出处;但仍需统一实体与时间口径,且产物仅供研究,不生成交易指令。若迁往法律场景,则属可迁移应用,须将金融披露、行情和公司模型整体替换成案卷、法条、当事方与时间线,原评分不可移作法律判断。
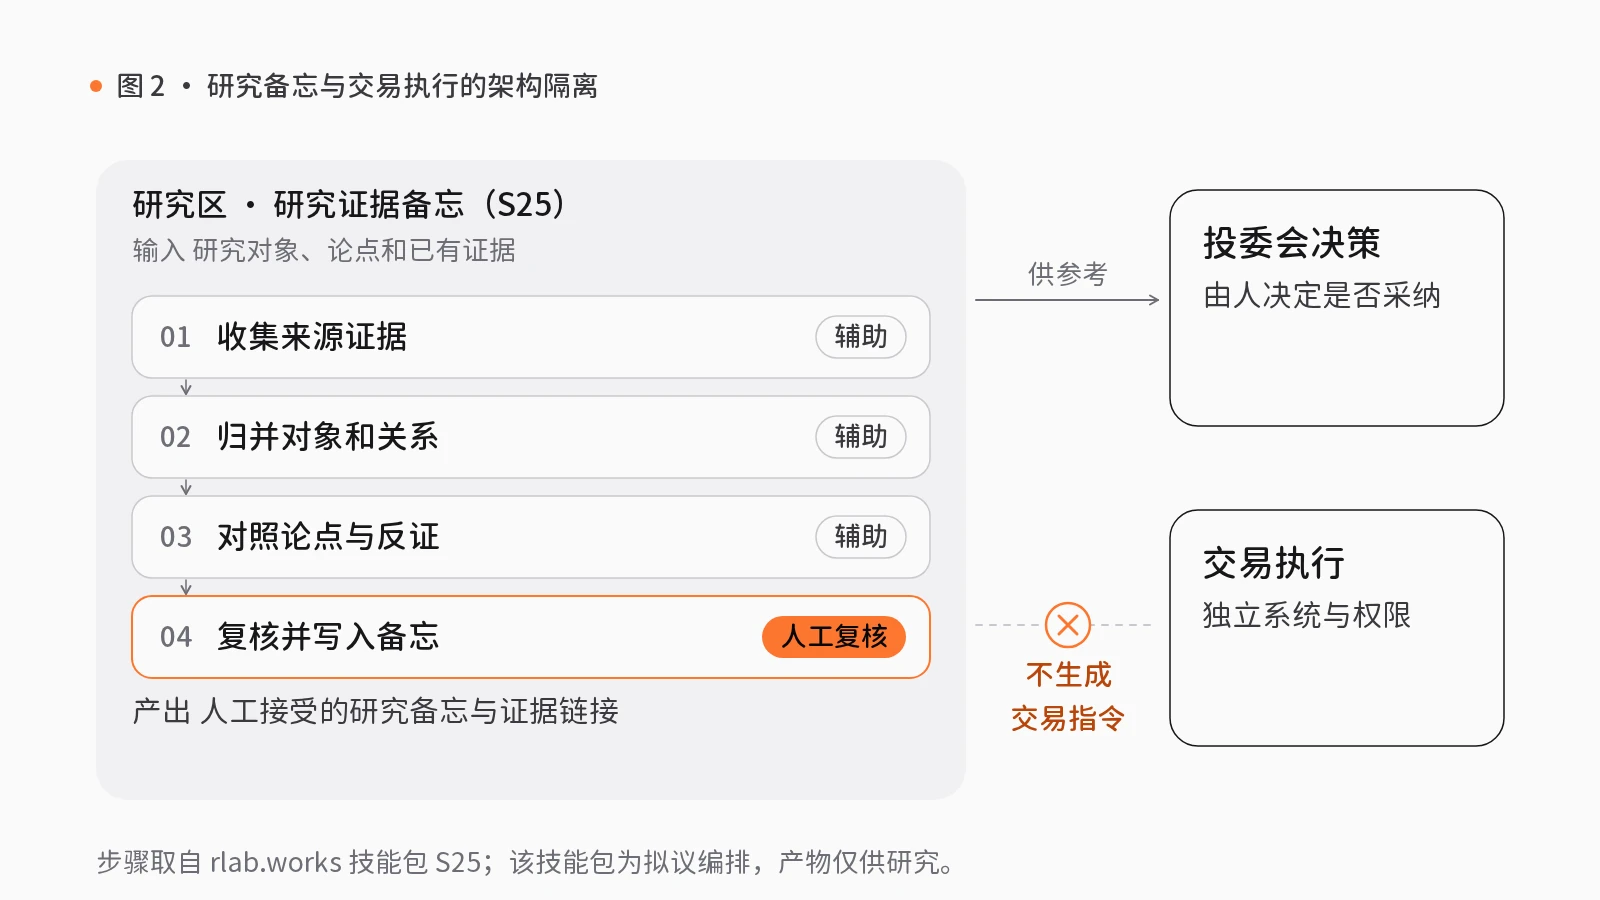
需如实说明边界:上述技能包均为拟议编排,仅含合成数据演示,尚未接入真实服务;所涉组件的可运行代码成熟度基于静态源码检查而非生产部署。源数据有行业依据仅表示源数据有显式行业关联,不代表客户部署或业务效果。
投研智能体试点前的管理检验清单
研究总监、风控官或技术负责人在资助试点前,可执行以下检验:
- 是否强制并列呈现支持证据、反证与原始出处? 要求备忘录同时保留支持、反对与不确定性记录,并锚定公告具体出处与日期,拒绝只给单向结论的摘要。
- 在检索补查与备忘归档处是否设有阻断式人工关口? 确认未经复核人接受的草稿与补查计划会退回修订,不得写入研究库或流入投委会材料。
- 研究备忘与交易执行接口是否实现了架构隔离? 确认智能体输出止步于研究备忘录,严禁模型评分或摘要跨越投委会决策直接触发交易指令。
觉得有用?分享给需要的人。
参考文献
- [1]
Lopez-Lira, A., & Tang, Y. (2023). Can ChatGPT Forecast Stock Price Movements? Return Predictability and Large Language Models (SSRN Working Paper No. 4412788). doi.org/10.2139/ssrn.4412788
- [2]
Loughran, T., & McDonald, B. (2011). When Is a Liability Not a Liability? Textual Analysis, Dictionaries, and 10-Ks. The Journal of Finance, 66(1), 35–65. doi.org/10.1111/j.1540-6261.2010.01625.x
- [3]
Islam, P., Kannappan, A., Kiela, D., Qian, R., Scherrer, N., & Vidgen, B. (2023). FinanceBench: A New Benchmark for Financial Question Answering (arXiv:2311.11944). arxiv.org ↗